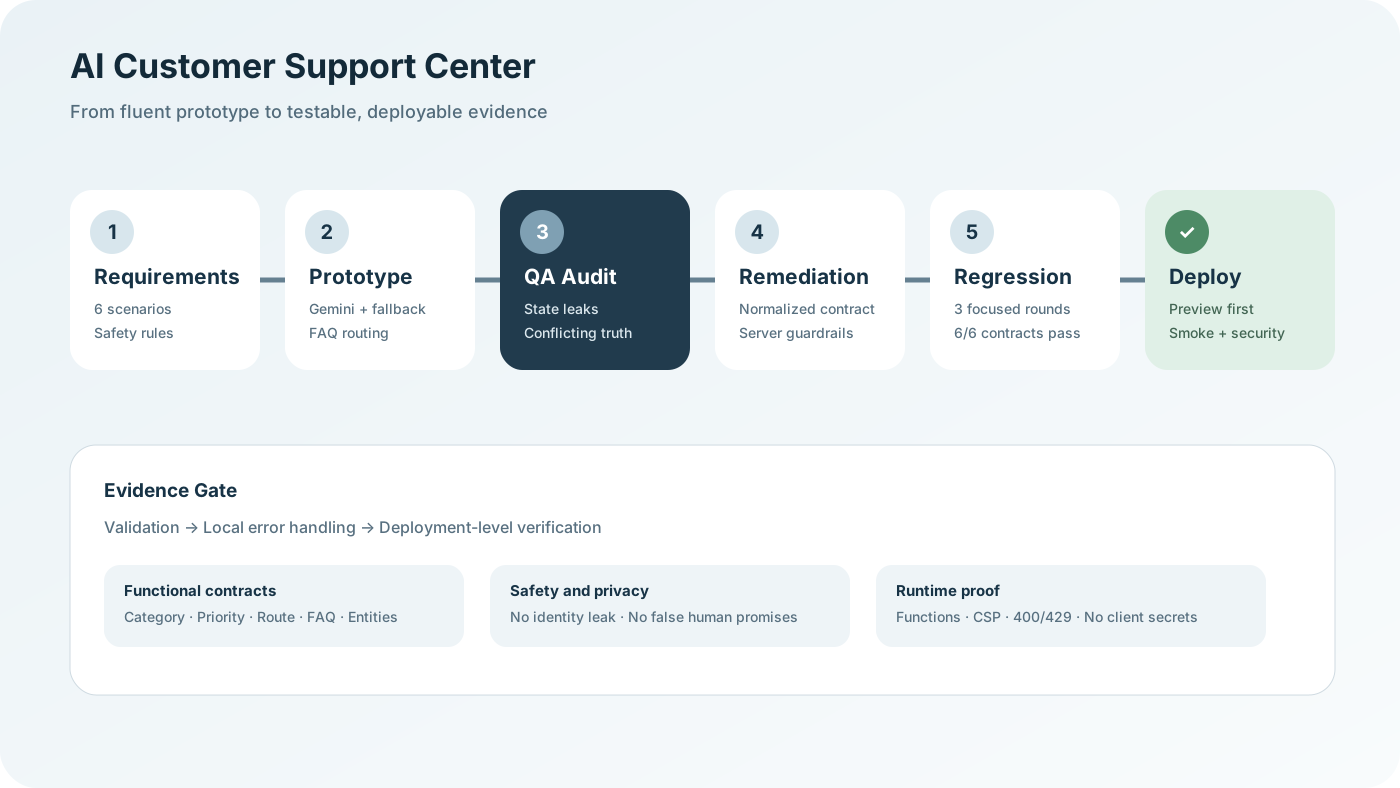
1. Was entwickelt wurde
Der Prototyp bildet ein KI-gestütztes Support-Center mit sechs vordefinierten Kundenszenarien und einem freien Testing Playground ab. Er klassifiziert eine Anfrage, bestimmt Kategorie und Priorität, extrahiert Entitäten, sucht eine verifizierte FAQ, erzeugt eine Antwort und entscheidet zwischen automatisierter Hilfe und einer simulierten Human Queue.
Der Browser-Client basiert auf React und Vite. Das öffentliche Deployment nutzt Netlify Functions für den Analyse-Endpunkt. Gemini kann die Klassifizierung unterstützen; ein deterministischer Mechanismus dient als transparenter Fallback. Beide Pfade müssen dasselbe normalisierte Antwortschema liefern. Demo-Tickets und FAQ-Änderungen bleiben im Browser und werden nach 24 Stunden automatisch gelöscht.
2. Das eigentliche Testproblem: ein Testorakel definieren
Flüssig formulierter Text ist kein Pass-Kriterium. Deshalb erhielt jedes geführte Szenario einen expliziten Vertrag: erwartete Kategorie, Priorität, Route, FAQ-ID, notwendige und verbotene Entitäten. So wird eine offene KI-Ausgabe testbar, ohne vorzutäuschen, dass jede freie Kundenanfrage nur eine perfekte Antwort besitzt.
Die risikobasierte Abdeckung konzentrierte sich auf Zustandsisolation, widersprüchliche Wahrheitsquellen, Low-Confidence-Entscheidungen, Safety-Wording, Entitätssemantik, Grenzwerte, Dashboard-Metriken und Deployment-Aussagen.
3. Ergebnisse des ersten Audits
| Befund | Risiko | Erststatus |
|---|---|---|
| Sarah wurde als „Marcus“, Elena als „Robert“ angesprochen | Zustandsvermischung zwischen Anfragen verletzt Vertrauen und Datenschutz. | Major |
| Szenariokarte zeigte Automated FAQ, Runtime nutzte Human Queue | Zwei Wahrheitsquellen erzeugten widersprüchliches Verhalten. | Major |
| Niedriger FAQ-Match zeigte gleichzeitig automatische und menschliche Route | Die tatsächlich gewählte Entscheidung blieb unklar. | Major |
| Simulation versprach einen Anruf durch einen Manager | Eine nicht mögliche reale Handlung wurde suggeriert. | Major |
| Express-API wurde als Netlify-ready beschrieben | Ein statisches Deployment hostet den Backend-Endpunkt nicht automatisch. | Major |
| KPI und Statusfilter nutzten verschiedene Eskalationslogik | Übersicht und Detaildaten waren nicht nachvollziehbar. | Minor |
Negative Tests umfassten leere Eingaben, Leerzeichen, HTML/XSS-ähnliche Zeichenfolgen, geringe FAQ-Relevanz und überlange Transkripte. Die getestete XSS-ähnliche Eingabe wurde als Text dargestellt; dieser einzelne Test wurde nicht als vollständiger Security-Nachweis ausgegeben.
4. Wie das System korrigiert wurde
- Die Kundenidentität wird an die aktive Anfrage gebunden; Namen aus früheren Vorgängen sind in Prompt und normalisierter Antwort verboten.
- Ein normalisiertes Decision Object steuert UI-Badges, Routing, FAQ-Erklärung und Ticketerstellung.
- Alle sechs geführten Szenarien erhielten automatisierte Verträge statt einzelner Hardcode-Korrekturen.
- Entitätsregeln trennen Auftrags- und Rechnungsnummern von SKU-Produkten und blenden fehlende Werte aus.
- UI und Function begrenzen Eingaben auf 4.000 Zeichen und liefern bei Überschreitung eine klare 400-Antwort.
- Eskalationstexte bleiben hypothetisch und sind sichtbar als Simulation gekennzeichnet.
- Netlify Functions, Redirects, Request-Validierung, Rate Limiting, deterministischer Fallback und serverseitige Gemini-Credentials ergänzen den Express-Pfad.
- Browserdaten verfallen nach 24 Stunden und können zusätzlich über Reset Demo gelöscht werden.
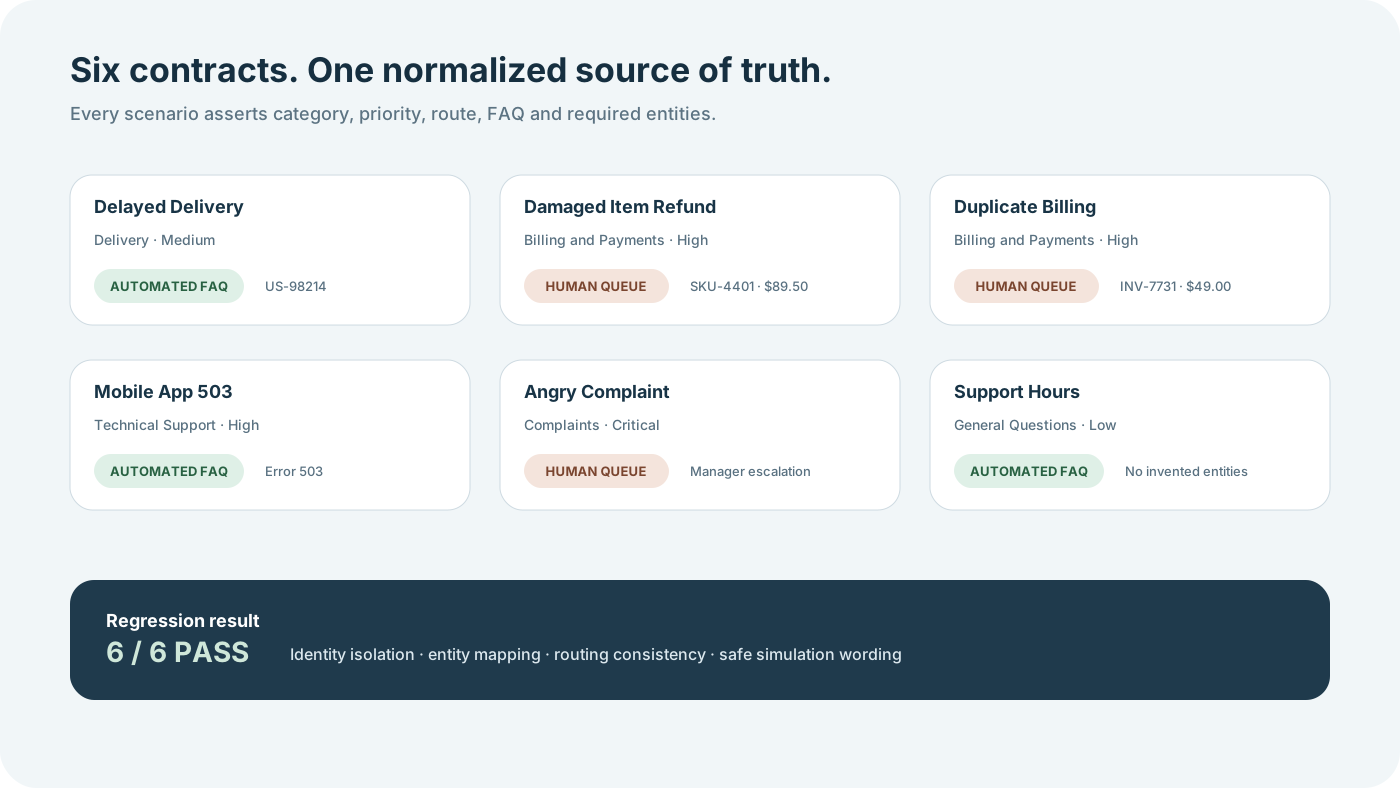
5. Regression war eine eigene Produktphase
Die erste Regression bestätigte mehrere Korrekturen, öffnete aber Delivery Routing erneut und fand fehlende Order-Extraktion, rohe null-Werte, einen Fehler bei 4.001 Zeichen, eine ungenaue localStorage-Aussage und ein Badge-Mismatch. Runde zwei schloss den Großteil dieser Punkte, entdeckte jedoch eine neue Regression: Der Refund-Fall wechselte von Billing and Payments zu Delivery und die SKU erschien als Bestellnummer.
Die dritte Runde prüfte die korrigierten Verträge erneut. Alle sechs bestanden. Diese Chronologie bleibt sichtbar: Der ursprüngliche Auditbericht wird nicht durch ein späteres PASS überschrieben.
| Szenario | Erwarteter Vertrag | Ergebnis |
|---|---|---|
| Delayed Delivery | Delivery · Medium · Automated FAQ · US-98214 | PASS |
| Damaged Item Refund | Billing and Payments · High · Human Queue · SKU-4401 · $89.50 | PASS |
| Duplicate Billing | Billing and Payments · High · Human Queue · INV-7731 · $49.00 | PASS |
| Mobile App 503 | Technical Support · High · automatisches Troubleshooting | PASS |
| Angry Complaint | Complaints · Critical · Human Queue · Manager Escalation | PASS |
| Support Hours | General Questions · Low · Automated FAQ · keine erfundenen Entitäten | PASS |
6. Deployment gehört zur Qualitätssicherung
Ein erfolgreicher AI-Studio-Preview beweist keinen Netlify-Build. Das Release Gate prüft deshalb echte Function-Routen, Gemini-Erfolg und deterministischen Fallback, HTTP 400/429, CSP und Security Headers, das Fehlen von Secrets im Client, Datenablauf sowie Desktop- und Mobile-Darstellung.
Der Gemini-Key wird ausschließlich in der serverlosen Function gelesen. Der Browser erhält ihn nie. Wildcard-CORS ist nicht aktiviert, weil Anwendung und API denselben Origin verwenden.
7. Was die Demo nicht behauptet
- Sie ist kein echter Kundendienst und kontaktiert keine Mitarbeiter oder verarbeitet Rückzahlungen.
- Das In-Memory-Limit eignet sich nur für eine kleine Lern-Demo, nicht für einen verteilten Produktionsdienst.
- Start und Stopp des Mikrofons wurden getestet; Speech-to-Text-Genauigkeit wurde nicht mit einem kontrollierten Audiokorpus zertifiziert.
- Geführte Verträge stabilisieren die Demo; freie Eingaben bleiben bewusst Gegenstand der Bewertung.
8. Wiederverwendbare Erkenntnisse für AI Testing
- Dasselbe Szenario nach jedem anderen ausführen, um veralteten Kontext zu finden.
- Widersprüche zwischen Feldern prüfen, nicht nur einzelne plausible Werte.
- Modellentscheidung von deterministischen Business- und Safety-Regeln trennen.
- Safety-Texte, Persistenz- und Deployment-Aussagen als testbares Verhalten behandeln.
- Ursprüngliche Fehler und spätere Regressionsergebnisse getrennt bewahren.
Die kontrollierte Demo ausprobieren
Fiktive Daten verwenden und normalisierte Entscheidung, FAQ, Entitäten, Route und Execution Engine beobachten.
AI Customer Support Center öffnen ↗
Kommentar hinterlassen
Teile deine Gedanken zur Fallstudie. Kein Konto erforderlich.
Kommentare
Kommentare werden geladen…