Успішне проходження конвеєра CI — корисний доказ. Але воно не доводить, що продукт із підтримкою ШІ є безпечним, корисним або готовим до кожної ситуації, у якій ним користуватимуться люди.
Ця відмінність має значення, оскільки поведінка ШІ залежить від даних, промптів, контексту, отриманого під час пошуку, версій моделі, дозволів і робочого процесу, у якому працює система. Детермінований API може повертати той самий результат для тих самих вхідних даних. Функція на основі моделі може давати кілька правдоподібних результатів, давати збій лише для певної групи користувачів або ставати менш надійною після зміни джерела знань.
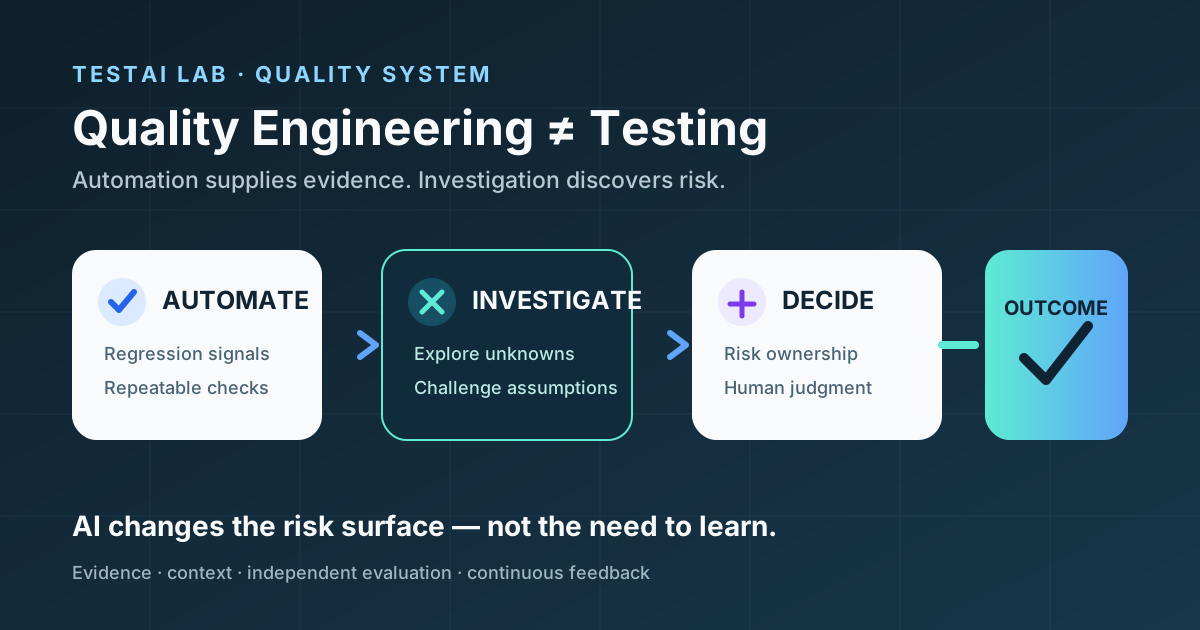
Інженерія якості дає командам змогу керувати цією ширшою системою. Вона не замінює тестування і не є модною назвою для автоматизації тестування. Вона поєднує вимоги, проєктування, тестування, спостережуваність, безпеку, експлуатацію та продуктові рішення, щоб ризики виявляли, а на них реагували протягом усього життєвого циклу.
Тестування, автоматизація та інженерія якості
Ці три види діяльності підтримують один одного, але відповідають на різні запитання.
- Тестування досліджує. Тестувальник проєктує експерименти, ставить під сумнів припущення, досліджує неочікувану поведінку та з’ясовує, що створює ризики для цінності продукту.
- Автоматизація тестування регулярно перевіряє відомі очікування. Вона добре підходить для перевірки контрактів, сигналів регресії, даних, дозволів, порогів затримки та інших умов, які можна чітко сформулювати.
- Інженерія якості координує систему роботи. Вона допомагає команді визначити, які ризики мають значення, які докази потрібні, хто відповідає за рішення і як зворотний зв’язок із робочого середовища впливає на подальшу роботу.
Отже, автоматизація створює докази, але не інтерпретує всі їхні наслідки. Інформаційна панель може показувати 92-відсотковий рівень успішного виконання завдань. Людина все одно має запитати, чи репрезентує набір даних реальних користувачів, чи містить решта 8% серйозні збої та чи вимірює метрика фактичну бізнес-вимогу.
NIST AI Risk Management Framework розглядає управління ризиками ШІ як діяльність протягом усього життєвого циклу, організовану навколо чотирьох функцій: Govern, Map, Measure і Manage — управління, визначення контексту, вимірювання та реагування на ризики. Ресурси NIST наголошують на тестуванні, оцінюванні, верифікації та валідації (TEVV), контексті, документації та безперервному оцінюванні. Звідси випливає практичний висновок: оцінювання — це не одноразовий фінальний шлюз, що належить лише QA. Це спільна й регулярна діяльність.
Операційна модель із п’яти рівнів
Невелика команда може використовувати п’ять рівнів без створення громіздкого процесу.
- Вимоги та картування ризиків. Опишіть цільових користувачів, дозволені дії, заборонені результати, межі використання даних і наслідки збоїв. Пов’яжіть кожен важливий ризик із відповідальною особою та спостережуваним сигналом.
- Детерміновані перевірки програмного забезпечення. Тестуйте API, схеми, правила доступу, інтеграції, повторні спроби, тайм-аути, журналювання та поведінку резервних механізмів. Ці перевірки мають бути відтворюваними й придатними для CI.
- Оцінювання ШІ та невизначеності. Оцінюйте репрезентативні завдання, обґрунтованість відповідей, якість пошуку, поведінку відмови від відповіді, стійкість і релевантні властивості справедливості чи безпеки. Фіксуйте набори даних, промпти, версії моделей, пороги та відомі обмеження.
- Дослідницьке та соціотехнічне тестування. Дайте тестувальникам, експертам із предметної області, фахівцям із безпеки та репрезентативним користувачам змогу досліджувати неоднозначні сценарії. З’ясовуйте, як люди інтерпретують результати та як ШІ поводиться в реальному робочому процесі.
- Моніторинг робочого середовища та зворотний зв’язок. Відстежуйте затримки, помилки, дрейф пошуку, відмови через брак дозволів, ескалації, виправлення користувачів та інциденти. Повертайте отримані знання до карти ризиків і наборів регресійних тестів.
Ці рівні не утворюють каскадної моделі. Проблема, виявлена в робочому середовищі, може змінити вимогу. Дослідницька сесія може виявити потребу в новій детермінованій перевірці. Оновлення моделі може вимагати нового оцінювання, навіть якщо код застосунку не змінився.
Приклад: асистент підтримки на основі ШІ
Уявіть асистента підтримки, який знаходить інформацію у внутрішній базі знань і може підготувати ескалацію для співробітника служби підтримки. Модульні тести проходять, контракти API чинні, а набір даних для оцінювання показує добру релевантність відповідей. Проте реліз усе одно може мати серйозні недоліки.
- Неоднозначність вимог: «Швидко вирішувати запити» не визначає, коли асистент має зупинитися й передати звернення фахівцю.
- Дрейф пошуку: зміна індексації піднімає застарілі політики вище за актуальні в результатах пошуку.
- Порушення контролю доступу: відповідь, що виглядає правильною, містить інформацію, до якої поточний користувач не повинен мати доступу.
- Небезпечна ескалація: асистент створює або спрямовує заявку без підтвердження, якого вимагає бізнес-процес.
- Стрибки затримки та вартості: довгі ланцюжки пошуку працюють у невеликому тестовому середовищі, але не витримують реального трафіку.
- Шкода користувачеві: переконливе формулювання спонукає користувача довіряти відповіді за межами затвердженої сфери застосування асистента.
Розширення автоматизації допомагає знизити деякі з цих ризиків. Матриці дозволів, набори регресійних тестів пошуку, навантажувальні тести та перевірки журналу аудиту варто автоматизувати. Але сама автоматизація не може визначити, чи відповідає «швидко» намірам зацікавленої сторони, чи доречна відмова в певному контексті та чи створює правдоподібна відповідь неприйнятну шкоду.
Саме тут дослідницьке тестування та експертне судження в предметній області залишаються необхідними.
Відповідальність без суперечок про назви посад
Точні назви посад менш важливі, ніж чітко визначена відповідальність.
- Команда продукту відповідає за цільову цінність, критерії прийняття та пріоритети ризиків.
- Інженерна команда відповідає за якість реалізації, детерміновані механізми контролю та можливість діагностувати збої.
- Фахівці з ШІ або даних відповідають за документацію моделей і наборів даних, проєктування оцінювання та звітність щодо невизначеності.
- QA відповідає за стратегію дослідження, ризики тестованості, прогалини в доказах і незалежну критичну оцінку.
- Команда безпеки відповідає за аналіз загроз, сценарії зловживань, межі доступу та роботу із секретами.
- Команда експлуатації відповідає за моніторинг, сигнали про інциденти, готовність до відкату та зворотний зв’язок із робочого середовища.
- Представники предметної області та користувачів допомагають оцінити, чи є поведінка корисною, безпечною та зрозумілою.
Твердження «якість — відповідальність кожного» набуває змісту лише тоді, коли за кожне рішення й кожен доказ відповідає конкретна особа.
Перелік доказів для релізу
Перед релізом запросіть докази, що відповідають фактичним ризикам продукту. Практичний перелік перевірок:
- Важливі вимоги та заборонені результати сформульовано у формі, придатній для перевірки.
- Для ризиків із серйозними наслідками визначено відповідальних осіб, заходи контролю та спостережувані сигнали про збій.
- Детерміновані перевірки охоплюють інтерфейси, дозволи, оброблення помилок і резервні шляхи.
- В оцінюваннях ШІ зафіксовано набір даних, промпти, версію моделі, метрики, пороги та обмеження.
- Незалежна від реалізації особа поставила під сумнів найважливіші припущення.
- Дослідницьке тестування охоплює неоднозначні, змагальні та реалістичні наскрізні сценарії.
- Моніторинг робочого середовища може виявляти регресії, які могли залишитися непоміченими під час дорелізного тестування.
- Команда має критерії відкату, вимкнення функції та реагування на інциденти.
Цей перелік не є універсальною сертифікацією. Обсяг доказів має відповідати контексту. Допоміжний засіб для написання текстів із низьким рівнем впливу та асистент, здатний розкривати конфіденційну інформацію, потребують різної глибини перевірки, різного складу рецензентів і різних порогів.
Поширені антипатерни
Звертайте увагу на такі попереджувальні ознаки:
- Використання успішного CI як аргументу на користь релізу без обговорення непокритих ризиків.
- Використання одного показника точності як вичерпної міри надійності.
- Використання набору даних для розробки також як єдиного набору для оцінювання.
- Тестування моделі без урахування пошуку, дозволів, інтерфейсу користувача та подальших дій.
- Одноразове оцінювання без повторення після змін моделі, промпту, даних або політики.
- Збирання метрик робочого середовища без відповідальної особи або порогового значення для реагування.
- Називання кожної автоматизованої перевірки «тестуванням» без часу на дослідження.
Ці антипатерни створюють видимість діяльності без надійного навчання.
План упровадження на один тиждень
Команда може почати без реорганізації компанії.
- У перший день оберіть одну функцію з підтримкою ШІ та запишіть її призначення, заборонені способи використання й п’ять найбільших ризиків.
- На другий день зіставте наявні автоматизовані перевірки з ризиками та визначте, для яких ризиків немає доказів.
- На третій день додайте одну детерміновану перевірку для найважливішого непокритого технічного ризику.
- На четвертий день створіть невеликий версійований набір даних для оцінювання та зафіксуйте модель і конфігурацію промптів.
- На п’ятий день проведіть цілеспрямовану дослідницьку сесію за участю QA та експерта з предметної області.
- На шостий день у безпечному середовищі перевірте, хто відповідає за моніторинг, відкат і реагування на інциденти.
- На сьомий день разом із командами продукту та розробки перегляньте докази, невирішені ризики й подальші дії.
Мета — не створити ідеальний фреймворк за сім днів, а налагодити прозорий цикл зворотного зв’язку, у якому докази впливають на рішення.
Висновок
ШІ не робить дисципліноване тестування застарілим. Натомість через нього межа між повторюваною перевіркою та людським дослідженням стає ще важливішою.
Автоматизуйте стабільні очікування. Оцінюйте поведінку моделі в задокументованому контексті. Досліджуйте те, чого команда ще не розуміє. Відстежуйте роботу реальної системи. Потім використовуйте інженерію якості, щоб пов’язати ці сигнали з відповідальними рішеннями.
Саме так команда переходить від твердження «CI-конвеєр успішно пройшов» до обґрунтованішого: «ми розуміємо важливі ризики, маємо релевантні докази й знаємо, що робитимемо, коли ці докази зміняться».
Залишити коментар
Поділіться думкою про статтю. Реєстрація не потрібна.
Коментарі
Завантаження коментарів…