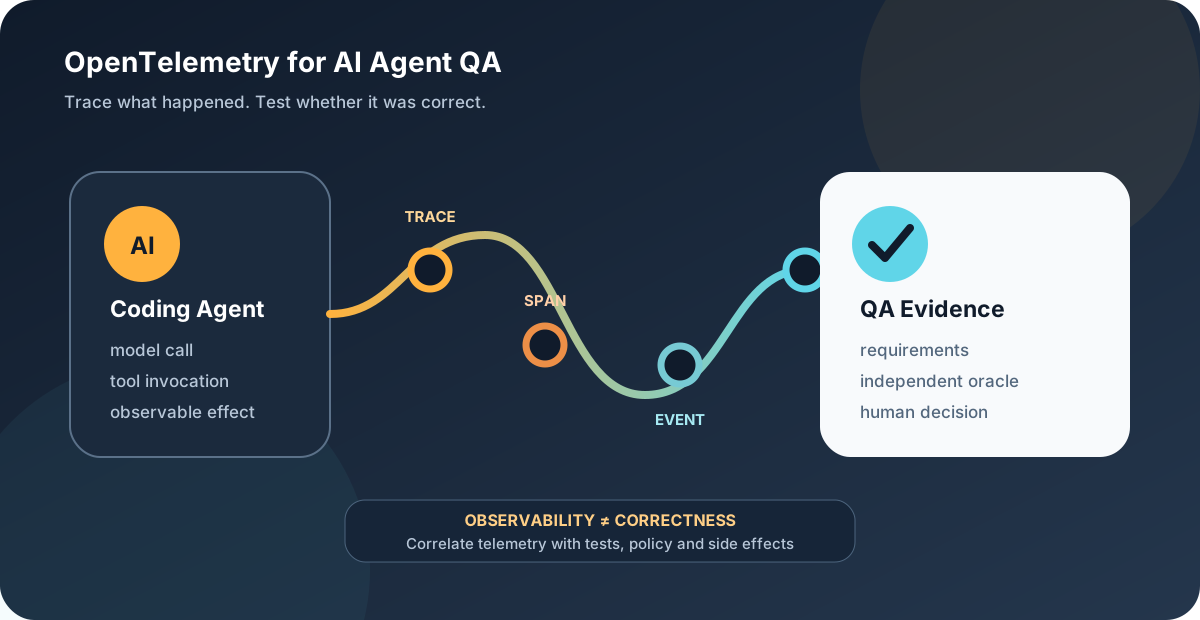
OpenTelemetry робить роботу агента спостережуваною. Для QA це корисно, оскільки трасування показує, які звернення до моделі та інструментів відбулися під час сесії. Але воно не доводить, що створений код функціонально правильний, безпечний і повністю відповідає вимогам. Це додаткове джерело доказів, яке потрібно пов’язувати з вимогами, результатами тестів і реальними побічними ефектами.
GitHub підтримує OpenTelemetry для застосунку GitHub Copilot через централізовано керовані налаштування підприємства. Згідно з офіційною документацією, трасування може відображати звернення до моделей та інструментів, метрики — містити числові дані, зокрема кількість токенів, а події — описувати зворотний зв’язок щодо змін. Вміст промптів, відповідей і аргументів інструментів за замовчуванням не включається. Для безпечної QA-стратегії це принципова межа.
1. Які дані надає OpenTelemetry
OpenTelemetry використовує кілька типів сигналів. Трасування описує шлях одного запиту через систему. Спан представляє обмежену в часі операцію всередині цього шляху. Атрибути додають структурований контекст, події позначають важливі моменти, а статус може повідомляти про помилку. Метрики агрегують числові значення для аналізу динаміки.
| Сигнал | Значення в сесії агента | Користь для QA |
|---|---|---|
| Трасування | Пов’язаний шлях запиту користувача | Об’єднує спостереження з конкретним тестовим запуском |
| Спан | Окрема операція, наприклад виклик моделі або інструмента | Дає змогу перевіряти наявність, порядок і тривалість кроку |
| Атрибут | Структурований контекст спана | Підтримує правила для моделі, інструмента та сесії |
| Подія | Часова позначка з додатковою інформацією | Надає контекст помилки або результату зміни |
| Метрика | Агреговане числове значення | Показує тенденції використання, помилок і затримок |
Конкретні назви спанів та атрибутів залежать від інструментування і вибраного сховища. Команда не повинна сприймати приклади назв полів як гарантований контракт GitHub. Перед автоматизацією перевірок слід зафіксувати фактично експортовану схему та її версію.
2. Спостережуваність не дорівнює коректності
Навіть повністю успішне трасування може супроводжувати неправильний код. Агент здатний використати дозволену модель та очікувані інструменти, але неправильно зрозуміти бізнес-вимогу. І навпаки, відсутній спан може бути наслідком семплінгу, збою експорту або зміни інструментування, а не дефектом продукту.
Надійна оцінка поєднує три рівні доказів:
- Докази продукту: модульні, інтеграційні, контрактні, security- та дослідницькі тести оцінюють результат.
- Докази процесу: телеметрія показує спостережувані кроки, інструменти та помилки.
- Докази керування: політики, права, строки зберігання та рішення відповідальних людей показують, хто керує ризиком.
Телеметрія стає незалежним каналом спостереження, але не замінює тестовий оракул.
3. Від вимог до телеметричних перевірок
Кожна перевірка починається з чіткої вимоги. Потім визначається, який сигнал підтримує цю вимогу і який незалежний доказ потрібен додатково.
| Вимога | Доказ у телеметрії | Додатковий оракул | Рішення |
|---|---|---|---|
| Дозволені лише затверджені інструменти | Спостережувані виклики інструментів | Матриця дозволів і негативний тест | Відхилення блокує запуск |
| Запис файлів має відстежуватися | Спан або подія операції запису | Diff файлової системи та очікуваний шлях | Неочікуваний файл є дефектом |
| Помилка безпеки має зупинити процес | Статус помилки та пов’язана подія | Security-тест і незмінність даних | Продовження після помилки критичне |
| Використання моделі відповідає політиці | Ідентифікатор моделі, якщо його експортовано | Конфігурація підприємства | Невідома модель потребує аналізу |
| Результат виконує початкову вимогу | Трасування сесії | Функціональні перевірки та review | Одного трасування недостатньо |
Назви полів model.id, tool.name і file.path тут є лише прикладами. Джерелом істини залишається реальна схема колектора.
4. Практичні твердження
QA-набір може читати експортовані дані, не змінюючи агента, що тестується. Корисні перевірки:
- сесія має очікуваний початковий і кінцевий контекст;
- кожен спостережуваний виклик інструмента входить до актуального списку дозволів;
- заборонений доступ створює помітний шлях помилки й не спричиняє побічного ефекту;
- зміна файлу зіставляється з кроком запису в трасуванні та реальним diff;
- після критичної помилки сканера не виконуються операції запису;
- коли Content Capture вимкнено, в експорті немає неочікуваних полів із вмістом;
- неповне трасування отримує статус «недостатньо доказів», а не автоматичний Pass.
Перевірки мають бути стійкими до несуттєвих внутрішніх змін. Вимога точного порядку всіх службових спанів швидко стане нестабільною. Краще контролювати межі безпеки, обов’язкові кроки та спостережувані побічні ефекти.
5. Негативні та security-сценарії
Для агентної системи недостатньо перевірити лише успішний шлях. Особливо цінні контрольовані відмови:
- Інструмент не авторизований. Очікуються відмова, відсутність побічного ефекту та перевірювана помилка.
- Інструмент відповідає надто довго. Очікуються timeout, обмежені повторні спроби та відсутність нескінченного циклу.
- Сканер секретів виявляє витік. Очікуються зупинка або безпечна ескалація, а секрет не повинен потрапити до commit.
- Колектор недоступний. Система має діяти відповідно до архітектури, а втрата телеметрії не повинна непомітно перетворюватися на успішний тест.
- В експорті несподівано з’являється промпт або код. Запуск класифікується як проблема конфігурації чи захисту даних.
- Трасування обривається. Команда окремо перевіряє експорт, семплінг і зв’язок із тестовим запуском.
- Агент викликає правильний інструмент, але змінює неправильний файл. Телеметрія процесу зіставляється з реальним станом репозиторію.
Так QA розрізняє дефект продукту, помилку інструментування та порушення політики.
6. Безпечні налаштування даних
GitHub зазначає, що тексти промптів, відповіді моделі й аргументи інструментів за замовчуванням не включаються. Додатковий режим захоплення вмісту може розкрити код, вміст файлів і запити. У production його доцільно залишати вимкненим, якщо немає документованої мети та необхідних засобів захисту.
Для контрольованого тестового середовища потрібні щонайменше:
- мінімізація складу даних і обґрунтований короткий строк зберігання;
- рольовий доступ до колектора та системи аналізу;
- шифрування під час передавання і зберігання;
- журналювання адміністративного доступу;
- видалення секретів, персональних даних і чутливого коду;
- окремі налаштування для production і тестового середовища;
- регулярна перевірка нових атрибутів на чутливі дані;
- процедура реагування на ненавмисне захоплення вмісту.
Успішне надсилання телеметрії не означає, що потрібно збирати максимум інформації. QA потрібні релевантні докази, а не повна історія розмов.
7. Семплінг, зберігання та прогалини
Семплінг зменшує обсяг і вартість зберігання, але може приховувати рідкісні помилки. Для нового або критичного процесу виправдана вища частка збережених трасувань. Для частих низькоризикових сесій можна використати меншу частку. Рішення має залежати від ризику й обсягу, а не від універсального відсотка.
Tail-based sampling допомагає зберігати повільні або невдалі трасування після оцінки результату. Проте QA все одно повинен документувати, які дані могли бути відкинуті. Строк зберігання має бути достатнім для розслідування і порівняння тенденцій, але мінімальним з погляду безпеки та витрат.
Корисні показники якості:
- частка повних трасувань для відомих тестових запусків;
- частота помилок інструментів;
- затримка критичних кроків;
- кількість заборонених дій;
- частка запусків без зіставного функціонального результату;
- число проблем схеми, експорту та конфіденційності;
- час від виявлення аномалії до рішення людини.
Цільові значення формуються на підставі baseline конкретного продукту. Довільні загальні пороги створюють хибне відчуття контролю.
8. Процес triage на основі ризику
- Кореляція: тестовий запуск, commit, сесія і трасування отримують спільне посилання.
- Валідація: перевіряються повнота, часовий інтервал і версія схеми.
- Оцінка: автоматичні правила порівнюють інструменти, помилки та побічні ефекти з вимогами.
- Збагачення: додаються diff, результати CI, security-звіти й функціональні перевірки.
- Класифікація: проблема визначається як дефект продукту, помилка інструментування, порушення політики або нестача доказів.
- Рішення: відповідальна особа обирає випуск, блокування чи додаткове дослідження.
- Документування: зберігаються докази, версії та причина рішення.
Такий процес не дозволяє одному dashboard автоматично стати механізмом схвалення.
9. Питання для review
Перед випуском тестувальник має з’ясувати:
- Яку початкову вимогу підтримує це трасування?
- Яка реальна схема і версія інструментування використані?
- Чи можна зіставити очікувані інструменти та критичні побічні ефекти?
- Чи могли семплінг, помилка експорту або недостатні права спотворити доказ?
- Чи безпечно налаштовані Content Capture, доступ і зберігання?
- Який незалежний тест підтверджує фактичний результат?
- Хто ухвалює остаточне рішення щодо ризику?
- Чи збережено достатньо інформації для повторного розслідування?
10. Висновок
OpenTelemetry розширює інструментарій тестування ШІ-агентів для програмування. Трасування допомагає досліджувати звернення до моделей та інструментів, помилки й тривалість кроків. Метрики та події підтримують аналіз тенденцій і triage. Користь виникає лише тоді, коли сигнали пов’язані з вимогами, реальними побічними ефектами та незалежними тестами.
Надійна стратегія залишає Content Capture вимкненим за замовчуванням, захищає доступ і зберігання, явно враховує прогалини семплінгу та версіонує схему. Автоматизація може знаходити відхилення і збирати докази. Рішення про випуск ризикованого агентного процесу залишається за людиною.
Джерела
- GitHub Changelog — OpenTelemetry in the GitHub Copilot app — https://github.blog/changelog/2026-09-22-opentelemetry-in-the-github-copilot-app/
- GitHub Docs — OpenTelemetry for Copilot — https://docs.github.com/en/copilot/concepts/enterprise/opentelemetry
- OpenTelemetry — Observability Primer — https://opentelemetry.io/docs/concepts/observability-primer/
- OpenTelemetry — Tracing API — https://opentelemetry.io/docs/specs/otel/trace/api/
Залишити коментар
Поділіться думкою про статтю. Реєстрація не потрібна.
Коментарі
Завантаження коментарів…