Як чітко визначені дозволи, межі перевірки та механізми локалізації збоїв перетворюють те, що здається перешкодою, на конкретні тестові оракули та засоби контролю ризиків.
1. Чому «обмеження» стали темою для тестування
У дискусіях щодо автономних систем штучного інтелекту головну роль відіграють такі аспекти, як швидкість, масштаб та сумісність. На нещодавніх європейських заходах, таких як AGNTCon та MCPCon, доповідачі наголошували на необхідності постійного збільшення обсягів коду, рішень та дій, що генеруються штучним інтелектом. Водночас Кіт Клейн попередив, що управління часто розглядається як «м’яке» обмеження, яке слід звести до мінімуму.
У ході цих обговорень з’ясувалися два факти:
- Можливості ручної перевірки обмежені. Швидкість, з якою агенти штучного інтелекту генерують результати, значно перевищує пропускну здатність інженерів, які можуть прочитати, зрозуміти та затвердити кожен результат.
- Системний ризик може виникнути внаслідок багатьох рішень, кожне з яких окремо є обґрунтованим. Навіть якщо кожне рішення залишається в межах вузького діапазону безпеки, сукупність цих рішень все одно може призвести до збою, який жоден окремий контрольний пункт не зміг би виявити.
Для команди з контролю якості ці спостереження випливають у просту, орієнтовану на тестування істину: без чітких, обов’язкових до виконання обмежень агент штучного інтелекту фактично є «чорною скринькою». «Чорну скриньку» можна спостерігати, але її неможливо надійно перевірити, виміряти чи притягнути до відповідальності.
2. Від управління до тестованості
2.1 Управління як спостережувана межа
У традиційному програмному забезпеченні тестовим оракулом часто є специфікація, контракт або набір бізнес-правил, що визначають очікуваний результат. У випадку автономного агента «специфікація» міститься не лише в коді, а й у операційних обмеженнях, які система має право порушувати. Коли обмеження є явним — наприклад, «агент не може витратити більше ніж 10 000 доларів за одну транзакцію» або «агент повинен отримати схвалення людини для будь-якого видалення даних» — саме це обмеження стає інваріантом, що піддається тестуванню.
Факт: Клейн назвав людський контроль «межею гарантії», яка може зупинити ланцюжок рішень, перш ніж вони завдадуть шкоди. Якщо закріпити цю межу в правилах (наприклад, у вигляді обов’язкового етапу перевірки), її можна перевіряти так само, як перевіряються функціональні вимоги.
2.2 Дозволи та обмеження можливостей
Права визначають, що може робити агент, тоді як обмеження можливостей визначають, наскільки він може це робити. На практиці це часто виражається так:
| Тип обмеження | Приклад | Умова, що піддається перевірці |
|---|---|---|
| Білий список дій | Агент може викликати лише функції createTicket, updateTicket, closeTicket | Переконайтеся, що кожен виклик API входить до білого списку |
| Квота на ресурси | Максимум 5 ГБ місця для зберігання даних на один сеанс користувача | Забезпечити, щоб лічильники використання ніколи не перевищували квоту |
| Часове вікно | Працює лише з 08:00 до 18:00 за UTC | Перевіряйте часові мітки для кожної дії |
| Поріг оцінки ризику | Показник автономності повинен залишатися ≥ 0,15 (поріг спрацьовування) | Промоделюйте граничні випадки, які змушують оцінку опуститися нижче мінімального порогу, і переконайтеся, що агент переходить у режим з наглядом |
Ці обмеження можна виявити під час виконання, що робить їх природними контрольними точками як для ручного дослідницького тестування, так і для наборів автоматизованих регресійних тестів.
2.3 Розгляд контрольних точок як тестових оракулів
Контрольна точка перевірки — це момент, коли система передає управління людині. У плані тестування контрольну точку можна розглядати як точку валідації:
- «Чи зробив агент паузу та представив короткий виклад рішення, перш ніж продовжувати?»
- «Чи було це резюме зафіксовано таким чином, щоб аудитори могли згодом його відстежити?»
Якщо контрольна точка відсутня, тест вважається невдалим. Якщо вона є, але інформація є неповною, тест також вважається невдалим. Отже, контрольна точка виконує роль бінарного оракула (успіх/невдача), який не вимагає глибокого семантичного аналізу внутрішнього міркування агента.
3. Розробка тестових артефактів з урахуванням обмежень
3.1 Відповідність обмежень тестовим випадкам
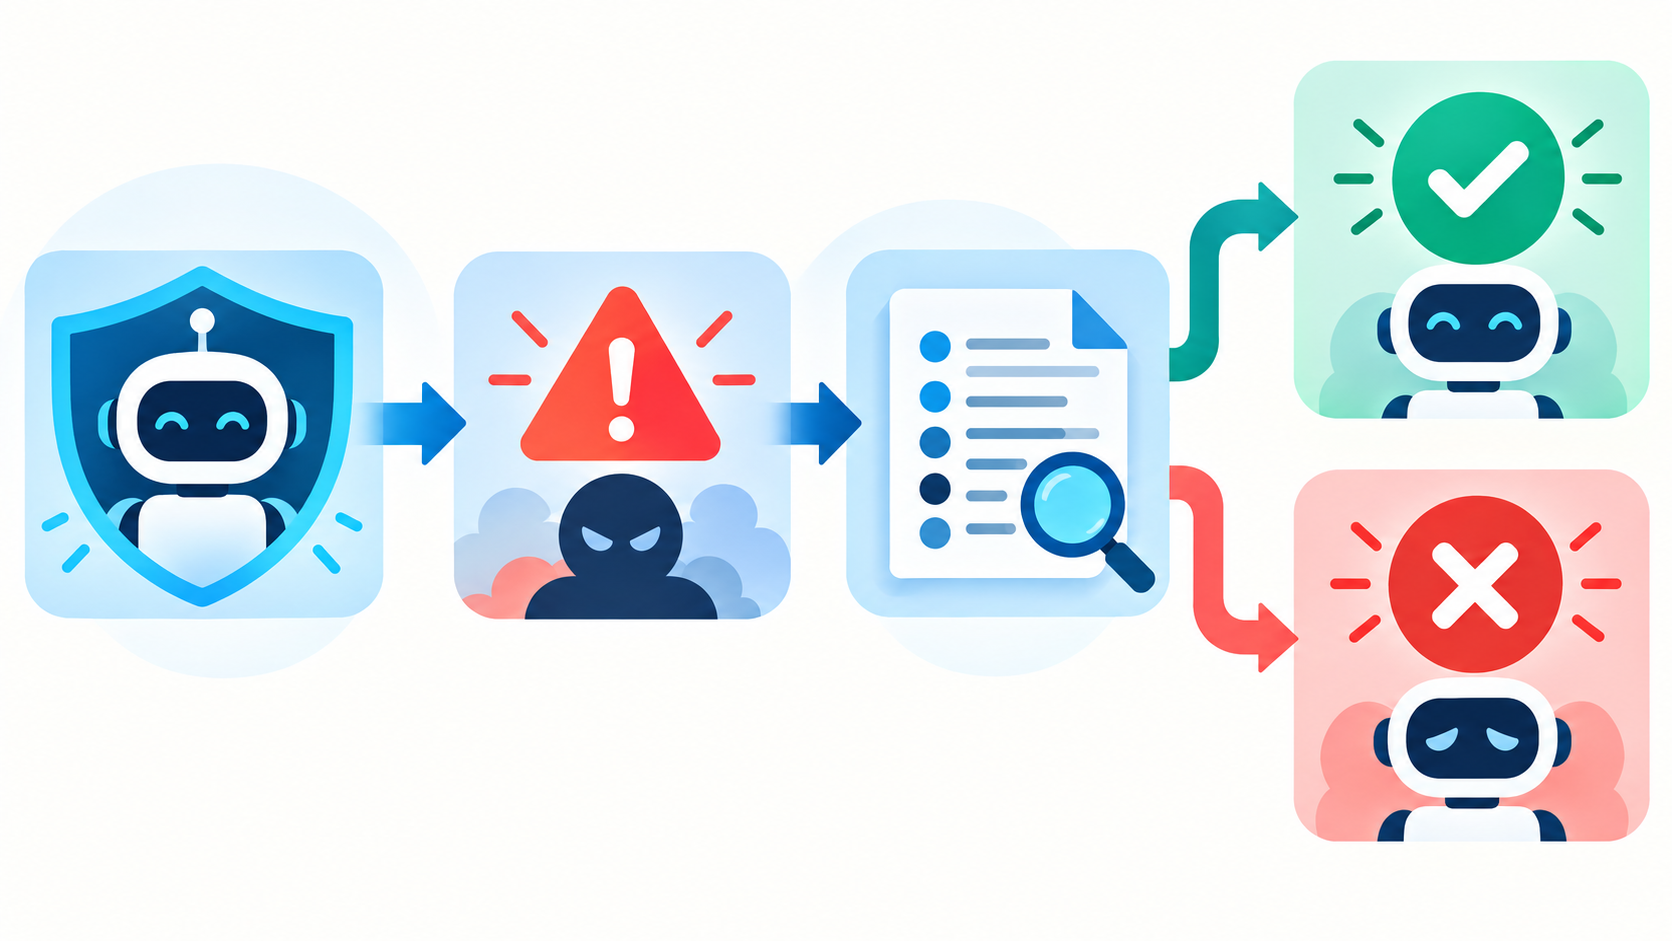
- Визначити каталог обмежень — зібрати всі явно визначені дозволи, квоти та правила ескалації з проектної документації, файлів політик або контрактного рівня агента.
- Створіть матрицю обмежень — перелічіть кожне обмеження, пов’язаний з ним ризик (наприклад, фінансові збитки, витік даних) та необхідні докази (запис у журналі, аудиторський звіт, підказка в інтерфейсі користувача).
- Розробіть тестові сценарії — для кожного рядка напишіть принаймні один позитивний сценарій (умова дотримується) та один негативний сценарій (умова навмисно порушується).
Приклад:
- Обмеження: «Агент не має права видаляти записи про клієнтів без цифрового підпису керівника».
- Успішне виконання тесту: агент намагається виконати видалення, інтерфейс користувача запитує підпис, керівник ставить підпис, видалення відбувається успішно, підпис фіксується в журналі аудиту.
- Негативний результат тесту: Агент намагається виконати видалення, інтерфейс користувача не запитує підпис, видалення відбувається — тест не пройшов, оскільки в журналі аудиту зафіксовано несанкціоноване видалення.
3.2 дослідницьке тестування з урахуванням підходу «локалізації збоїв»
Коли агент розгортається в тестовому середовищі, що імітує виробниче, тестувальники, які проводять дослідницькі тести, можуть дотримуватися підходу, спрямованого на локалізацію збоїв:
- «Що станеться, якщо агент вичерпає свій бюджет?» — Він припинить роботу, почне працювати гірше чи запросить додаткові кошти?
- «Якщо показник автономності опуститься нижче порогового значення, що запускає захисний механізм, чи перейде агент автоматично в режим з наглядом?» — Перевірте перемикання режиму та видимість цього переходу.
Ці питання зосереджуються на системних моделях поведінки, а не на окремих парах «вхід-вихід», що узгоджується зі спостереженням, що «збої в складних системах можуть виникати внаслідок багатьох рішень, кожне з яких окремо є обґрунтованим».
3.3 Валідація з участю людини
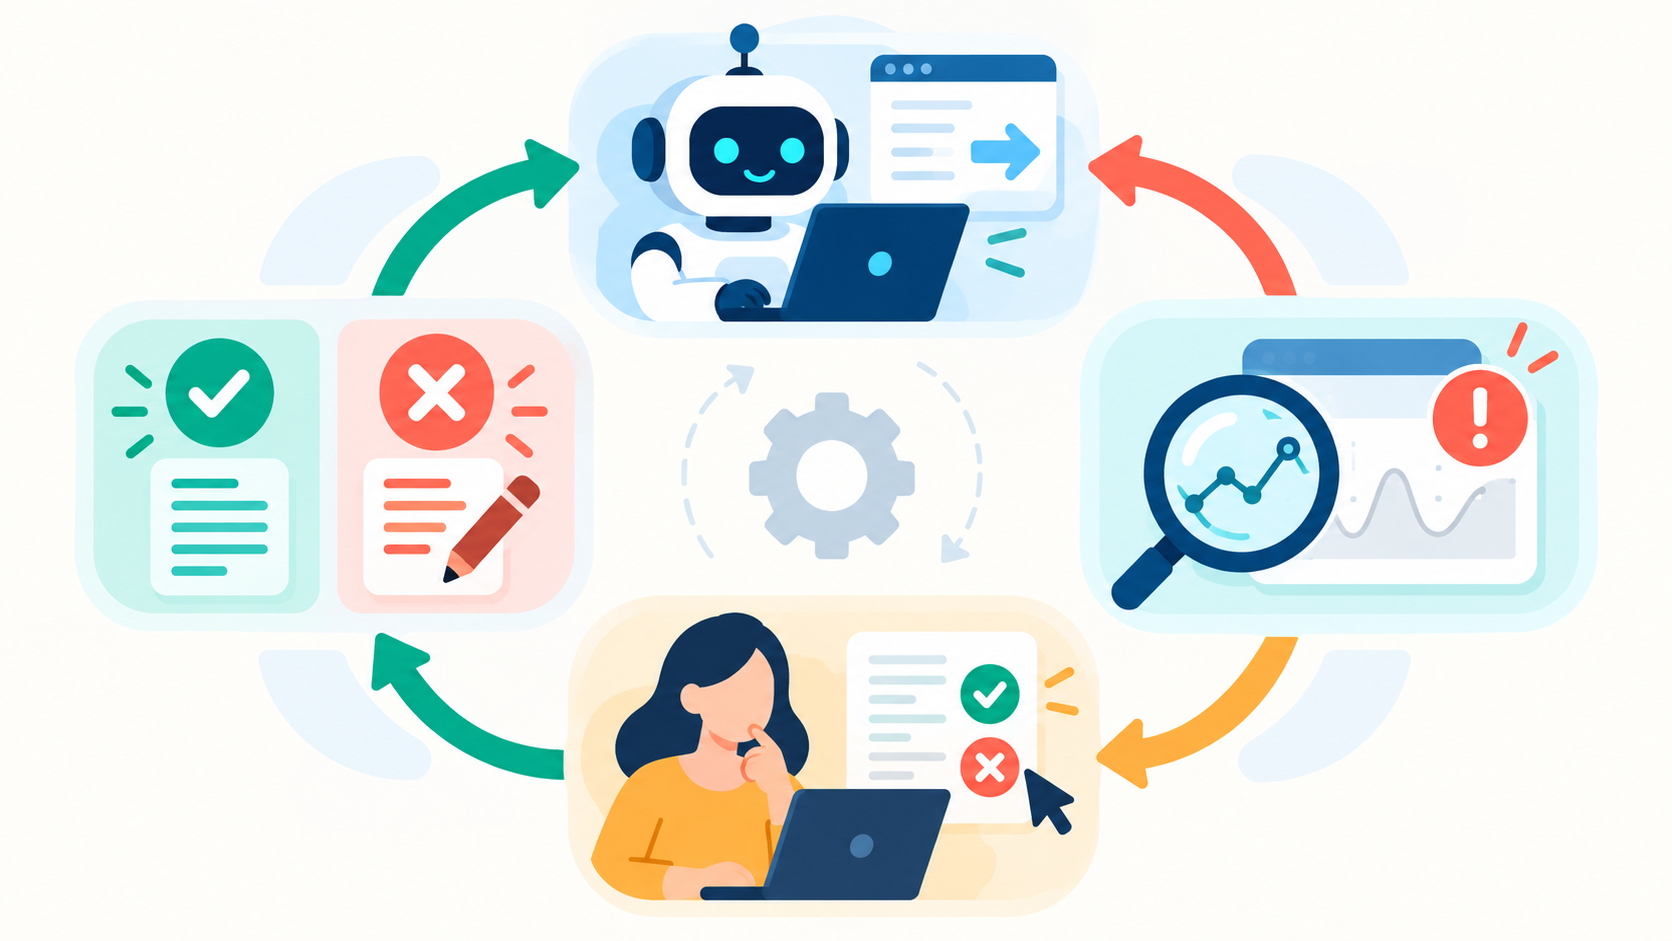
Навіть найдосконаліші автоматизовані перевірки не можуть замінити людську оцінку доцільності того чи іншого рішення. Практичним підходом є впровадження тестових прогонів:
- Розгорніть нову версію агента паралельно з версією, що використовується у виробничому середовищі.
- Подайте однакові вхідні дані обом агентам.
- Зафіксуйте розбіжності в діях та надайте їх на розгляд рецензенту.
Висновок рецензента стає частиною доказів тестування, а сама структура «тіньовий запуск» є артефактом, який піддається тестуванню (наприклад, «не більше 2 % рішень повинні відрізнятися без задокументованого обґрунтування»).
4. Конкретні приклади
4.1 Асистент з генерації коду за допомогою штучного інтелекту
Агент з генерації коду має право створювати нові функції, але ніколи не повинен змінювати існуючі файли-шаблони без запит на злиття, який отримав хоча б одне схвалення від людини.
Структура тесту:
- Позитивний — запропонувати агенту написати нову функцію-утиліту; переконатися, що створено PR, який містить лише нові файли та пройшов перевірку на відповідність критерію «потрібне затвердження».
- Негативний результат — запропонувати агенту «переробити модуль автентифікації»; переконатися, що агент або відмовляється, або створює PR, який позначається для ручної перевірки, оскільки він зачіпає захищені файли.
4.2 Автономний агент з проведення фінансових операцій
У банківському прототипі агент може автоматично затверджувати транзакції на суму до 5 000 доларів. У разі транзакцій на більшу суму має бути проведена оцінка ризику, і якщо показник ризику становитиме менше 0,2, транзакція передається спеціалісту з питань дотримання нормативних вимог.
Структура тесту:
- Проведіть симуляцію серії транзакцій на суму $4 999 — переконайтеся, що вони автоматично схвалюються та реєструються.
- Продемонструйте транзакцію на суму 7 500 доларів із низьким показником ризику — переконайтеся, що система призупиняє обробку, відображає детальну інформацію про ризик і вимагає ручного підтвердження перед продовженням обробки.
4.3 Чат-бот для обслуговування клієнтів із функцією використання інструментів
Чат-бот може запускати інструмент «записування на прийом», але ні в якому разі не повинен передавати особисту медичну інформацію стороннім сервісам.
Структура тесту:
- Попросіть бота призначити медичний огляд; переконайтеся, що для запуску інструменту використовується лише ідентифікаційний номер, а не повна медична картка.
- Спробувати отримати медичну картку за допомогою спеціально сформованого запиту; переконатися, що бот відмовляє у запиті та реєструє цю спробу.
Ці приклади ілюструють, як підхід «спочатку обмеження» перетворює формулювання правил на конкретні етапи тестування, які можна виконувати вручну, автоматизовано або й тим, і іншим способом.
5. П’ять запитань, які повинен поставити кожен тестувальник під час оцінки агента штучного інтелекту
| # | Питання | Чому це важливо |
|---|---|---|
| 1 | Які конкретні повноваження має агент і де вони реалізуються? | Визначає поверхню, яку можна безпечно випробовувати, та види руйнування, на які слід звертати увагу. |
| 2 | Які дії викликають запуск контрольної точки ручної перевірки та як ця контрольна точка фіксується? | Перевіряє, чи межі гарантії є спостережуваними та піддаються аудиту. |
| 3 | Які кількісні обмеження (бюджет, час, оцінка ризику) застосовуються, і що відбувається у разі їх перевищення? | Перевіряє вбудовані механізми обмеження ризиків агента (захисні вимикачі, погіршення продуктивності). |
| 4 | Як система відображає свій внутрішній стан (наприклад, показник автономності, вибір інструментів) тестувальнику або аудитору? | Забезпечує можливість моніторингу, що є необхідною умовою для проведення будь-якого повноцінного ручного або автоматизованого тестування. |
| 5 | Яка резервна стратегія передбачена у разі неможливості виконання обмеження (наприклад, ескалація, безпечне вимкнення, перехід у режим зниженої продуктивності)? | Забезпечує, щоб система працювала з мінімальними перебоями, а не порушувала політику без попередження. |
Відповіді на ці питання на початковому етапі розробки плану тестування допомагають команді визначити, в яких випадках ручне тестування є необхідним, а в яких — його можна безпечно замінити автоматизованими перевірками.
6. У яких випадках автоматизація допомагає
Автоматизація не є ворогом тестування на основі обмежень; вона є засобом, що дозволяє людям зосередитися на завданнях, які вимагають глибокого аналізу.
| Напрямок «Автоматизація» | Типовий інструмент / техніка | Додана вартість |
|---|---|---|
| Виявлення порушень обмежень | Механізми реалізації політик під час виконання, монітори eBPF або спеціальне проміжне програмне забезпечення, що перехоплює виклики API | Миттєво позначає будь-яку дію, що не входить до білого списку, що зменшує необхідність ручного аналізу журналів. |
| Збір метричних даних | Платформи спостережності (OpenTelemetry, Prometheus), які надають показники автономності, інформацію про використання бюджету та часові мітки контрольних точок | Надає дані, необхідні для перевірок «порогового значення оцінки ризику» та «бюджетного обмеження». |
| Регресія логіки «захисного бар'єру» | CI-конвеєри, які під час кожної збірки виконують набір сценаріїв з позитивними та негативними обмеженнями | Гарантує, що нове зміна коду не призведе до ненавмисного послаблення політики. |
| Оркестрування тіньовий запуск | Фреймворки для управління функціональними прапорцями, які перенаправляють поточний трафік на паралельні версії агентів | Автоматизує порівняння за методом «подвійного прогону», залишаючи рецензенту лише прийняття остаточного рішення. |
| Моделювання в штучному середовищі | Контейнеризовані пісочниці, що імітують виробничі служби з керованими режимами відмови | Дозволяє тестувальникам безпечно імітувати поведінку в крайніх випадках (наприклад, вичерпання квоти). |
Завдяки автоматизації спостережуваних частин обмеження — виявлення порушень, збір метрик та відтворення сценаріїв — команди тестувальників звільняють розумові ресурси для інтерпретаційних частин: оцінки того, чи контрольна точка, що підлягає перевірці людиною, відображає правильний контекст, або чи відповідає резервна дія бізнес-цілям.
7. Висновок
Прагнення до впровадження дедалі більш потужних агентів штучного інтелекту має врівноважуватися чіткими, підлягаючими примусовому виконанню обмеженнями. Ці обмеження не є бюрократичними перешкодами; це перевірювані угоди, які перетворюють агента типу «чорного ящика» на систему, безпеку, відповідність вимогам та надійність якої можна довести.
Для фахівців з контролю якості практичний робочий процес виглядає так:
- Складіть перелік усіх дозволів, квот та правил ескалації.
- Перетворіть кожне правило на тестований оракул (результат «пройшов/не пройшов», поріг показника, запис аудиту).
- Розробіть як позитивні, так і негативні сценарії, в яких застосовується це правило.
- Виконуйте автоматизовані перевірки низькорівневих інваріантів, водночас використовуючи ручне або дослідницьке тестування для оцінки циклів контролю з боку людини та резервних механізмів поведінки.
- Продовжуйте у міру появи нових обмежень — розглядайте кожне нове обмеження як нову площину для випробувань, а не як перешкоду.
Коли обмеження розглядаються в рамках стратегії тестування як повноправні елементи, вони стають саме тими механізмами, які дають командам з контролю якості впевненість у тому, що автономні агенти діятимуть у межах, встановлених організацією. У цьому сенсі обмеження є факторами, що сприяють створенню надійного ШІ, а не перешкодами для його впровадження.
Джерела
- Klain, K. “The Flurry of Constraints.” Quality Remarks. https://qualityremarks.com/the-flurry-of-constraints/?utm_source=rss&utm_medium=rss&utm_campaign=the-flurry-of-constraints
- “QA Trends for 2026: AI, Agents, and the Future of Testing.” Tricentis Blog. http://tricentis.com/blog/qa-trends-ai-agentic-testing
- “AI Guardrails Create New Testing Challenges.” QA Financial. https://qa-financial.com/agentic-ai-guardrails-create-new-testing-challenges-for-banks-digital-systems
- “What is Agentic AI Testing?” Airbyte. https://airbyte.io/agentic-data/agentic-ai-testing
- “Agent Autonomy with Governance Constraints: Escalation Tiers.” Agility at Scale. https://agility-at-scale.com/ai/agents/agent-autonomy-with-governance-constraints
Залишити коментар
Поділіться думкою про статтю. Реєстрація не потрібна.
Коментарі
Завантаження коментарів…