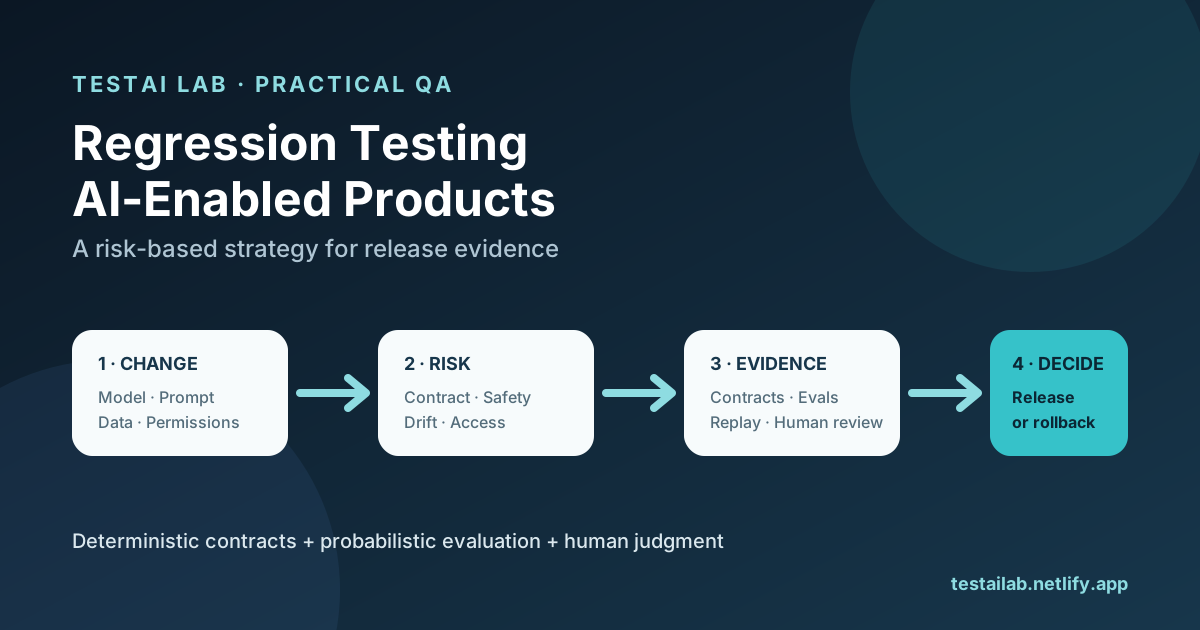
Цільова аудиторія: QA‑інженери, інженери автоматизації тестування та команди розробки, які випускають функції, підсилені ШІ.
1. Чому підхід, орієнтований на ризики, є необхідним для ШІ
Традиційне регресійне тестування передбачає, що вихід функції детермінований: при однакових вхідних даних очікується однаковий результат. Генеративний ШІ, моделі з підкріпленням пошуку та великі мовні моделі (LLM) спростовують це припущення. Їхні виходи ймовірні і можуть змінюватися при незначних змінах моделі, формулювання запиту, корпусу пошуку або системних інструкцій.
Рамка управління ризиками ШІ NIST (AI RMF) організовує управління ризиками навколо чотирьох функцій: управління, визначення контексту, вимірювання та вжиття заходів. Документ описує характеристики надійного ШІ: валідність і надійність, безпеку, захищеність і стійкість, підзвітність і прозорість, пояснюваність, захист приватності та управління шкідливою упередженістю. У цій статті принципи перетворено на проєктну стратегію регресії; NIST не встановлює конкретну тестову матрицю або числові пороги з прикладів.
Стратегія регресійного тестування, орієнтована на ризики, зосереджує зусилля тестування на областях, де зміна найімовірніше порушить контракт або спричинить небезпечну поведінку, замість того, щоб повторно запускати повний набір, який розглядає кожен вихід як жорсткий оракул.
2. Створення матриці регресійного тестування, орієнтованої на ризики
Матриця відображає категорії змін у ризикові категорії та у тип доказів, необхідних перед тим, як випуск може продовжитися. Вона також уточнює, де кожен тест розташовується у CI/CD конвеєрі (запит на злиття, нічний запуск, передрелізна перевірка).
| Категорія зміни | Затронуті ризики | Необхідні докази | CI‑етап |
|---|---|---|---|
| Оновлення версії моделі | • Дрейф виходу<br>• Регресія безпекових обмежень<br>• Регресія продуктивності | • Порівняння з базовим набором на золотому датасеті (пороги оцінки)<br>• Метрики моніторингу дрейфу (наприклад, KL‑дивергенція)<br>• Метаморфні інваріанти | Нічний запуск + передрелізна перевірка |
| Налаштування запиту / системної інструкції | • Ін’єкція запиту, збільшення галюцинацій<br>• Порушення контракту (наприклад, зміна формату) | • Тести інваріантів/контрактів на репрезентативному наборі запитів<br>• Набір ворожих запитів | запит на злиття (швидко) |
| Оновлення корпусу пошуку | • Несумісність бази знань<br>• Протікання конфіденційних даних | • Відтворення запитів пошуку з початковим набором<br>• Перевірки меж дозволів у повернутих документах | Нічний запуск |
| Зміна дозволів / доступу до інструменту | • Неавторизоване використання інструменту<br>• Ескалація привілеїв | • Юніт‑тести меж дозволів<br>• Симуляції доступу на основі ролей | запит на злиття |
| Зміна детермінованого бізнес‑правила (наприклад, розрахунок цін) | • Фінансові помилки розрахунків<br>• Невідповідність регуляторним вимогам | • Перевірки золотого набору даних (точний збіг)<br>• Тести контракту на API‑payload'ах | запит на злиття |
| Оновлення захисних бар’єрів безпеки (наприклад, фільтр нецензурної лексики) | • Протікання шкідливого контенту<br>• Порушення політики | • Набір регресійних тестів захисних бар’єрів (негативні тести)<br>• Вибірка для людського перегляду | передрелізна перевірка |
| Зміна інтеграції UI / API | • Порушені контракти, відсутні поля, сплески затримки | • Валідація схеми (контракт OpenAPI)<br>• Сквозний UI‑потік з Для UI-тестів офіційна документація Playwright містить окремий посібник із CI та приклади GitHub Actions: https://playwright.dev/docs/ci
5. Відрізнення детермінованих асерцій від ймовірнісних оцінок
| Аспект | Детермінований | Ймовірнісний |
|---|---|---|
| Характер оркеля | Точне значення або присутність (наприклад, поле JSON status: "OK"). | Статистичний або на основі допуску (наприклад, середнє BLEU ≥ 0.78). |
| Режим збою | Бінарний – успішно/не успішно. | Може вимагати налаштування порогу; випадкові «хибно‑негативні» відхилення прийнятні, якщо в межах ліміту. |
| Типовий тест | Валідація схеми, перевірки прав, точна відповідність золотому набору даних. | Метаморфні відношення, порогові значення балів, метрики відхилення. |
| Залучення людини | Зазвичай відсутнє. | Часто перегляд аномалій або аналіз тенденцій. |
При документуванні тесту завжди вказуйте, чи є твердження детермінованим чи ймовірнісним, і включайте допуск або поріг, що визначає успішність.
6. “Зміна → Затронуті ризики → Докази → Рішення про випуск” у практиці
Нижче наведено стислий чек‑лист, який керівники QA можуть вбудовувати у нотатки про випуск.
| Зміна | Затронуті ризики | Зібрані докази | Рішення |
|---|---|---|---|
| Інтеграція нового інструменту (наприклад, плагін генерації коду) | Неавторизоване виконання, витік даних | Тести межі дозволів (всі відхилені для ролі, що не є адміністратором) + негативні тести захисних механізмів (не генерується код для заборонених доменів) | ✅ Злити; моніторити журнали після випуску |
| Переробка шаблону підказки | Несумісний тон, відсутні посилання | Контрактні тести на 30 ключових підказках (поле посилання присутнє) + метаморфний тест (перестановка пунктів списку не змінює кількість посилань) | ⚠️ Неуспішно – перегляньте шаблон, щоб зберегти логіку посилань |
| Оновлення корпусу пошуку | Застарілі знання, витік конфіденційності | Відтворення 100 відомих запитів (ідентифікатори збігаються) + перевірка конфіденційності (у топ‑5 результатах немає ПІБ) | ✅ Просунути до передрелізу; запланувати наступний нічний аудит |
| Посилення правила безпеки | Переблокування легітимних запитів | Набір регресійних тестів Guardrail (≤ 2 % хибнопозитивних на безпечних підказках) + людський перегляд 20 вибірково заблокованих відповідей | ✅ Реліз з гейтом відкату, встановленим на 5 % збільшення хибнопозитивності |
7. Де автоматизація допомагає
- Швидкі детерміністичні перевірки – валідація схеми, примусове застосування дозволів та точні золоті набори даних ідеальні для автоматизації на рівні PR.
- Моніторинг статистичного дріфту – автоматичний розрахунок KL‑дивергенції, BLEU або кастомних оцінок релевантності може виконуватись щонічно та подаватись у дашборди.
- Генерація метаморфних тестів – інструменти можуть програмно створювати варіації вводу (наприклад, заміну синонімів) для перевірки ймовірнісних інваріант.
- Адаптивне фуззинг‑тестування підказок – CI може інжектувати підготовлений список спроб jailbreak і перевіряти, чи спрацьовують фільтри безпеки.
- Гейт відкату – CI‑конвеєри можуть автоматично зупиняти просування, якщо метрики дріфту перевищують пороги, зменшуючи людську працю.
Автоматизація не замінює людське судження для безпечних‑критичних або політико‑орієнтованих виходів. Людський перегляд залишається необхідним для оцінки тонких шкод, упереджень або регуляторної відповідності.
8. Практичні кроки для старту
- Визначте контракти – Складіть список усіх детерміністичних виходів (схеми API, UI‑елементи, бізнес‑правила розрахунків).
- Визначте категорії ризиків – Прив’яжіть кожен контракт до категорій змін, які можуть його вплинути (модель, підказка, дані, дозволи).
- Виберіть типи доказів – Оберіть детерміністичні твердження для контрактів та ймовірнісні пороги для якості/безпеки.
- Створіть регресійну матрицю – Заповніть таблицю у розділі 2; збережіть її у документі під контролем версій.
- Реалізуйте CI‑хуки – Використовуйте GitHub Actions або вашу CI‑платформу для запуску відповідного набору на кожному етапі конвеєра.
- Встановіть пороги та контрольні умови – Визначте проєктні пороги на основі задокументованої допустимості ризику та базових доказів. Наприклад, команда може дозволити не більше 0,5 % додаткового зростання помилок зі шкідливим контентом; це ілюстративне правило проєкту, а не рекомендація NIST.
- Додайте контрольні точки людського перегляду – Визначте розмір вибірки та критерії для передрелізної ручної оцінки.
- Ітерація – Після кожного релізу переглядайте логи дріфту та звіти про інциденти; коригуйте матрицю, пороги або охоплення тестів відповідно.
9. Питання для огляду
- Що відрізняє детерміністичний регресійний тест від ймовірнісного, і чому ця різниця важлива для продуктів з підтримкою ШІ?
- Як шаблон “зміна → уражені ризики → докази → рішення про реліз” допомагає командам QA пріоритетизувати зусилля тестування?
- Назвіть три типи тестів, які найкраще підходять для валідації запит на злиття, і поясніть чому.
- Які метрики можна використати у нічному наборі моніторингу дріфту для виявлення небажаних змін після оновлення моделі?
- Чому крок вибірки з людським переглядом потрібен, навіть коли автоматизовані тести захисних бар’єрів проходять?
10. Висновок
Регресійне тестування систем з підтримкою ШІ не може спиратися на єдину “золоту відповідь”. Шляхом класифікації змін, відображення їх на конкретні ризики та збору правильного набору детерміністичних і ймовірнісних доказів, команди можуть приймати обґрунтовані рішення про реліз, зберігаючи безпеку, відповідність та якість під контролем. Вбудовування цієї ризик‑орієнтованої матриці у CI/CD процес—перевірки запит на злиття для швидких детерміністичних контрактів, нічні набори для статистичного дріфту та передрелізні ворота для захисних бар’єрів—забезпечує масштабований, повторюваний процес, який відповідає NIST ШІ Risk Management Framework та кращим галузевим практикам.
Джерела
- NIST AI Risk Management Framework 1.0 — функції Govern, Map, Measure і Manage та характеристики надійного ШІ. https://www.nist.gov/itl/ai-risk-management-framework
- OWASP Top 10 for LLM and Generative AI Applications — ризики безпеки, зокрема ін’єкція промпта. https://genai.owasp.org/
- Документація GitHub Actions — подієвий, ручний і запланований запуск робочих процесів. https://docs.github.com/en/actions
- Документація Playwright — офіційні рекомендації щодо CI та приклади GitHub Actions. https://playwright.dev/docs/ci
Залишити коментар
Поділіться думкою про статтю. Реєстрація не потрібна.
Коментарі
Завантаження коментарів…