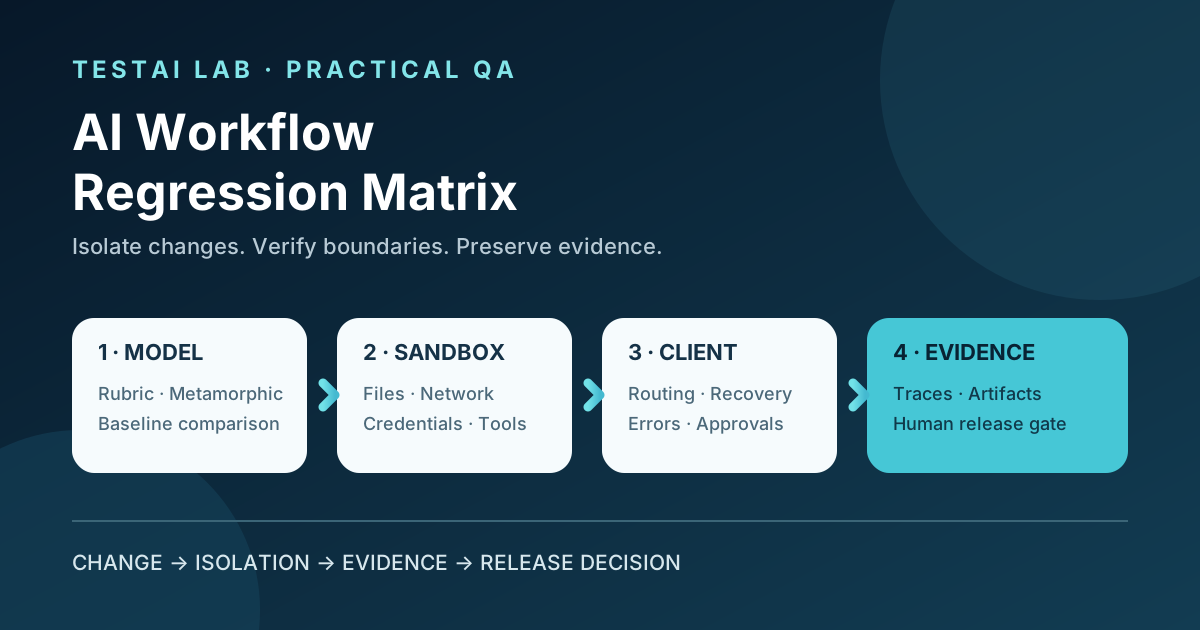
Робочий процес кодування ШІ може змінюватися одночасно в кількох місцях: обрана модель, політика локальної пісочниці, конфігурація телеметрії або клієнт, який починає завдання. Одна помилка, наприклад «агент не зміг завершити», не визначає, який рівень регресував.
Корисним прикладом є набір релізу Copilot від GitHub від 21 вересня. Він анонсував додаткові моделі, локальну пісочницю у публічному попередньому перегляді, налаштування телеметрії та оновлення інтеграцій із корпоративними чатами й середовищами розробки. Це факти про продукт. Нижче представлений дизайн тесту — це наша пропозиція щодо контролю якості; це не опис тестів, проведених GitHub.
1. Визначте систему як чотири тестувані шари
Розглядайте робочий процес як чотири пов'язані шари:
- Шар моделі: створює ймовірнісний код або пояснення.
- Рівень політики: визначає, чи дозволений доступ до файлу, мережі, облікових даних або інструменту.
- Клієнтський шар: надсилає контекст, показує прогрес, запитує затвердження та подає помилки.
- Рівень доказів: фіксує достатньо телеметрії та артефактів, щоб пояснити, що сталося.
Ключове питання тестування — не лише «Чи пройшло завдання?» Це «Який рівень змінився, які докази підтверджують результат і чи можемо ми його відтворити?»
2. Створіть базову лінію перед тим, як щось змінювати.
Використовуйте невеликий фіксований набір завдань, який відображає реальну роботу, не торкаючись виробничих даних. Наприклад:
- модифікувати одну функцію в одноразовому сховищі;
- виконати локальний модульний тест;
- прочитати файл, що знаходиться всередині дозволеного робочого простору;
- спробувати прочитати синтетичний файл поза дозволеним робочим простором;
- викликати затверджену модельну HTTP-кінцеву точку;
- спроба викликати заблокованого імітаційного хоста;
- Запитуйте операцію, яка потребує явного людського дозволу.
Запустіть набір на поточній стабільній конфігурації та збережіть вибрану модель, версію клієнта, політику пісочниці, комміт тестового репозиторію, запити, рішення інструментів, згенерований патч, результат тесту та фінальний статус.
Не використовуйте точну згенеровану відповідь як базову лінію. GitHub документує, що Copilot підтримує кілька моделей з різними сильними сторонами, і що доступність моделі може змінюватися. Згенерований контент є ймовірнісним; стабільним оракулом має бути спостережувана поведінка та критерії прийняття.
3. Відокремити детерміновані контракти від ймовірнісної якості
Детерміновані перевірки відповідають на запитання з чітким «так» або «ні»:
- Чи містив відповідь необхідні структуровані поля?
- Чи залишили заборонений шлях файлової системи незмінними?
- Чи отримував мок-сервер жодного запиту, коли його хост був заблокований?
- Чи потрібне було схвалення перед захищеною діяльністю?
- Чи показав клієнт корисну помилку замість того, щоб залишатися у режимі завантаження?
- Чи були тестові артефакти пов'язані з правильним забігом?
Ймовірнісні перевірки оцінюють якість запропонованої зміни:
- Чи задовольняє патч завдання?
- Чи проходять існуючі тести?
- Чи впровадила модель зайві зміни?
- Чи є технічно правильним пояснення?
- Чи є рішення підтримуваним і безпечним?
Оцінюйте ймовірнісні результати за допомогою рубрики, що належить людині. Прикладами є правильність, контроль обсягу, докази тесту, безпека та обслуговуваність. Будь-який числовий поріг має виходити з власного базового рівня та толерантності до ризику проєкту; це не є вимогою GitHub.
4. Використовуйте матрицю ізоляції змін
Виконуйте той самий набір завдань у контрольованих комбінаціях:
- базова модель + базова політика + базовий клієнт;
- модель кандидата + базова політика + базовий клієнт;
- базова модель + політика кандидата + базовий клієнт;
- базова модель + базова політика + кандидат-клієнт;
- Модель кандидата + політика кандидата + кандидат-клієнт.
Змінити лише один вимір у проміжних рядах. Це створює докази для сортування.
Якщо показники якості знижуються лише у моделі кандидата, досліджуйте поведінку моделі та підказки. Якщо дозволений інструмент починає давати відмову лише за політикою кандидата, перевірте правила пісочниці. Якщо той самий запит успішно проходить через одного клієнта, але втрачає контекст або затвердження через інший, розглядайте це як дефект інтеграції. Якщо всі комбінації не працюють, перевірте спільні сервіси та дані тестування перед тим, як звинувачувати будь-який кандидат-компонент.
5. Перевірте межі пісочниці через побічні ефекти
Локальне пісочництво призначене для обмеження доступу до файлової системи, мережевого підключення та використання облікових даних. Тестуйте політику через помітні побічні ефекти в одноразовому робочому просторі.
Для дозволеного запису перевіряйте точний шлях файлу, вміст і відмінність. Для відхиленого запису переконайтеся, що цільовий файл не існує і що жоден сусідній файл не змінився. Для мережевих тестів використовуйте локальні мак-кінцеві точки та підтверджуйте дозволені або заблоковані запити у мок-логах. Для облікових даних використовуйте лише синтетичні токени і підтверджуйте, що секрети недоступні там, де політика вимагає їх маскування.
Налаштування налаштовані окремо для різних підтримуваних поверхонь, і поведінка операційної системи може відрізнятися. Записуйте клієнт, операційну систему та ефективну політику з кожним результатом. Ніколи не робіть висновок, що політика, перевірена в одній поверхні, автоматично застосовується до всіх інших клієнтів.
6. Перевірте інтеграцію клієнтів без припущення про ідентичність функцій
У пакеті релізу згадувалося кілька клієнтів, але це не означає, що кожен клієнт демонструє однакову пісочницю або поведінку телеметрії. Спочатку створіть карту можливостей.
Для кожного протестованого клієнта записуйте:
- доступний вибір моделі;
- підтримували контроль дозволів і затвердження;
- обробка контексту або прикріплення;
- поведінка при перериванні та повторному підключенні;
- повідомлення про помилки;
- доступні журнали та телеметрія.
Потім запускайте лише перевірки, які підтримує ця поверхня. Крос-клієнтська регресія означає порівняння спільних контрактів, таких як ідентифікація завдання, вибір репозиторію, мова, вкладення, посилання та фінальний статус. Клієнтські можливості потребують власних очікувань.
7. Перевірте переривання та відновлення
Довготривала робота агента може бути перервана закритим клієнтом, втратою мережі, закінченою сесією або відхиленим викликом інструменту. Використовуйте безпечну ін'єкцію відмови:
- почніть завдання в одноразовому сховищі;
- переривати роботу клієнта або імітувати з'єднання;
- відновити сесію;
- перевірити, чи відновлюється, перезапускається завдання або не відбувається явно;
- Підтверджуйте, що дублювання комітів, дублювання проблем і повторюваних побічних ефектів не були створені.
Перевірка відновлення проходить лише тоді, коли стан у результаті є однозначним. "Інтерфейс знову активний" не є доказом. Порівняйте стан репозиторію, імітовані запити, статус сесії та артефакти.
8. Розглядайте телеметрію як чутливий доказ тесту
GitHub документує підтримку OpenTelemetry для моніторингу сесій агентів, включаючи трасування, метрики та події. Керовані налаштування можуть контролювати, чи захоплюються ідентифікація, підказки, відповіді, аргументи інструментів, вихід інструментів або деталі політики. Деякі класи можуть містити вихідний код, команди, шляхи та секрети.
Перевірте саму конфігурацію телеметрії:
- очікувані сесії досягають затвердженого колектора;
- Пробіг можна корелювати без винайдення специфічних назв проміжків;
- Відключені класи захоплення не відображаються;
- Включені курси обмежені затвердженим тестовим середовищем;
- заголовки авторизації та колекторські облікові дані ніколи не друкуються;
- Утримання та доступ відповідають політиці проєкту.
Для рутинного контролю якості віддавайте перевагу метаданим і результатам, а не захопленим запитам або вихідним контентом. Увімкніть чутливий захоплення лише для затвердженого розслідування.
9. Класифікуйте помилки перед повторною спробою
Повторні спроби можуть приховати реальні регресії. Розділити невдачі на:
- тимчасова несправність сервісу: повторна спроба з невеликим обмеженим відходом;
- Відмова в політиці: не повторюйте; перевірте, чи очікувалася відмова у виконанні;
- збій парсингу або рендерингу клієнта: захоплення сирої відповіді та журналів клієнта;
- Якість помилки: зберігайте результати та результати рубрики для перегляду;
- Помилка тестового середовища: відремонтуйте світильник, потім запустіть той самий кандидат.
Завжди додавайте оригінальну спробу та історію повторних спроб. Повторна спроба не стирає першу невдачу.
10. Визначте елементи випуску та відкату
Практичні ворота можуть вимагати:
- усі детерміновані перевірки контрактів проходять;
- не виникає несанкціонованого побічних ефектів файлової системи, мережі, облікових даних чи інструментів;
- кожен підтримуваний клієнт виконує основне завдання та чітко повідомляє про помилки;
- Якість кандидатів не опускається нижче затвердженого порогу рубрики проєкту;
- тести на переривання не створюють дублювання зовнішньої дії;
- необхідні докази доступні без розкриття таємниць;
- Людський рецензент приймає вибірки з найвищим ризиком.
Відкат має бути можливим для кожного виміру. Відкотити вибір моделі без послаблення політики пісочниці, відкотити інтеграцію з клієнтами без видалення доказів і відновити відому політику, зберігаючи невдалий кандидат для аналізу.
11. Де допомагає автоматизація
Автоматизація ефективна для захоплення конфігурації, перевірки схем, підтверджень файлових систем і мереж, аналізу диференцій, виконання тестів, виявлення дублікатів і збору артефактів. Вона також може порівнювати базові та кандидатські бали.
Автоматизація не повинна вирішувати, чи є прийнятним правдоподібне, але інше рішення, чи виправдане розширення дозволів, або чи зібрана телеметрія є пропорційною. Ці рішення належать людям, які відповідають за ризики продукту, безпеку та конфіденційність.
12. Контрольний список QA
Перед релізом підтвердьте:
- записуються базові та кандидатські конфігурації;
- використовувався той самий фіксований набір завдань;
- одновимірні ізоляційні серії є повними;
- детерміновані та ймовірнісні перевірки розділяються;
- тести пісочниці використовують одноразові шляхи, імітовані хости та синтетичні секрети;
- Кожен протестований клієнт має чітку карту можливостей;
- тести на переривання перевіряють наявність повторюваних побічних ефектів;
- Захоплення телеметрії мінімальне і затверджене;
- Історія повторних спроб видно;
- відкат власності передається;
- остаточне рішення фіксується людським рецензентом.
Питання для повторення
- Чому точна згенерована відповідь є слабким оракулом для зміни моделі?
- Які побічні ефекти доводять, що правило пісочниці спрацювало?
- Як одновимірний ізоляційний запуск покращує аналіз корінних причин?
- Які докази потрібні після перерваного завдання агента?
- Які рішення щодо випуску мають залишатися у власності людини?
Висновок
Багатовимірні релізи ШІ потребують більше, ніж один смоук‑тест. Надійна стратегія заморожує базову лінію, змінює по одному шару, перевіряє детерміновані побічні ефекти, оцінює ймовірнісну якість за допомогою рубрики та зберігає докази для прийняття рішення про випуск людиною. Результатом є регресійний процес, який може відрізнити зміну моделі від заперечення пісочниці, дефекту клієнта або прогалини в спостережуваності, не прикидаючись, що результат ШІ є детермінованим.
Джерела
- GitHub Copilot weekly releases — September 21: https://github.blog/changelog/2026-09-25-github-copilot-weekly-releases-september-21
- Supported ШІ models in GitHub Copilot: https://docs.github.com/en/copilot/reference/ai-models/supported-models
- Configuring local sandbox settings: https://docs.github.com/en/copilot/how-tos/cloud-and-local-sandboxes/configuring-local-sandbox-settings
- OpenTelemetry for agent monitoring: https://docs.github.com/en/copilot/concepts/enterprise/opentelemetry
Залишити коментар
Поділіться думкою про статтю. Реєстрація не потрібна.
Коментарі
Завантаження коментарів…