Як за допомогою ШІ виявляти першопричини періодичних збоїв, зберігати докази першої невдачі й не дозволяти самовідновленню приховувати реальні дефекти продукту.
1. Вступ
Нестабільні тести — це тести, які без змін у коді то проходять, то завершуються невдало. У конвеєрі безперервної інтеграції (CI) вони можуть перетворити справжній дефект на «зелену» збірку, підірвати довіру до автоматизації та привчити розробників ігнорувати результати тестування. Тестовий раннер Playwright підтримує повторні спроби й надає докладне трасування, але ці можливості часто використовують як просту кнопку «зробити збірку зеленою».
У цьому посібнику показано, як перетворити механізми повторних спроб і трасування Playwright на діагностичний сигнал, а не на спосіб замаскувати результат, і як доповнити зібрані дані аналізом за допомогою ШІ, зберігаючи участь людини в ухваленні рішень. Процес враховує ризики, ґрунтується на доказах і сумісний із типовими конфігураціями CI.
2. Чому нестабільні тести небезпечні
- Періодичні збої приховують справжні дефекти. Коли тест спочатку завершується невдало, а під час повторного запуску проходить, завдання CI стає «зеленим», хоча перша невдача могла бути спричинена реальним дефектом, наприклад станом гонитви в користувацькому інтерфейсі.
- Команди втрачають довіру до набору тестів. Якщо розробники постійно бачать «нестабільні» попередження, вони починають сприймати всі збійні результати як шум і перестають їх розслідувати.
- Нестабільність збільшує витрати на супровід. Для кожного нестабільного тесту потрібна заявка на тріаж, аналіз першопричини та, можливо, переробка локатора або налаштування тестових даних.
Найпоширеніші причини нестабільності тестів Playwright описано в матеріалах спільноти Playwright; вони також узгоджуються з висновками статті Харі Гокула:
| Категорія | Типовий симптом | Приклад у Playwright |
|---|---|---|
| Проблеми із синхронізацією / стани гонитви | Елемент ще не готовий, раптові затримки мережі | await page.click('#submit') періодично завершується невдало |
| Крихкі селектори | Зміни DOM порушують роботу локаторів CSS/XPath | page.locator('text=Login') перестає бути надійним після оновлення інтерфейсу |
| Нестабільність мережі | Тайм-аути зовнішнього API | Тест завершується невдало, якщо сторонній сервіс працює повільно |
| Спільний стан | Тести забруднюють спільний запис у базі даних або стан сховища | Два паралельні воркери записують дані в той самий файл |
| Відмінності між середовищами | Різні системні шрифти, рендеринг у режимах headless і headed | Візуальний регресійний тест проходить локально, але завершується невдало в CI |
Якщо конвеєр CI просто повторно запускає тест і позначає його як пройдений, докази першої невдачі — консоль браузера, мережеві журнали та скріншоти — зникають. Тоді неможливо визначити, чи була невдача нешкідливим збоєм інфраструктури, чи реальним дефектом.
3. Повторні спроби Playwright: від «зробити збірку зеленою» до діагностичного сигналу
За замовчуванням повторні спроби в Playwright вимкнено. Якщо їх увімкнути, раннер класифікує тест як пройдений, коли він успішний із першої спроби, як нестабільний, коли спочатку він завершується невдало, а під час наступної спроби проходить, і як непройдений, коли невдалими є всі спроби. Ця класифікація має залишатися видимою в CI: повторна спроба не повинна непомітно перетворювати нестабільний результат на звичайний статус «пройдено».
Запис трас потребує свідомого вибору з урахуванням компромісів:
| Режим трасування | Що він записує | Використання під час тріажу |
|---|---|---|
retain-on-failure | Записує кожну спробу та зберігає траси невдалих спроб | Найкращий вибір, коли основним доказом є початкова невдача |
on-first-retry | Записує першу повторну спробу, а не початкову | Дає змогу дослідити новий контекст повторної спроби |
on-all-retries | Записує кожну повторну спробу | Дає змогу порівнювати кілька повторних спроб, але створює більше артефактів |
Жоден із режимів не фіксує одночасно і початкову спробу, і кожну успішну повторну спробу. Виберіть потрібні докази та доповніть їх скріншотами, відео, журналами консолі, мережевими даними й HTML-звітом.
Рекомендована базова конфігурація для CI
// playwright.config.ts
import { defineConfig } from '@playwright/test';

export default defineConfig({
  retries: process.env.CI ? 2 : 0,
  reporter: [['list'], ['html', { open: 'never' }]],
  use: {
    trace: 'retain-on-failure',
    screenshot: 'only-on-failure',
    video: 'retain-on-failure',
  },
  workers: process.env.CI ? 1 : undefined,
  maxFailures: 20,
});
Ця конфігурація зберігає докази невдалих спроб, а повторні спроби залишаються видимими у звіті. Значення 2, 1 і 20 — це приклади робочих налаштувань, а не універсальні рекомендації Playwright. Команда має добирати їх з огляду на тривалість виконання, інфраструктуру та ризики.
4. Збереження доказів першої невдачі
Діагностику потрібно ввімкнути до запуску тесту. Якщо почати трасування в afterEach, відтворити попередні дії в браузері вже неможливо. Вбудованих скріншотів, відео й трас зазвичай достатньо; невелика автоматична фікстура може додатково зберегти повідомлення консолі:
// fixtures.ts
import { test as base } from '@playwright/test';

export const test = base.extend<{ consoleEvidence: void }>({
  consoleEvidence: [async ({ page }, use, testInfo) => {
    const messages: string[] = [];
    page.on('console', message => {
      messages.push(`[${message.type()}] ${message.text()}`);
    });

    await use();

    if (testInfo.status !== testInfo.expectedStatus) {
      await testInfo.attach('console.log', {
        body: Buffer.from(messages.join('\n'), 'utf-8'),
        contentType: 'text/plain',
      });
    }
  }, { auto: true }],
});

export { expect } from '@playwright/test';
За режиму trace: 'retain-on-failure' для першої невдалої спроби зберігається траса. Скріншот, відео, вкладення з повідомленнями консолі та дані звіту утворюють єдиний набір доказів. Якщо команді натомість потрібна траса повторної спроби, використовуйте on-first-retry і задокументуйте, що початкову спробу буде представлено іншими артефактами.
5. Процес тріажу за допомогою ШІ
Нижче наведено процес з урахуванням ризиків і обов’язковою участю людини. ШІ допомагає визначити найімовірнішу першопричину, але жоден потенційно реальний дефект не потрапляє в карантин автоматично.
┌─────────────────────┐
│ Test finishes (CI) │
└───────┬─────────────┘
        │
        ▼
┌─────────────────────┐
│ Did the test retry? │───── No ──► Mark as PASS/FAIL (no AI needed)
└───────┬─────────────┘
        │ Yes
        ▼
┌─────────────────────┐
│ Collect artifacts:  │
│  – retained failure trace│
│  – retry result/report   │
│  – screenshots, logs    │
│  – network HAR (if enabled)│
└───────┬─────────────┘
        │
        ▼
┌─────────────────────┐
│ Feed artifacts to AI│
│ (LLM or specialized│
│  log‑analysis model)│
└───────┬─────────────┘
        │
        ▼
┌─────────────────────┐
│ AI returns:         │
│  • Probable cause   │
│  • Confidence score│
│  • Suggested action│
└───────┬─────────────┘
        │
        ▼
┌─────────────────────┐
│ Human reviewer checks│
│  – confidence threshold │
│  – evidence checklist   │
│  – risk impact          │
└───────┬─────────────┘
        │
   ┌────┴─────┐
   │          │
   ▼          ▼
Quarantine   Fix / Refactor
(only if   (only after human sign‑off)
human confirms)
5.1 Перелік доказів для перевірки людиною
| Позиція | Чому це важливо |
|---|---|
| Збережена траса невдалої спроби | Показує дії браузера та його стан під час невдалої спроби, якщо використано retain-on-failure. |
| Результат повторної спроби та запис у звіті | Підтверджує, чи пройшла наступна спроба, і зберігає класифікацію результату як нестабільного. |
| Журнали консолі й мережі | Допомагають виявити тайм-аути, відповіді з кодом 5xx або винятки JavaScript. |
| Різниця між скріншотами (якщо ввімкнено візуальне порівняння) | Виявляє відмінності рендерингу між режимами headless і headed. |
| Історичні дані запусків (останні 10 запусків) | Допомагають ШІ обчислити показник нестабільності, наприклад частку запусків, яким знадобилася повторна спроба. |
| Метадані тесту (кількість повторних спроб, індекс воркера) | Допомагають виключити проблеми зі спільним станом. |
Перш ніж застосовувати самовідновлення або замінювати селектор, рецензент має відповісти на запитання: «Чи достатньо доказів того, що невдачу спричинила крихкість тесту, а не дефект продукту?»
5.2 Вимірювані показники нестабільності
| Показник | Розрахунок | Інтерпретація |
|---|---|---|
| Частка нестабільних тестів | # тестів, класифікованих як нестабільні / # виконаних тестів | Відстежуйте за набором тестів, гілкою та середовищем; розслідуйте стійке зростання. |
| Частка успішних повторних спроб | # тестів, що пройшли під час повторної спроби / # тестів із повторними спробами | Зростання показника може свідчити про дедалі більшу залежність від повторних спроб. |
| Розподіл часу до невдачі | Тривалість від початку тесту до невдачі в різних запусках | Порівнюйте закономірності; сама лише тривалість не доводить першопричину. |
| Оцінка впевненості ШІ | Визначений моделлю показник із посиланнями на докази | Використовуйте лише для визначення пріоритету ручної перевірки, а не як дозвіл на автоматичне поміщення тесту в карантин. |
Ці показники можна відобразити на інформаційних панелях CI, щоб своєчасно виявляти тенденції.
6. Матриця рішень для тріажу з урахуванням ризику
| Рівень ризику | Характер доказів | Обов’язкова дія |
|---|---|---|
| Низький | Відтворювана проблема в тестовому коді з однозначними доказами та без впливу на продукт | Створити завдання на супровід; рецензент може схвалити виправлення, що стосується лише тесту. |
| Середній | Неоднозначні докази, регулярні повторні спроби або залежність від середовища | Створити заявку на тріаж, зберегти артефакти й відтворити проблему в контрольованих умовах; не поміщати тест у карантин автоматично. |
| Високий | Можливий дефект продукту, ризик для безпеки чи даних або непояснена періодична поведінка | Вважати випадок дефектом, доки не доведено протилежне; заблокувати автоматичне самовідновлення та вимагати перевірки відповідальним за предметну область. |
У матриці навмисно немає універсальних порогових значень у відсотках або рівнів упевненості. Кожна команда має визначати пороги на основі власних базових показників, але невизначеність і значний вплив завжди є підставою для розслідування за участю людини.
7. Безпечні межі автоматизації
| Межа | Обґрунтування |
|---|---|
| Кількість повторних спроб явно обмежено | Більша кількість повторних спроб збільшує витрати й може перетворити нестабільність на норму; точний ліміт визначає команда. |
| Режим трасування вибрано свідомо | retain-on-failure надає пріоритет невдалій спробі; режими, що записують лише повторні спроби, відповідають на інше запитання. |
| Кількість воркерів контролюється | Запуск з одним воркером може допомогти діагностувати брак ресурсів або взаємозалежність через спільний стан, але не усуває дефектів ізоляції. |
| Без автоматичного переписування селекторів | Самовідновлення потребує перевірки; інакше дефект користувацького інтерфейсу може залишитися непоміченим. |
| Термін зберігання артефактів визначає політика | Зберігайте докази достатньо довго для тріажу з урахуванням обмежень щодо сховища, конфіденційності та безпеки. |
8. Конкретні приклади конфігурації Playwright
8.1 Конфігурація лише для CI (змінна середовища CI=true)
// playwright.config.ci.ts
import { defineConfig } from '@playwright/test';

export default defineConfig({
  retries: 2,
  workers: 1,
  maxFailures: 20,
  use: {
    trace: 'retain-on-failure',
    screenshot: 'only-on-failure',
    video: 'retain-on-failure',
    launchOptions: { headless: true },
  },
  reporter: [
    ['list'],
    ['html', { open: 'never', outputFolder: 'playwright-report' }],
  ],
});
8.2 Конфігурація для локальної розробки (без повторних спроб, повне трасування)
// playwright.config.local.ts
import { defineConfig } from '@playwright/test';

export default defineConfig({
  retries: 0,
  workers: undefined, // default based on CPU cores
  use: {
    trace: 'on', // full local trace; expensive for CI
    screenshot: 'on',
    video: 'on',
  },
});
Перемикатися між цими двома файлами можна за допомогою npm-скрипта:
{
  "scripts": {
    "test:ci": "playwright test --config=playwright.config.ci.ts",
    "test:local": "playwright test --config=playwright.config.local.ts"
  }
}
9. Запобіжні механізми за участю людини
- Ніколи не об’єднуйте PR із тестом у карантині без явного схвалення рецензента.
- Вимагайте коментар щодо тріажу, який містить посилання принаймні на один артефакт — трасу, журнал або скріншот — на підтвердження рішення.
- Записуйте кожну пропозицію ШІ у підсумку завдання CI, щоб команда могла перевіряти хибнопозитивні та хибнонегативні висновки.
- Заплануйте періодичний перегляд панелі показників нестабільності, наприклад після кожного спринту, щоб коригувати ліміти повторних спроб або вдосконалювати структуру тестів.
Ці кроки забезпечують прозорість процесу й запобігають пастці «самовідновлення», коли ШІ непомітно виправляє кожен нестабільний тест без перевірки людиною.
10. П’ять конкретних запитань для оцінювання ШІ-агента з тріажу нестабільних тестів
- На яких вихідних даних ШІ ґрунтує свої висновки? Перевірте, чи аналізує він необроблені траси Playwright, журнали консолі, мережеві дані та історію запусків, чи лише попередньо оброблений зведений звіт.
- Як модель відображає невизначеність? Вимагайте каліброваної оцінки невизначеності з посиланнями на докази: саме по собі числове значення впевненості нічого не доводить.
- Чи може ШІ визначити точний крок, який відрізнявся між невдалою спробою та повторним запуском? Відповідь має посилатися на конкретну дію або артефакт, а не містити лише загальне формулювання на кшталт «проблема із синхронізацією».
- Який журнал аудиту ведеться для запропонованої дії із самовідновлення? Фіксуйте початковий локатор або поведінку, запропоновану зміну та докази на її підтвердження.
- Як ШІ обробляє випадки з невідомою причиною? Він має передавати їх на ручну перевірку, а не автоматично поміщати тест у карантин чи застосовувати виправлення.
Ці запитання допомагають керівникам QA переконатися, що ШІ є інструментом підтримки рішень, а не тим, хто їх ухвалює.
11. У яких випадках автоматизація допомагає
- Швидкий збір даних — вбудовані засоби Playwright для трасування, створення скріншотів і запису HAR надають детермінований знімок стану, який було б складно зібрати вручну.
- Розпізнавання закономірностей — великі мовні моделі добре зіставляють повідомлення про помилки з багатьох запусків і виявляють повторювані мережеві тайм-аути або дрейф селекторів, які людина може не помітити.
- Визначення пріоритетів — оцінюючи ймовірність нестабільності, ШІ може насамперед виявляти найризикованіші нестабільні тести, щоб команда спрямувала обмежені ресурси на найважливіші випадки.
- Послідовна звітність — автоматизовані завдання CI створюють уніфіковані набори артефактів, що забезпечує відтворюваність аналізу після інциденту.
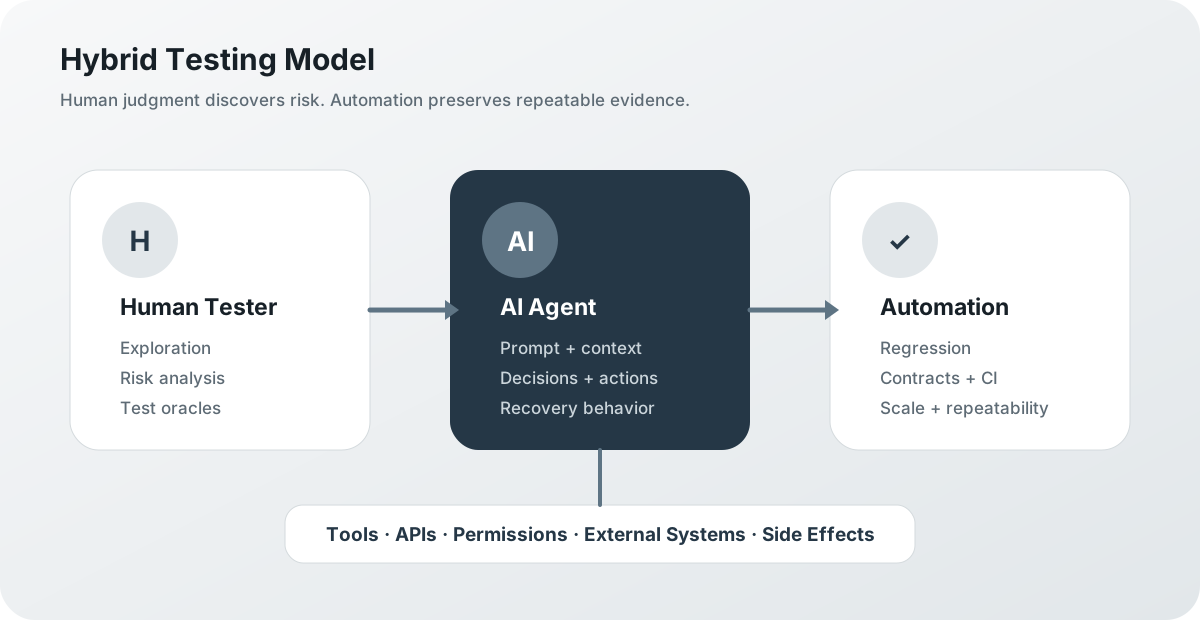
Отже, автоматизація є мультиплікатором ефективності: вона збирає докази, ШІ допомагає їх інтерпретувати, а остаточне рішення ухвалює людина.
12. Висновок
Нестабільні тести Playwright не мають ставати прихованою загрозою для якості продукту. Завдяки продуманому налаштуванню повторних спроб, фіксації стану першої невдачі та передаванню всіх артефактів у конвеєр тріажу за допомогою ШІ команди можуть відрізняти справжні дефекти від крихкості тестового коду. Описаний процес зберігає критично важливі докази, кількісно оцінює нестабільність і застосовує матрицю рішень на основі ризиків, яка завжди вимагає схвалення людиною перед самовідновленням або поміщенням тесту в карантин. За відповідального використання автоматизація та ШІ стають потужними союзниками в підтриманні надійного набору тестів, водночас залишаючи ручне й дослідницьке тестування в основі забезпечення якості.
Джерела
- Hari Gokul — Why Flaky Tests Are More Dangerous Than Failed Tests
- Документація Playwright — Retries
- Документація Playwright — Trace Viewer
- Документація Playwright — Reporters
Для фактичних тверджень використано лише вихідну статтю та офіційну документацію Playwright.
Залишити коментар
Поділіться думкою про статтю. Реєстрація не потрібна.
Коментарі
Завантаження коментарів…