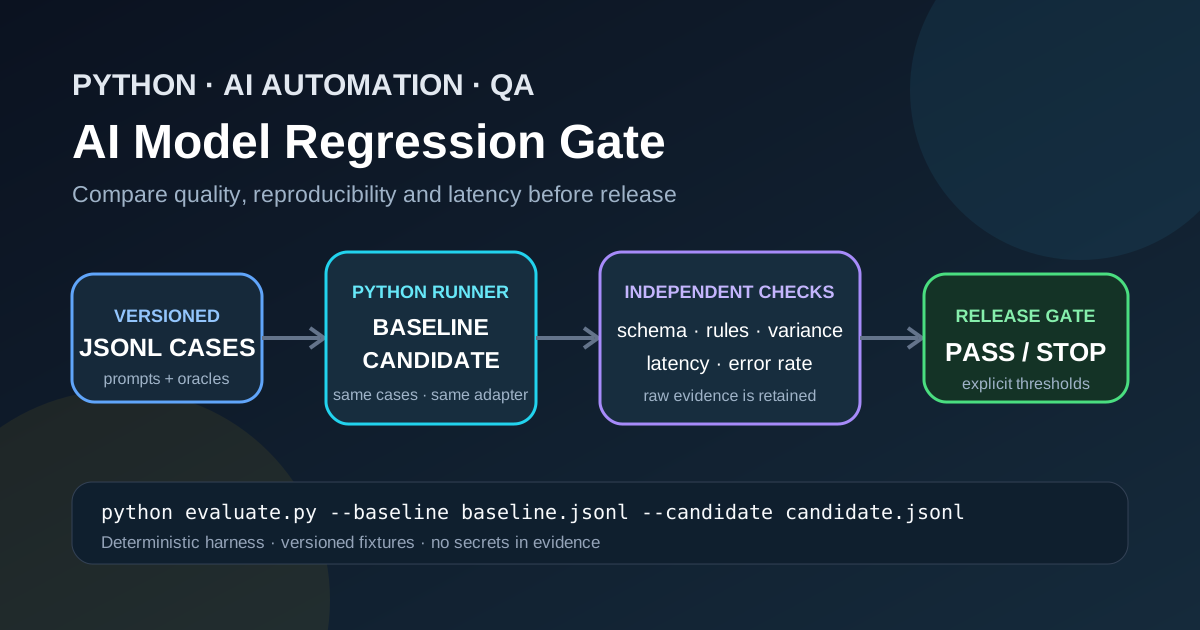
Изменение модели ИИ, шаблона промпта, температуры, определения инструмента или конфигурации поиска может изменить поведение системы без изменений в коде приложения. Поэтому успешное прохождение модульных тестов не доказывает безопасность новой конфигурации. Практический контрольный этап релиза должен сравнивать кандидата с известной базовой версией на одних и тех же версионируемых тест-кейсах и сохранять достаточно доказательств, чтобы можно было объяснить каждое решение.
В статье создаётся небольшой независимый от провайдера гейт на Python. Он проверяет структуру JSON и бизнес-правила, повторяет тест-кейсы для выявления нестабильности, измеряет задержку, сравнивает метрики кандидата с базовой версией и возвращает ненулевой код завершения при превышении согласованного бюджета регрессии. Гейт не обращается к конкретному коммерческому API и не содержит учётных данных.
1. Определите правила принятия решения до написания скрипта
Начните с явной политики релиза. Например:
- каждый ответ должен быть допустимым JSON и соответствовать схеме своего тест-кейса;
- детерминированные бизнес-правила должны выполняться при каждом запуске;
- доля успешных проверок кандидата не должна быть ниже, чем у базовой версии;
- задержка p95 кандидата может превышать показатель базовой версии не более чем на 20% и не должна превышать абсолютный предел;
- транспортные ошибки, тайм-ауты и ограничения частоты запросов регистрируются отдельно от ошибок качества;
- специалист проверяет фиксированную выборку ответов с точки зрения смысла, тона и потенциального вреда.
Последний пункт особенно важен. Валидация схемы может доказать наличие поля, но не может подтвердить правильность рекомендации или сохранение важных фактов в кратком изложении. Автоматизированные оракулы и экспертная оценка отвечают на разные вопросы.
2. Версионируйте тест-кейсы и ожидаемое поведение
Формат JSON Lines хорошо подходит для небольшого набора оценочных данных: каждая строка представляет собой отдельный объект JSON. Храните промпты, правила и идентификаторы тест-кейсов в системе контроля версий.
{"case_id":"ticket-001","prompt":"Classify: Payment failed twice","schema":{"type":"object","required":["category","priority"],"properties":{"category":{"type":"string","enum":["billing","technical","other"]},"priority":{"type":"string","enum":["low","medium","high"]}},"additionalProperties":false},"contains":["billing"]}
{"case_id":"ticket-002","prompt":"Classify: How do I change my password?","schema":{"type":"object","required":["category","priority"],"properties":{"category":{"type":"string"},"priority":{"type":"string"}},"additionalProperties":false},"contains":["technical"]}
Изменение промпта или оракула означает изменение тестового артефакта. Сохраняйте хеш коммита Git и стабильный хеш тест-кейса, чтобы при последующем расследовании можно было точно воспроизвести данные, которые оценивал гейт.
В документации Python по модулю json указано, что обработка недоверенных данных JSON может потреблять значительные ресурсы процессора или памяти. Ограничивайте размер файла и каждой строки до начала разбора.
import hashlib
import json
from pathlib import Path
from typing import Any

MAX_FILE_BYTES = 1_000_000
MAX_LINE_BYTES = 16_384

def load_cases(path: Path) -> list[dict[str, Any]]:
    if path.stat().st_size > MAX_FILE_BYTES:
        raise ValueError("case file is too large")

    cases: list[dict[str, Any]] = []
    with path.open(encoding="utf-8") as source:
        for number, line in enumerate(source, start=1):
            if not line.strip():
                continue
            if len(line.encode("utf-8")) > MAX_LINE_BYTES:
                raise ValueError(f"line {number} is too large")
            case = json.loads(line)
            if not {"case_id", "prompt", "schema"} <= case.keys():
                raise ValueError(f"line {number} misses required case fields")
            cases.append(case)
    return cases

def case_hash(case: dict[str, Any]) -> str:
    canonical = json.dumps(case, sort_keys=True, separators=(",", ":"))
    return hashlib.sha256(canonical.encode("utf-8")).hexdigest()
3. Скройте провайдера за адаптером
Гейт не должен зависеть от того, поступает ли модель из размещённого API, локального сервера или под-процесса n8n. Скрипту нужен единый вызываемый контракт: на входе текст, на выходе разобранный словарь. Адаптер отвечает за аутентификацию, обработку тайм-аутов, разбор ответа и параметры конкретного провайдера.
Не записывайте в журнал заголовки авторизации или исходные промпты с персональными данными. Получайте секреты из переменных окружения или хранилища секретов CI, маскируйте конфиденциальные поля ответа и сохраняйте только те доказательства, которые необходимы для диагностики.
Используйте time.perf_counter() для измерения прошедшего времени. В документации Python эта функция описана как высокоточный счётчик производительности, подходящий для измерения коротких интервалов.
import time
from collections.abc import Callable

ModelCall = Callable[[str], dict[str, Any]]

def timed_call(call: ModelCall, prompt: str) -> tuple[dict[str, Any], float]:
    started = time.perf_counter()
    result = call(prompt)
    return result, time.perf_counter() - started
4. Применяйте независимые детерминированные оракулы
JSON Schema проверяет контракт ответа. Пакет Python jsonschema предоставляет версионированные валидаторы, включая Draft202012Validator, и метод iter_errors. Перед использованием проверяйте корректность самой схемы, иначе ошибочный тестовый оракул может привести к недостоверным результатам.
import re
from jsonschema import Draft202012Validator

def deterministic_errors(output: dict[str, Any], case: dict[str, Any]) -> list[str]:
    schema = case["schema"]
    Draft202012Validator.check_schema(schema)
    validator = Draft202012Validator(schema)

    errors = [error.message for error in validator.iter_errors(output)]
    rendered = json.dumps(output, ensure_ascii=False)

    for fragment in case.get("contains", []):
        if fragment.casefold() not in rendered.casefold():
            errors.append(f"missing required fragment: {fragment}")

    pattern = case.get("regex")
    if pattern and re.search(pattern, rendered) is None:
        errors.append("response does not match the required regex")

    return errors
Эти проверки независимы, поскольку модель-кандидат не определяет, прошла ли она проверку. Оценивание с помощью модели может быть полезно для анализа стиля или семантического сходства, но его следует выводить как отдельный сигнал с собственной калибровкой и процедурой проверки, а не незаметно смешивать с детерминированной логикой «пройдено/не пройдено».
5. Повторяйте тест-кейсы и рассчитывайте сопоставимые метрики
Один успешный вызов скрывает вариативность. Выполняйте каждый тест-кейс несколько раз с одинаковой конфигурацией базовой версии и кандидата. Регистрируйте каждую категорию ошибок, а не повторяйте запросы без следа до получения успешного результата. Ограниченные повторные попытки могут быть уместны для ответов HTTP 429 или отдельных ошибок 5xx, но первоначальная ошибка и число повторов должны оставаться частью доказательств.
Для небольшой наблюдаемой выборки инклюзивный метод вычисления перцентиля сохраняет значение p95 между минимумом и максимумом выборки. Документация Python по statistics.quantiles различает инклюзивный и эксклюзивный методы.
from statistics import quantiles

def evaluate(call: ModelCall, cases: list[dict[str, Any]], repeats: int = 5) -> dict:
    latencies: list[float] = []
    passed = 0
    total = 0
    evidence: list[dict[str, Any]] = []

    for case in cases:
        for run_number in range(1, repeats + 1):
            total += 1
            try:
                output, elapsed = timed_call(call, case["prompt"])
                problems = deterministic_errors(output, case)
                latencies.append(elapsed)
                passed += int(not problems)
                evidence.append({
                    "case_id": case["case_id"],
                    "case_hash": case_hash(case),
                    "run": run_number,
                    "elapsed_s": round(elapsed, 4),
                    "problems": problems,
                })
            except Exception as exc:
                evidence.append({
                    "case_id": case["case_id"],
                    "case_hash": case_hash(case),
                    "run": run_number,
                    "error_type": type(exc).__name__,
                })

    p95 = quantiles(latencies, n=100, method="inclusive")[94] if len(latencies) >= 2 else (latencies[0] if latencies else float("inf"))
    return {"pass_rate": passed / total, "p95_s": p95, "evidence": evidence}
Для стохастического текста точные хеши ответов обычно измеряют идентичность, а не правильность. Предпочитайте повторные результаты оракулов и откалиброванную семантическую или экспертную оценку. Если провайдер предоставляет начальное значение генератора случайных чисел, сохраняйте его, но не обещайте воспроизводимость, которой провайдер не гарантирует.
6. Сравнивайте базовую версию и кандидата по явным бюджетам
Гейт должен сравнивать сопоставимые условия: один набор тест-кейсов, один контракт адаптера, одинаковое число повторов, одинаковый тайм-аут и одну среду выполнения.
def release_allowed(baseline: dict, candidate: dict) -> tuple[bool, list[str]]:
    reasons: list[str] = []

    if candidate["pass_rate"] < baseline["pass_rate"]:
        reasons.append("candidate pass rate is below baseline")

    absolute_limit_s = 2.0
    relative_limit_s = baseline["p95_s"] * 1.20
    if candidate["p95_s"] > min(absolute_limit_s, relative_limit_s):
        reasons.append("candidate p95 latency exceeds the regression budget")

    return not reasons, reasons
Выбирайте пороговые значения с учётом продуктового риска и реальных исторических данных. Классификатор обращений по вопросам платежей и внутренний инструмент для мозгового штурма не должны использовать одну и ту же политику релиза.
Сохраняйте очищенный отчёт JSON с идентификаторами модели и конфигурации, коммитом набора тест-кейсов, хешами, числом повторов, сведениями о среде, метриками, сбоями и итоговым решением. Не сохраняйте секреты или ненужные данные клиентов.
7. Повторно используйте тест-кейсы с pytest
Декоратор @pytest.mark.parametrize запускает один тест с несколькими наборами аргументов. В документации pytest также указано, что значения параметров передаются без копирования. Поэтому изменение словаря может повлиять на последующие вызовы. Загружайте неизменяемые тестовые данные во время сбора тестов и не модифицируйте их.
import os
import pytest

CASES = load_cases(Path("tests/cases.jsonl"))

@pytest.fixture
def candidate_model():
    return build_model_adapter(
        endpoint=os.environ["CANDIDATE_ENDPOINT"],
        token=os.environ["CANDIDATE_TOKEN"],
    )

@pytest.mark.parametrize("case", CASES, ids=lambda case: case["case_id"])
def test_candidate_contract(case, candidate_model):
    output, _ = timed_call(candidate_model, case["prompt"])
    assert deterministic_errors(output, case) == []
Полный скрипт сравнения можно запускать отдельной командой CI. Если release_allowed возвращает false, выведите краткие причины и завершите процесс с кодом 1. Так GitHub Actions, Jenkins, Azure DevOps или n8n получат однозначный машиночитаемый результат контрольной проверки.
8. Обработка сбоев и доказательства
Разделяйте типы сбоев:
- ошибка валидации означает, что ответ нарушил известный контракт;
- транспортная ошибка означает, что вызов провайдера не завершился;
- тайм-ауты и события ограничения частоты запросов указывают на риск доступности или недостаточной пропускной способности;
- ошибки инфраструктуры означают, что сама оценка ненадёжна;
- ошибка семантической проверки означает, что структура прошла проверку, но смысл — нет.
Для релиза с высоким риском по умолчанию блокируйте продвижение, если доказательств недостаточно. Для эксперимента с низким риском команда может выбрать предупреждение, но это решение должно быть явно зафиксировано в политике, а не скрыто в коде.
9. Чек-лист релиза
- Убедитесь, что набор тест-кейсов, схемы, промпты и пороговые значения проверены и версионируются.
- Запустите базовую версию и кандидата с одинаковой конфигурацией и в одинаковой среде.
- Убедитесь, что секреты передаются безопасно, а конфиденциальные данные в журналах маскируются.
- Проанализируйте детерминированные ошибки, транспортные сбои, повторные попытки, изменение доли успешных проверок и задержку p95.
- Проверьте обязательную выборку вручную: оцените фактическую точность, безопасность и влияние на пользователей.
- Сохраните очищенный отчёт вместе с идентификаторами коммита и конфигурации.
- Продвигайте кандидата только после успешного прохождения всех обязательных контрольных проверок.
10. Устранение неполадок
Если каждый тест-кейс не проходит валидацию схемы, сначала проверьте саму схему и убедитесь, что адаптер преобразовал ответ провайдера в ожидаемый объект. Если задержка p95 резко выросла, отделите ограничение частоты запросов со стороны провайдера от изменений приложения и выполняйте сравнение в одинаковой среде. Если результаты различаются при нулевой температуре, считайте эту вариативность наблюдаемым поведением: нулевая температура не гарантирует детерминизм для всех систем. Если CI не может прочитать секрет, проверьте его имя и область действия, не выводя значение. Если разбор JSONL завершается ошибкой, проверяйте строки по одной и сообщайте только номер строки, не раскрывая конфиденциальное содержимое.
Заключение
Регрессионный гейт на Python превращает изменение модели ИИ в инженерное решение, которое можно проверить. Версионируемые тест-кейсы обеспечивают трассируемость, независимые оракулы проверяют контракты, повторные запуски выявляют нестабильность, бюджеты задержки защищают пользовательский опыт, а ненулевой код завершения блокирует небезопасное продвижение. Гейт наиболее надёжен, когда его ограничения сформулированы явно: детерминированная автоматизация доказывает только то, что измеряют её оракулы, а семантическое качество и бизнес-риски по-прежнему требуют откалиброванной оценки и экспертного суждения.
Оставить комментарий
Поделитесь своим мнением о статье. Регистрация не требуется.
Комментарии
Загрузка комментариев…