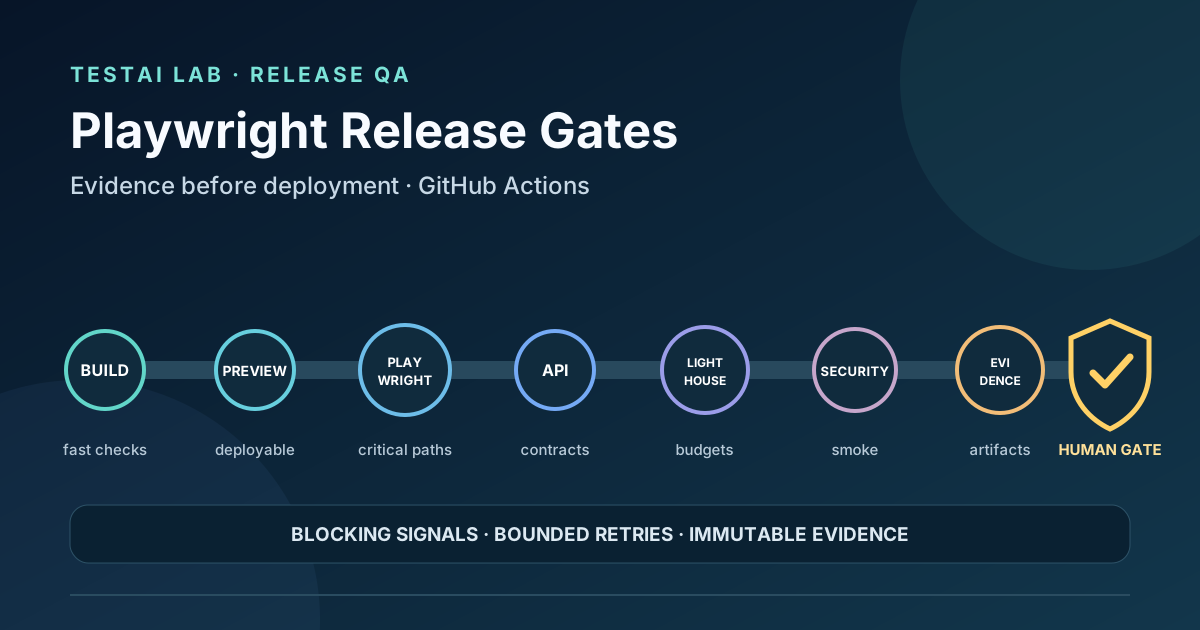
Как заменить расплывчатое утверждение «качество проверено на 100 %» конкретным, пригодным для аудита конвейером контрольных этапов выпуска.
Введение
Каждая команда, выпускающая веб-приложение, хочет быть уверенной, что код работает для реальных пользователей. Маркетинговые тексты часто сводят эту уверенность к слогану вроде "100 % QA-протестировано". Фраза привлекательна, но она не описывает что было протестировано, как обнаруживаются сбои или какие доказательства сохраняются для последующего рассмотрения.
Более оправданный подход — рассматривать сам конвейер CI/CD как серию контрольных этапов выпуска. Каждый гейт имеет детерминированный критерий прохождения/отказа, производит неизменные доказательства и ограничен на определённую поверхность риска. Когда гейт выходит из строя, конвейер останавливается; когда он проходит, запускается следующий гейт. Последний гейт — это явное человеческое решение, которое поглощает накопленные доказательства.
Ниже приведён практический дизайн небольшого веб-приложения (например, сайта с каталогом продуктов), реализующего восемь элементов в GitHub Actions. Дизайн основан на официальной документации Playwright, GitHub Actions, Lighthouse CI и OWASP ZAP, а также показывает, как сохранять нестандартные тесты честными, сохранять следы и не допускать решения о выпуске сводки, созданной ИИ.
Проблема с утверждением «качество проверено на 100 %»
- Непроверяемый обхват – «100 %» ничего не говорит о том, какие пользовательские маршруты, API или нефункциональные требования были охвачены.
- Нет доказательств – Без артефактов (скриншотов, журналов, отчётов) заявление не может быть проверено после рассмотрения.
- Мышление «всё или ничего» – Команды могут рассматривать одну зелёную проверку как общее одобрение, игнорируя нюансы консультативных выводов (например, предупреждение о производительности, не блокирующее выпуск).
Замена слогана на модель, основанную на доказательствах, заставляет команду ответить на три вопроса для каждого выхода:
- Какой риск несёт гейт?
- Какое детерминированное условие определяет сдвиг/неуспех?
- Какие артефакты хранятся для последующего аудита?
Следующие разделы проходят через каждую врату, какие сигналы они могут доказать, их пределы и практические шаги, необходимые для их обеспечения.
Проектирование конвейера контрольных этапов выпуска, основанного на доказательствах
Конвейер визуализируется как линейная цепочка, но GitHub Actions позволяет параллельное выполнение, где зависимости выражаются needs. Восемь элементов следующие:
- Сборка с неудачей и проверка юнитов
- Предварительный обзор развертывания
- Тесты критических пользовательских сценариев в Playwright (настольная и мобильная версии)
- Валидация контракта API
- Бюджеты доступности и производительности (Lighthouse CI)
- Лёгкий дым безопасности (OWASP ZAP)
- Артефакты неизменных доказательств
- Явное одобрение на освобождение человека
Каждый гейт создаёт блокирующий сигнал (должен быть зелёным для продолжения) или предупредительный сигнал (записанный, но не останавливает конвейер). Это различие кодируется в рабочем процессе с помощью continue-on-error: true для консультационных заданий и публикуя их отчеты в виде артефактов.
Ворота 1 – Быстрая сборка и проверка юнит‑тестов
Что это доказывает – Исходный код компиляцир, линтинг проходит, а модульные тесты реализуют основную логику.
Что он не может доказать – поведение интеграции, рендеринг интерфейса или производительность под нагрузкой.
Реализация
name: CI
on:
  push:
    branches: [main]
  pull_request:

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Set up Node
        uses: actions/setup-node@v4
        with:
          node-version: '20'
      - name: Install dependencies
        run: npm ci
      - name: Lint
        run: npm run lint
      - name: Unit tests
        run: npm test -- --ci --reporter=dot
      - name: Upload unit report
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: unit-report
          path: coverage/
Задание проваливается при любом ненулевом выходном коде, что гарантирует блокирующий результат.
Политика повторных попыток – Повторные попытки не настраиваются; неудачный модульный тест — это жёсткая остановка. Нестабильные модульные тесты следует исправлять до того, как они достигнут CI.
Ворота 2 – Предварительное развертывание
Кратковременная среда предварительного просмотра (например, GitHub Pages, предварительный просмотр Vercel или Docker-контейнер на самостоятельно размещённом раннере) подтверждает, что артефакты сборки могут быть обслужины.
Что это доказывает – Скрипт развертывания работает, статические ассеты доступны, а переменные среды введены корректно.
То, чего она не может доказать – Функциональная корректность потоков интерфейса.
Реализация (упрощённая)
  preview:
    runs-on: ubuntu-latest
    needs: build
    outputs:
      preview_url: ${{ steps.deploy.outputs.preview_url }}
    steps:
      - uses: actions/checkout@v4
      - name: Deploy preview
        id: deploy
        run: |
          PREVIEW_URL="$(./scripts/deploy-preview.sh)"
          echo "preview_url=$PREVIEW_URL" >> "$GITHUB_OUTPUT"
      - name: Wait for health endpoint
        env:
          PREVIEW_URL: ${{ steps.deploy.outputs.preview_url }}
        run: |
          for i in {1..30}; do
            curl -sf "$PREVIEW_URL/health" && exit 0
            sleep 1
          done
          exit 1
Задание предварительного развертывания должно возвращать реальный URL, доступный извне, как выходное значение задания. $GITHUB_ENV действует только внутри одного задания, а фоновый сервер на размещённом исполнителе GitHub не продолжает работу в другом задании. Поэтому последующие задания читают ${{ needs.preview.outputs.preview_url }}. Если развёртывание или ограниченная проверка состояния завершается ошибкой, конвейер останавливается.
Ворота 3 — Критические тесты Playwright для настольной и мобильной версий
Официальное руководство Playwright по CI описывает, как запускать браузеры в режиме headless внутри GitHub Actions. Критические процессы (например, «поиск → детали продукта → добавление в корзину») выполняются как на рабочем столе, так и на мобильной эмуляции.
Что это доказывает – Сквозный функциональный поток работает в целевых браузерах, селекторы стабильны, а ключевые элементы интерфейса отображаются.
Что он не может доказать – полное кросс-браузерное покрытие (только те браузеры, которые вы запускаете), производительность в реальных сетевых условиях или безопасность.
Блокирующие и рекомендательные результаты – Функциональные ошибки Playwright являются блокирующими. Неудачная проверка expect.soft позволяет текущему тесту продолжиться, но Playwright всё равно помечает тест как failed. Если визуальное сравнение должно быть рекомендательным, запускайте его в отдельном job или шаге с явной политикой continue-on-error: true и сохраняйте отчёт.
Пример Playwright TypeScript
import { test, expect } from '@playwright/test';

test.describe('Critical purchase journey', () => {
  // Run on both desktop and mobile
  test.use({
    viewport: { width: 1280, height: 720 },
    userAgent: 'desktop',
  });

  test('Desktop flow', async ({ page }) => {
    await page.goto(process.env.PREVIEW_URL!);
    await page.fill('#search', 'widget');
    await page.press('#search', 'Enter');
    await page.click('text=Widget Pro');
    await page.click('button#add-to-cart');

    // Soft assertion: continue collecting evidence, but the test still fails
    await expect(page.locator('#cart-count')).toHaveText('1', { timeout: 5000 });
    await expect.soft(page).toHaveScreenshot('cart-desktop.png');
  });

  test.use({
    viewport: { width: 375, height: 667 },
    deviceScaleFactor: 2,
    isMobile: true,
    userAgent: 'mobile',
  });

  test('Mobile flow', async ({ page }) => {
    await page.goto(process.env.PREVIEW_URL!);
    await page.tap('#search');
    await page.fill('#search', 'widget');
    await page.press('#search', 'Enter');
    await page.tap('text=Widget Pro');
    await page.tap('button#add-to-cart');

    await expect(page.locator('#cart-count')).toHaveText('1');
    await expect.soft(page).toHaveScreenshot('cart-mobile.png');
  });
});
Ключевые моменты
process.env.PREVIEW_URLвводится из предварительного просмотра.expect.softпродолжает тест после неудачной проверки, но итоговый статус теста остаётся failed; само по себе это не рекомендательный сигнал выпуска.- Скриншоты автоматически загружаются как артефакты (см.
upload-artifactэтап в рабочем процессе).
Защита от нестабильных тестов – Повторные попытки Playwright явно настраиваются в playwright.config.ts или соответствующим флагом командной строки. По умолчанию повторов нет. В этом примере их количество равно нулю, поэтому первая ошибка блокирует контрольный этап; если разрешён один повтор для сбора доказательств, его нужно настроить явно и помечать результат как нестабильный, не скрывая первую ошибку.
Ворота 4 – Проверка контракта API
Использование инструмента для тестирования контрактов (например, валидатора OpenAPI) гарантирует, что ответы на сервер соответствуют опубликованной схеме.
Что это доказывает – Контракт API соблюдается для реализованных конечных точек.
То, что он не может доказать – Корректность бизнес-логики за пределами схемы или производительность под нагрузкой.
Реализация
  api-contract:
    runs-on: ubuntu-latest
    needs: preview
    steps:
      - uses: actions/checkout@v4
      - name: Install validator
        run: npm ci
      - name: Run contract tests
        env:
          BASE_URL: ${{ needs.preview.outputs.preview_url }}
        run: npm run contract:test
      - name: Upload contract report
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: contract-report
          path: contract-report/
Скрипт теста контракта должен завершиться с ненулевой статусом при любом нарушении схемы, делая гейт блокирующим.
Ворота 5 – Бюджеты доступности и производительности (Lighthouse CI)
Lighthouse CI можно запускать по URL предварительного просмотра для обеспечения пороговых норм бюджета по доступности, производительности и лучшим практикам. Официальная документация Lighthouse CI описывает, как настроить бюджеты в lighthouserc.json файле.
Что это доказывает – Страница соответствует определённым количественным порогам (например, балл доступности ≥ 90, первое содержание ≤ 1,5 с).
То, что он не может доказать – Субъективные проблемы удобства использования или реальная изменчивость сети за пределами смоделированных условий.
Реализация
  lighthouse:
    runs-on: ubuntu-latest
    needs: preview
    steps:
      - uses: actions/checkout@v4
      - name: Install Lighthouse CI
        run: npm ci && npm install -g @lhci/cli@0
      - name: Run LHCI
        env:
          LHCI_BUILD_CONTEXT__CURRENT_BRANCH: ${{ github.ref_name }}
          LHCI_BUILD_CONTEXT__GITHUB_PULL_REQUEST: ${{ github.event.pull_request.number }}
        run: |
          lhci collect --url=${{ needs.preview.outputs.preview_url }} --numberOfRuns=3
          lhci assert --config=./lighthouserc.json
      - name: Upload LHCI report
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: lighthouse-report
          path: .lhci/
Этап lhci assert не выполняет задание, если бюджет нарушен, и ворота становятся блокирующими. Консультативные выводы (например, предупреждение о производительности, которое всё ещё превышает бюджет) можно зафиксировать, опустив assert шаг и загрузив только отчёт.
Ворота 6 – Лёгкий smoke‑test безопасности (OWASP ZAP)
Запуск быстрого сканирования с базовым сканированием OWASP ZAP обеспечивает раннее выявление распространённых уязвимостей (например, отсутствующих заголовков безопасности).
Что это доказывает – Развернутый предпросмотр не содержит явных ошибок в безопасности.
То, что он не может доказать – Комплексное тестирование на проникновение или эксплойты нулевого дня.
Реализация
  zap:
    runs-on: ubuntu-latest
    needs: preview
    steps:
      - uses: actions/checkout@v4
      - name: Baseline scan
        env:
          ZAP_TARGET: ${{ needs.preview.outputs.preview_url }}
        run: |
          docker run --rm -v "$PWD:/zap/wrk:rw" -t ghcr.io/zaproxy/zaproxy:stable \
            zap-baseline.py -t "$ZAP_TARGET" -c /zap/wrk/zap-rules.conf \
            -r zap-report.html -I
      - name: Upload ZAP report
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: zap-report
          path: zap-report.html
С флагом -I результаты WARN не проваливают job. Правила, отмеченные как FAIL в zap-rules.conf, возвращают код 1 и блокируют гейт; код 3 означает другую операционную ошибку. Такая конфигурация задаёт явную политику и не превращает каждое предупреждение в блокировку выпуска.
Ворота 7 – Артефакты неизменных доказательств
Все предшествующие ворота загружают свои артефакты (покрытие юнитов, скриншоты Playwright, отчёты по контрактам, Lighthouse JSON, ZAP HTML). Артефакты хранятся в хранилище артефактов GitHub, которое неизменно на протяжении всего рабочего процесса.
Почему это важно – Аудиторы, менеджеры по освобождению или будущие следователи могут получить те самые доказательства, которые оправдывали решение об освобождении. Артефакты также служат базой для регрессионного анализа.
  archive-evidence:
    runs-on: ubuntu-latest
    needs: [build, preview, playwright, api-contract, lighthouse, zap]
    if: always()
    steps:
      - name: Gather all artefacts
        run: echo "All artefacts already uploaded by individual jobs."
Работа archive-evidence не приводит к созданию новых артефактов, но гарантирует, что конвейер выходит из строя только после того, как все доказательства будут безопасно сохранены.
Ворота 8 – Явное человеческое одобрение релиза
Последний гейт — это инструкция шаг одобрения, который представляет сводку собранных доказательств. Решение о продвижении предварительного просмотра в производство принимает назначенный менеджер по релизу или владельцу продукта.
Реализация
  approve:
    runs-on: ubuntu-latest
    needs: archive-evidence
    environment:
      name: production
      url: ${{ needs.preview.outputs.preview_url }}
    steps:
      - name: Request approval
        uses: peter-evans/repository-dispatch@v2
        with:
          token: ${{ secrets.GITHUB_TOKEN }}
          event-type: release-approval
          client-payload: |
            {
              "preview_url": "${{ needs.preview.outputs.preview_url }}",
              "artifacts": [
                "unit-report",
                "playwright-screenshots",
                "contract-report",
                "lighthouse-report",
                "zap-report"
              ]
            }
Правила защиты environment в GitHub можно настроить так, чтобы требовать рецензента. Рецензент проверяет артефакты через интерфейс GitHub, подтверждает, что все **блокирующие элементы прошли, и затем нажимает «Одобрить и развернуть». Конвейер затем переходит к заданию развертывания в производстве (не показано).
Управление нестабильными тестами и ограниченными повторными попытками
- Нет неявных повторов – GitHub Actions не повторяет неудачные шаги автоматически, а Playwright по умолчанию использует ноль повторов. Количество задаётся в конфигурации Playwright или соответствующим флагом командной строки; произвольное поле матрицы не меняет поведение средства запуска тестов.
- Отделяйте рекомендательные результаты –
expect.softпозволяет выполнить последующие проверки, но всё равно завершает тест со статусом failed. Рекомендательные визуальные проверки должны выполняться в явно неблокирующем job или шаге, а их артефакты — сохраняться для анализа. - Тайм-ауты и повторные попытки на уровне теста – Повторные попытки
test.setTimeoutи на каждом шагу Playwright могут использоваться умеренно; любое количество повторов превышает один должен быть помечен для расследования.
Сохранение доступности доказательств
- Именование артефактов – Используйте чёткие, версионные имена (например,
playwright-screenshots-${{ github.sha }}). - Политика удержания – GitHub по умолчанию сохраняет артефакты в течение 90 дней; корректируя
retention-daysрабочего процесса, если требуются более длинные аудиторские следы. - Ссылка из интерфейса одобрения – На этапе ручного одобрения можно показывать сводку с разметкой, которая напрямую ссылается на каждый артефакт, что гарантирует обзорам один клик для просмотра доказательств.
Избегание ИИ‑сгенерированных сводок в качестве решений о выпуске
Автоматизация может сгенерировать краткое резюме разметки по забегу (например, с помощью actions/github-script). Хотя это удобно, эта сводка никогда не должна заменять ручной ворота одобрения. Чтобы не допустить, чтобы значок, созданный ИИ, стал фактическим пунктом принятия решения:
- Требуется защищённая среда с хотя бы одним человеком-рецензентом.
- Не ограничивайте развертывание продакшна на проверку статуса, которую бот может переопределить.
- Храните сводку ИИ как артефакт только для справки.
Отделяя человеческие ворота от автоматического значка, команда сохраняет ответственность и избегает иллюзии «полной автоматизации».
Где помогает автоматизация
| поверхность | Прочность автоматизации | Оставшееся человеческое суждение |
|---|---|---|
| Сборка и модульные тесты | Быстрый, детерминированный, повторяющийся. | Определение адекватного покрытия теста. |
| Предпросмотр развертывания | Гарантирует, что артефакты сборки можно будет обслуживать. | Оценка конфигурации, специфической для окружающей среды. |
| Критические путешествия Playwrightа | Обнаруживает регрессии в основных пользовательских потоках между браузерами. | Оценка качества UI/UX, выходящих за рамки функциональной корректности. |
| Проверки контрактов API | Автоматически обеспечивает соответствие схемы. | Определение, допустимы ли изменения в контракте. |
| Бюджеты маяков | Количественно оценивает пороги производительности и доступности. | Интерпретация компромиссов, когда бюджет немного пропущен. |
| Сканирование дыма безопасности | Рано замечает очевидные ошибки в настройках. | Проведение глубоких оценок безопасности. |
| Архив доказательств | Неизменное хранение журналов, скриншотов, отчётов. | Аудит и посмертный анализ. |
| Человеческое одобрение | Предоставляет единую, проверяемую точку принятия решения. | Взвешивание влияния на бизнес, сроки выпуска и толерантность к риску. |
Автоматизация превосходно справляется с обнаружением отклонений от определённых ожиданий; люди отлично интерпретируют значимость этих отклонений.
Вопросы для самопроверки
- Что отличает блокирующий элемент от консультативного вывода и как это выражается в рабочем процессе GitHub Actions?
- Почему
expect.softвсё равно приводит к статусу failed и как отделить рекомендательную визуальную проверку от блокирующего Playwright-гейта? - Какие артефакты загружаются после задания Lighthouse CI, и какое бюджетное условие приводит к провалу работы?
- Как базовое сканирование ZAP OWASP влияет на защитный гейт, и какой статус выхода указывает на сбой блокировки?
- Какие меры препятствуют тому, чтобы сводка, созданная ИИ, стала единственным решением о выпуске?
Заключение
Замена маркетингового утверждения «качество проверено на 100 %» на основанный на доказательствах конвейер контрольных этапов выпуска заставляет каждую команду чётко определить, что проверяется, как обрабатываются сбои и где человеческое решение остаётся необходимым. Последовательное выполнение быстрых сборок, предварительных развертываний, критических тестов Playwright, проверки контракта API и бюджетов Lighthouse, лёгкого сканирования ZAP, неизменяемых артефактов и финального ручного одобрения обеспечивает конкретные, поддающиеся аудиту доказательства того, что релиз соответствует заданным критериям риска. Подход прозрачен, воспроизводим и адаптируем к любому веб‑приложению — предоставляя уверенность, которая измерима, а не просто рекламируется.
Источники
- Playwright CI documentation – https://playwright.dev/docs/ci
- GitHub Actions documentation – https://docs.github.com/en/actions
- Lighthouse CI documentation – https://github.com/GoogleChrome/lighthouse-ci
- OWASP ZAP documentation – https://www.zaproxy.org/docs/
Оставить комментарий
Поделитесь своим мнением о статье. Регистрация не требуется.
Комментарии
Загрузка комментариев…