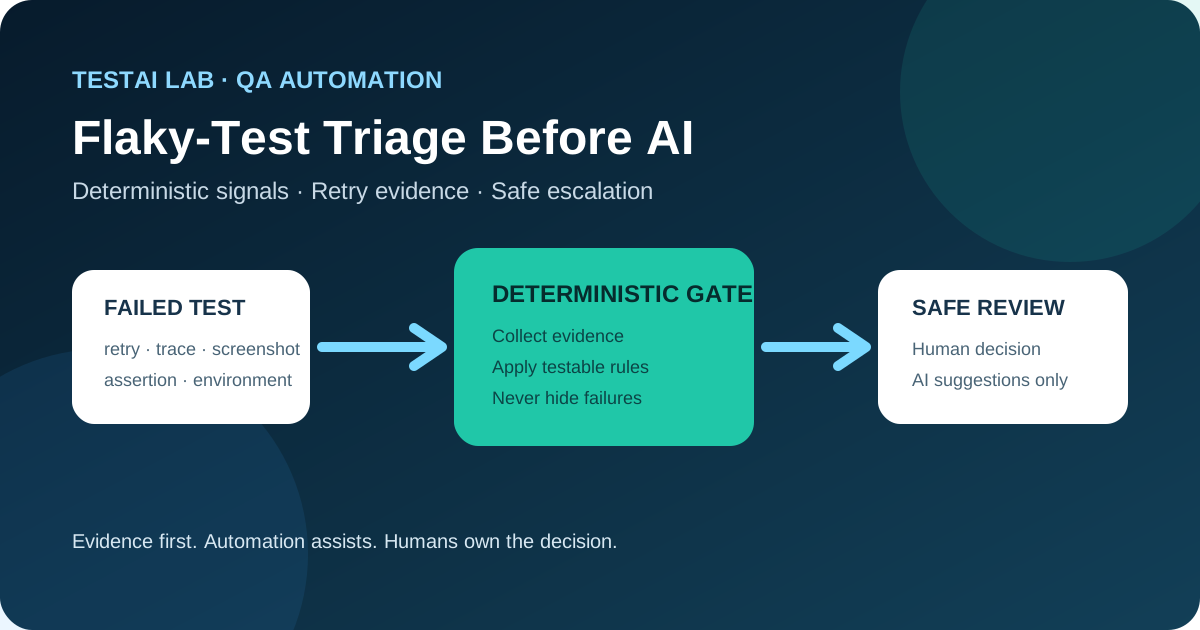
Как превратить сырые данные Playwright CI в надёжную классификацию первого прохода до привлечения ИИ‑ассистента.
1. Почему важен детерминированный слой триажа
Нестабильные тесты тратят время разработчиков, скрывают реальные регрессии и подрывают доверие к CI-конвейеру. Соблазн заключается в том, чтобы передать каждую неоднозначную ошибку модели ИИ, которая предлагает сменить локатор или автоматически отключить тест. Хотя ИИ может быть полезным помощником, он никогда не должен заменять дисциплинированный этап сбора доказательств. Детерминированный уровень сортировки гарантирует, что решение о привлечении человека — или ИИ — основывается на конкретных, воспроизводимых сигналах, а не на предположениях.
Встроенная поддержка повторных попыток, просмотрщик трассировок, скриншоты и публикация артефактов в Playwright (как описано в официальной документации) дают нам именно те данные, необходимые для первого прохода. Извлекая количество повторных попыток, результат каждой попытки, тип неудачного утверждения и метаданные среды, мы можем отделить инфраструктуру с высокой уверенностью или сбои продукта от случаев, которые остаются неоднозначными.
2. Конкретный сценарий CI
Рассмотрим рабочий процесс GitHub Actions, который запускает тесты Playwright на матрице браузеров. Рабочий процесс публикует следующие артефакты для каждого запуска:
- Trace files (
.zip) — содержат пошаговые данные сети, DOM и скриншоты. - Скриншоты – запечатлено после неудачи.
- Видео — необязательно, но полезно для визуальной проверки.
- Тестовые метаданные — открыты через
testInfo(номер повторной попытки, индекс работника, название проекта и т.д.).
Когда тест не проходит, рабочий процесс автоматически загружает эти артефакты в сводку запуска, делая их мгновенно доступными для дальнейшего анализа.
3. Пошаговый детерминированный триаж
| Шаг | Что мы захватили | Почему это важно |
|---|---|---|
| 1. Обнаружение отказа | Playwright отмечает тест как провалённый в отчете JSON. | Входная точка для логики сортировки. |
| 2. Рекордная попытка | testInfo.retry (0 с первой попытки, 1 при первом повторе, ...). | Определяет, является ли неудача проблемой первой попытки или аномалией только повторной попытки. |
| 3. Результат повторной попытки захвата | Успех или неудача последующей попытки. | Повторная попытка, которая проходит, не гарантирует, что первоначальная неудача была безвредной; она лишь показывает, что тест может пройти успешно при немного иной временной или ресурсной системе. |
| 4. Утверждение классифицировать | Определите тип исключения (AssertionError, TimeoutError, ошибка, связанная с сетью и т.д.). | Некоторые категории (например, сетевые тайм-ауты) чаще связаны с инфраструктурой, а другие (например, несовпадающий текст интерфейса) могут указывать на изменение продукта. |
| 5. Прикрепить трассу и скриншот | Используйте testInfo.attachments для хранения файла трассы и скриншота неудачи. | Предоставляет детерминированные визуальные доказательства, которые можно проверить без повторного прохождения теста. |
| 6. Метаданные среды записи | ОС, версия браузера, идентификатор CI runner, SHA коммита и любые флаги функций. | Помогает выявить закономерности, например, «не работает только в Windows Chrome 115». |
| 7. Применить детерминированные правила | Небольшая функция с модульным тестированием оценивает собранные данные и возвращает одну из трёх меток: Infrastructure, Product, Ambiguous. | Набор правил прозрачен, управляется версиями и может быть проверен командой. |
| 8. Маршрут результата | Инфраструктура → автоматически создавать тикет для инфраструктурной команды. <br>Продукт → автоматически создавать тикет на дефект с прикреплённой трассировкой. <br>Неоднозначно → флаг для человеческой проверки или необязательной помощи ИИ. | Гарантирует, что автоматически рассматриваются только дела с высоким уровнем конфиденциальности. |
Поток останавливается на шаге 7 для классификаций Инфраструктура и Продукт. Только когда набор правил не может принять уверенное решение, мы привлекаем человека или ИИ-помощника.
4. Пример TypeScript — прикрепление детерминированных доказательств
import { test, expect, TestInfo } from '@playwright/test';

// Helper that builds a structured evidence object
function buildEvidence(info: TestInfo, error: Error) {
  const evidence = {
    retry: info.retry,                     // attempt number
    outcome: info.status,                  // "failed" or "passed"
    assertion: error.name,                 // e.g., "AssertionError"
    message: error.message,
    tracePath: info.attachments.find(a => a.name === 'trace')?.path,
    screenshotPath: info.attachments.find(a => a.name === 'screenshot')?.path,
    env: {
      os: process.platform,
      browser: info.project.name,
      commit: process.env.GITHUB_SHA,
      runId: process.env.GITHUB_RUN_ID,
    },
  };
  // Persist as JSON artifact for later rule evaluation
  info.attach('triage-evidence', {
    body: JSON.stringify(evidence, null, 2),
    contentType: 'application/json',
  });
}

// Example test that records evidence on failure
test('checkout flow shows correct total', async ({ page }, testInfo) => {
  try {
    await page.goto('https://example.com/checkout');
    await expect(page.locator('#total')).toHaveText('$42.00');
  } catch (err) {
    // Capture trace and screenshot before rethrowing
    await testInfo.attach('trace', { path: testInfo.outputPath('trace.zip'), contentType: 'application/zip' });
    await testInfo.attach('screenshot', { path: testInfo.outputPath('failure.png'), contentType: 'image/png' });
    buildEvidence(testInfo, err as Error);
    throw err; // Let Playwright mark the test as failed
  }
});
Ключевые моменты
testInfo.retry— это детерминированный сигнал, который сообщает, произошёл ли сбой с первой попытки.- Вложение
triage-evidence— это JSON-файл, который последующие скрипты могут парсировать без повторного выполнения теста. - Все артефакты автоматически загружаются GitHub Actions после завершения работы, что делает их доступными для движка правил.
5. Детерминированные правила классификации (модульно‑тестируемые)
type Evidence = {
  retry: number;
  outcome: 'failed' | 'passed';
  assertion: string;
  env: { os: string; browser: string };
};

export function classify(e: Evidence): 'Infrastructure' | 'Product' | 'Ambiguous' {
  // Rule 1 – Infrastructure timeout on first attempt
  if (e.retry === 0 && e.assertion === 'TimeoutError') {
    return 'Infrastructure';
  }

  // Rule 2 – Assertion error that passes on retry → ambiguous
  if (e.retry > 0 && e.assertion === 'AssertionError' && e.outcome === 'passed') {
    return 'Ambiguous';
  }

  // Rule 3 – Consistent assertion error across all attempts → product defect
  if (e.retry === 0 && e.assertion === 'AssertionError') {
    return 'Product';
  }

  // Rule 4 – Known flaky pattern (e.g., Chrome on Linux) – treat as infrastructure
  if (e.env.browser.includes('chrome') && e.env.os === 'linux' && e.assertion === 'NetworkError') {
    return 'Infrastructure';
  }

  // Default – we cannot decide with confidence
  return 'Ambiguous';
}
Каждое правило намеренно просто, что облегчает написание модульных тестов, которые проверяют ожидаемую метку для данной полезной нагрузки доказательств. Набор правил может меняться по мере обнаружения новых шаблонов командой, но любые изменения должны быть рассмотрены и контролированы версиями.
6. Почему результат «повторного прохождения» не является доказательством безвредной нестабильности
Механизм повторной попытки Playwright повторяет весь тест (или неудачный шаг, в зависимости от конфигурации). Прошедшая попытка показывает, что тест може пройти при немного другом времени или снимке ресурса, но не объясняет, почему первая попытка провалилась. Распространённые скрытые причины включают:
- Временная задержка сети, которая превышает тайм-аут по умолчанию при первой попытке, но не при повторной попытке.
- Гоночные условия в приложении, которые проявляются только тогда, когда DOM находится в определённом состоянии.
- Спор за ресурсы на CI-раннере (например, троттлинг процессора), который исчезает после короткой паузы.
Если мы автоматически обозначим такие случаи как «безвредные», мы рискуем упустить регрессию, которая появляется только при определённом паттерне загрузки. Детерминированные доказательства (отслеживание, скриншоты, количество повторных попыток) позволяют человеку проверить, действительно ли успех повтора безобиден или скрывает более глубокую проблему.
7. Почему AssertionError не является автоматически дефектом продукта
AssertionError просто сообщает нам, что ожидание в тесте не совпало с наблюдаемым значением. Несоответствие может возникать из:
- Дрейф локаторов — селектор указывает на другой элемент после переработки интерфейса.
- Вариация времени — текст элемента обновляется на несколько миллисекунд позже выполнения утверждения.
- Различия в окружающей среде — шрифты, локации или настройки DPI, влияющие на отрисованный текст.
Только когда доказательства показывают постоянное несоответствие во всех попытках и средах, мы должны рассматривать это как дефект продукта. В противном случае сбой относится к инфраструктуре или нестабильному тесту, и соответствующая реакция — это корректировка политики повторных попыток или улучшение стабильности теста, а не заявка на дефект.
8. Безопасная эскалация к ИИ — что ассистент может (и не может) делать
Когда детерминированный классификатор возвращает Двусмысленный, команда может выбрать привлечение ИИ-ассистента для получения предложений. Область этой помощи должна быть строго ограничена:
| Разрешённые действия ИИ | Запрещенные действия ИИ |
|---|---|
| Предложите новый локатор на основе скриншота трассировки. | Напрямую изменять тестовый файл без одобрения человека. |
| Краткое описание шагов следа, приведших к неудаче. | Подавить тест на неслойку или отметить его как «пропуск». |
| Выделите отсутствующие сетевые запросы, которые могут объяснить тайм-аут. | Сгенерируйте описание дефекта, которое автоматически подаётся без проверки. |
Логика проста: модель ИИ не обладает контекстуальными знаниями о намерении продукта, графике выпуска или толерантности к риску. Она может выявлять подсказки, но окончательное решение — менять селектор, корректировать тайм-аут или открывать дефект — должно оставаться человеческим суждением.
9. Где помогает автоматизация
- Сбор доказательств – Встроенный
testInfoи просмотрщик трассировки Playwright автоматизируют сбор детерминированных данных, устраняя ручной поиск скриншотов. - Выполнение движка правил – функция классификации может выполняться как шаг действия GitHub, который помечает запуск меткой (
infra,product,needs‑review). Это исключает необходимость читать каждый журнал отказов. - Публикация артефактов – GitHub Actions автоматически хранит трассы и скриншоты как загружаемые артефакты, обеспечивая их неизменность и аудит.
- Маршрутизация уведомлений – На основе метки рабочий процесс может разместить сообщение в соответствующем Slack-канале или создать заявку на Jira, гарантируя, что правильная команда получит правильный сигнал.
Автоматизация не доходит до принятия решений; она предоставляет факты, которые позволяют быстро и надёжно провести проверку с участием человека или искусственного интеллекта.
10. Вопросы для повторения
- Какое свойство Playwright говорит вам о текущей попытке повтора, и почему оно необходимо для детерминированного сортировки?
- Объясните, почему тест, который проходит повторное тестирование, всё равно должен быть рассмотрен до того, как его признают «нестабильным, но безвредным».
- Перечислите две категории утверждений, которые чаще указывают на проблемы с инфраструктурой, а не на дефекты продукта.
- Каковы три возможных результата классификации детерминированного движка правил и какое действие каждое из них вызывает?
- Определите одно действие, предложенное ИИ, которое допустимо в категории «Неоднозначное» и которое должно быть запрещено.
11. Заключение
Нестабильные тесты неизбежны, но то, как мы их проводим, определяет, станут ли они потоком продуктивности или управляемым сигналом. Используя метаданные повторных попыток Playwright, артефакты трассировки и структурированные вложения, мы можем создать детерминированный уровень сортировки, который надёжно отделяет инфраструктуру с высокой уверенностью или сбои продукта от действительно неоднозначных случаев. Только последние должны быть доведены до человеческого рецензента или ассистента ИИ, и даже тогда роль ИИ должна ограничиваться внушениями, а не выполнением. Такой дисциплинированный подход сохраняет целостность тестов, сохраняет надёжность конвейера CI и гарантирует, что автоматизация остаётся помощником, а не неконтролируемым принимающим решения.
Источники
- Повторные попытки Playwright Test – https://playwright.dev/docs/test-retries
- Playwright Trace Viewer – https://playwright.dev/docs/trace-viewer
- Документация GitHub Actions по загрузке артефактов – https://docs.github.com/en/actions/using-workflows/storing-workflow-data-as-artifacts
Оставить комментарий
Поделитесь своим мнением о статье. Регистрация не требуется.
Комментарии
Загрузка комментариев…