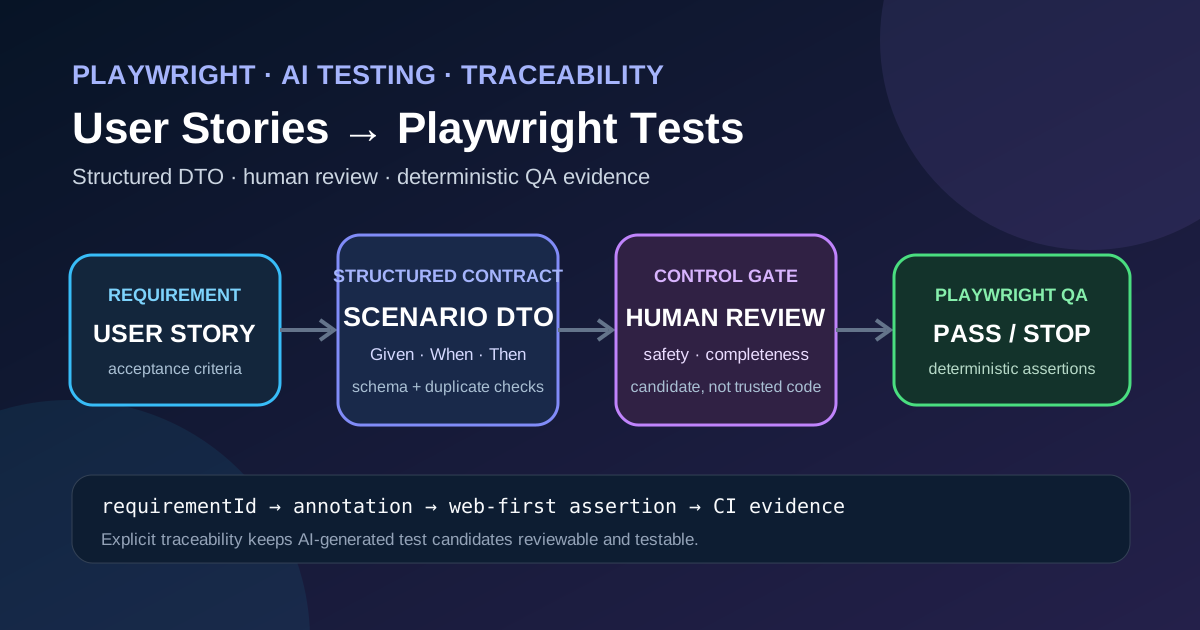
Практические рекомендации по превращению требований продукта в надёжные автоматизированные UI‑тесты при сохранении участия человека.
1. Введение
Современные гибкие команды фиксируют функциональное намерение в виде пользовательских историй и критериев приёмки. Те же артефакты могут стать источником автоматизации тестов на уровне UI, но перевод обычно далёк от тривиального. Большие языковые модели (LLM) могут генерировать кандидат‑скрипты Playwright из нормализованного описания истории, однако сгенерированный код никогда не следует считать готовым к продакшну без проверки.
В этой статье описан повторяемый, трассируемый процесс, который:
- Нормализует пользовательскую историю в структурированный DTO сценария теста.
- Передаёт DTO LLM, которая возвращает кандидат‑тест Playwright.
- Применяет человеческий обзор, детерминированные утверждения и метаданные‑аннотации, связывающие тест с исходным идентификатором требования.
- Публикует результат в CI, где тест служит доказательством, а не решающим фактором.
Все шаги описаны конкретными фрагментами TypeScript, схемой JSON для DTO и практическими QA‑ограничениями, такими как обнаружение дублирующих сценариев, изоляция инъекций подсказок и чек‑лист для утверждения релиза.
2. Сквозной процесс
User Story + Acceptance Criteria
          │
          ▼
Normalized Requirement (JSON)
          │
          ▼
Test‑Scenario DTO (structured)
          │
          ▼
LLM Prompt → Candidate Playwright Test (TS)
          │
          ▼
Human Review (review gate)
          │
          ▼
Annotated Playwright Test (tags, deterministic assertions)
          │
          ▼
CI Execution → Pass/Fail evidence
          │
          ▼
Regression Impact analysis
Каждая стрелка представляет передачу, которая намеренно документирована. Единственный артефакт, автоматически перемещающийся между этапами, — это DTO — машинно‑читаемое представление, которое можно валидировать, версионировать и сравнивать с предыдущими запусками.
3. Нормализация пользовательской истории
Исходная история, например
> «Как покупатель, я хочу добавить товар в корзину, чтобы позже его купить.»
должна быть очищена от повествовательного «мусора» и выражена в каноническом JSON‑формате. Шаг нормализации выполняет небольшой внутренний скрипт (или надёжная LLM с фиксированным запросом), который извлекает:
- Идентификатор требования — например,
REQ‑1234. - Фича —
Shopping Cart. - Сценарий — короткое название, например,
Add product to cart. - Given / When / Then условия, которые отражают критерии приёмки.
- Risk tags –
high‑value,auth‑required, и т.д.
Пример нормализованного вывода:
{
  "requirementId": "REQ-1234",
  "feature": "Shopping Cart",
  "scenarioId": "SCN-001",
  "title": "Add product to cart",
  "given": [
    { "type": "state", "description": "User is logged in", "role": "shopper" }
  ],
  "when": [
    { "action": "click", "target": "button[data-test='add-to-cart']", "productId": "123" }
  ],
  "then": [
    { "assertion": "cartContains", "productId": "123", "quantity": 1 }
  ],
  "risk": ["high-value"]
}
JSON‑схема, которая валидирует эту структуру, показана позже в статье.
4. Генерация DTO тест‑сценария
DTO — это контракт между командой требований и генератором кода ИИ. Он содержит только данные, необходимые для создания детерминированного теста. Минимальная схема (совместимая с JSON схема Draft‑07) выглядит так:
{
  "$схема": "http://json-схема.org/draft-07/схема#",
  "title": "Playwright Test Scenario DTO",
  "type": "object",
  "required": ["requirementId","scenarioId","title","given","when","then"],
  "properties": {
    "requirementId": { "type": "string" },
    "scenarioId": { "type": "string" },
    "title": { "type": "string" },
    "given": {
      "type": "array",
      "items": { "$ref": "#/definitions/step" }
    },
    "when": {
      "type": "array",
      "items": { "$ref": "#/definitions/step" }
    },
    "then": {
      "type": "array",
      "items": { "$ref": "#/definitions/assertion" }
    },
    "risk": {
      "type": "array",
      "items": { "type": "string" }
    }
  },
  "definitions": {
    "step": {
      "type": "object",
      "required": ["action","target"],
      "properties": {
        "action": { "type": "string" },
        "target": { "type": "string" },
        "description": { "type": "string" },
        "productId": { "type": "string" }
      }
    },
    "assertion": {
      "type": "object",
      "required": ["assertion"],
      "properties": {
        "assertion": { "type": "string" },
        "productId": { "type": "string" },
        "quantity": { "type": "integer" }
      }
    }
  }
}
Схема используется для валидации до того, как DTO попадёт в LLM. Неправильные полезные нагрузки отклоняются сразу, предотвращая malformed‑промпты, которые могут привести к неоднозначному коду.
5. Изоляция от инъекций промптов
Поскольку DTO исходит из ненадёжного источника (бэклог продукта), промпт, который подаётся в LLM, должен быть песочницей:
- DTO строкируется и вставляется в фиксированный плейсхолдер внутри шаблона.
- Шаблон никогда не интерполирует свободный текст; допускаются только поля JSON.
- Запрос к LLM отправляется через выделенный API‑ключ с ограничением скорости, изолирующим его от других сервисов.
Если DTO содержит вредоносные payload‑ы (например, описание given, включающее код), JSON‑схема отклонит его, а слой изоляции экранирует любые посторонние символы до их попадания в LLM. Такой подход смягчает классические атаки prompt‑injection, сохраняя быстрый рабочий процесс.
6. Сгенерированный тест Playwright
Ниже приведён репрезентативный фрагмент TypeScript, который LLM может сгенерировать из приведённого выше DTO. Код не считается корректным, пока его не одобрит человек.
import { test, expect } from '@playwright/test';

// Traceability tags – Playwright supports custom annotations
test.describe.configure({ mode: 'parallel' });

test('REQ-1234 SCN-001 Add product to cart', async ({ page }) => {
  // Tag the test with requirement metadata
  test.info().annotations.push({ type: 'requirement', description: 'REQ-1234' });
  test.info().annotations.push({ type: 'scenario', description: 'SCN-001' });

  // GIVEN – user is logged in
  await page.goto('https://example.com/login');
  await page.fill('#username', 'shopper@example.com');
  await page.fill('#password', 'securePass!');
  await page.click('button[type="submit"]');
  await expect(page).toHaveURL(/.*dashboard/);

  // WHEN – click add‑to‑cart button for product 123
  await page.goto('https://example.com/product/123');
  await page.click('button[data-test="add-to-cart"]');

  // THEN – cart must contain the product (deterministic oracle)
  await page.goto('https://example.com/cart');
  const cartItem = page.locator('li[data-test="cart-item-123"]');
  await expect(cartItem).toBeVisible();
  await expect(cartItem).toHaveText(/Quantity:\s*1/);
});
Ключевые моменты:
- Annotations (
requirement,scenario) сохраняют трассируемость в отчётах тестов. - Web‑first assertions (
await expect(page).toHaveURL,await expect(cartItem).toBeVisible) детерминированы, потому что ждут, пока UI достигнет стабильного состояния перед оценкой условия, как описано в документации Playwright о утверждениях и аннотациях тестов. - Тест не содержит жёстко закодированных секретов; учётные данные передаются через переменные окружения в CI‑конвейере (не показано здесь).
7. Человеческий обзор и ворота проверки
Кандидатский тест направляется в review board, который проверяет:
- Semantic fidelity – Проверяет ли тест точные критерии приёмки?
- Safety – Нет случайного удаления данных, нет жёстко закодированных секретов.
- Completeness – Присутствуют ли негативные пути, граничные значения и шаги очистки?
- Determinism – Все утверждения полагаются на механизмы ожидания Playwright; нет ненадёжных
setTimeoutхака.
review gate может быть реализован в CI требованием подписанного Git‑коммита (например, строки Signed-off-by:) перед тем, как тест будет слит в ветку automation. Автоматический линтинг также может проверять наличие требуемых аннотаций.
8. Детерминированные оракулы с автоматически ожидающими проверками
Автоматически ожидающие проверки Playwright опрашивают DOM, пока не выполнится ожидаемое условие или не истечёт тайм‑аут. Такое поведение устраняет необходимость в ручных паузах и снижает хрупкость. В приведённом выше примере:
await expect(page).toHaveURL(/.*dashboard/)ждёт завершения навигации.await expect(cartItem).toBeVisible()ждёт появления элемента, гарантируя, что последующая проверкаtoHaveTextвыполняется над стабильным элементом.
Поскольку эти проверки встроены в Playwright, они являются частью документированного поведения (см. документацию Playwright по проверкам) и могут использоваться как детерминированные оракулы для регрессионных доказательств.
9. Сохранение трассируемости с помощью тегов и аннотаций
Playwright позволяет использовать custom annotations, которые отображаются в отчётах о тестах и могут фильтроваться в командной строке (--grep @requirement=REQ-1234). Типичный шаблон:
test('Add product to cart', async ({ page }) => {
  test.info().annotations.push({ type: 'requirement', description: 'REQ-1234' });
  test.info().annotations.push({ type: 'risk', description: 'high-value' });
  // test body …
});
Эти аннотации позволяют:
- Bidirectional traceability – По требованию можно найти все сгенерированные тесты, а по неудачному тесту мгновенно увидеть затронутый ID требования.
- Selective execution – Во время спринта по исправлению критических багов можно запускать только тесты, помеченные определённым тегом риска.
Практика встраивания ID требований непосредственно в название теста (REQ-1234 SCN-001 …) дополнительно усиливает трассируемость для команд, использующих конвенции именования.
10. Добавление недостающих измерений теста
ИИ‑сгенерированные кандидаты обычно покрывают только happy path. Команда QA должна явно добавить:
- Negative cases – например, попытку добавить товар, которого нет в наличии, и проверку появления сообщения об ошибке.
- Граничные значения – например, добавление максимального разрешённого количества и проверка ограничения.
- Проверки авторизации – подтверждение того, что гость не может добавить товар в корзину.
- Настройка данных – заполнение каталога продуктов требуемым
productIdперед запуском теста. - Очистка – удаление элемента из корзины после проверки, чтобы среда оставалась чистой.
- Влияние регрессии – документирование того, затрагивает ли сценарий общие компоненты (поиск, оформление заказа), которые могут вызвать каскадные сбои.
Эти добавления ручные, но их можно шаблонизировать. Например, шаблон «отрицательного пути» может автоматически применяться к каждому сгенерированному тесту, предлагая рецензенту заполнить конкретное условие ошибки.
11. Проверки дубликатов и противоречий
Перед отправкой DTO в LLM репозиторий существующих сценариев сканируется:
- Обнаружение дубликатов – два DTO с идентичными последовательностями
given/when/thenпомечаются. Система предлагает объединить или переименовать. - Обнаружение противоречий – если один сценарий утверждает
cartContains(productId=123, quantity=1), а другой утверждаетquantity=0для того же предусловия, генерируется предупреждение.
Эти проверки опираются на простое структурное хеширование массивов when и then и могут выполняться как pre‑commit hook.
12. Безопасное логирование и сбор доказательств
Во время выполнения CI:
- Логи тестов очищаются от любых полезных нагрузок запросов, которые могут содержать персональные данные. Сохраняются только ID требования и результат.
- Скриншоты при сбое сохраняются в bucket артефактов с именованием, включающим ID требования (
REQ-1234_failure.png). - Отчёты JUnit XML включают пользовательские аннотации, позволяя downstream‑дашбордам сопоставлять сбои с бизнес‑требованиями.
Логи становятся доказательством для решений о релизе, но само решение остаётся человеческим суждением, основанным на детерминированном результате pass/fail.
13. Чеклист проверки
Краткий чеклист, который рецензент подписывает перед слиянием теста:
- [ ] DTO проходит валидацию по JSON‑схеме.
- [ ] Идентификатор требования и идентификатор сценария отображаются в имени теста и аннотациях.
- [ ] Все шаги
givenвоспроизводимы в тестовой среде (нет жёстко закодированных URL). - [ ] Ассерции используют встроенные методы
expectPlaywright (без ручных задержек). - [ ] Добавлены негативные, граничные и авторизационные случаи там, где это диктует риск.
- [ ] Настройка и очистка данных явные и идемпотентные.
- [ ] Секретные значения не закодированы жёстко; вместо этого используются переменные окружения.
- [ ] Дублирующие или противоречивые сценарии решены.
- [ ] В CI‑задаче включена безопасная конфигурация логирования.
Только после того, как все пункты отмечены, тест переходит в ветку automation.
14. Где автоматизация помогает
- Генерация подсказки – Использование фиксированного шаблона для преобразования проверенного DTO в подсказку устраняет ad‑hoc инженерию подсказок.
- Валидация схемы – Автоматические проверки JSON‑схемы ловят некорректные требования до их попадания в LLM.
- Обнаружение дубликатов – Лёгкий скрипт может раннее помечать избыточные сценарии, снижая нагрузку на обслуживание.
- Выполнение CI – Параллельный раннер тестов Playwright и встроенные репортеры дают быстрый фидбек по детерминированным ораклам.
Автоматизация не заменяет человеческое суждение в отношении:
- Определения, действительно ли сгенерированный тест отражает бизнес‑интенцию.
- Добавления риск‑ориентированных негативных путей, требующих доменных знаний.
- Оценки влияния сбоя на готовность релиза.
Баланс — это конвейер человек в контуре принятия решений, где ИИ ускоряет построение каркаса, а QA владеет финальными контрольными точками качества.
15. Вопросы для обзора
- Как внедрение идентификаторов требований в аннотации Playwright улучшает прослеживаемость?
- Какие меры безопасности предотвращают внедрение запросов при передаче DTO в LLM?
- Почему веб‑ориентированные утверждения Playwright считаются детерминированными оракулами?
- Перечислите три измерения теста, которые необходимо добавить вручную после генерации ИИ.
- Какую роль играет обнаружение дубликатов в поддержании чистого набора тестов?
16. Заключение
Преобразование пользовательских историй в тесты Playwright с помощью ИИ может значительно сократить время от требования до автоматической проверки. Ключ к надёжному конвейеру — явная прослеживаемость, детерминированные утверждения и человек‑центричный контроль, который рассматривает сгенерированный код как кандидат, а не как окончательный артефакт. Нормализуя истории в проверенный DTO, изолируя подсказки, помечая тесты метаданными требований и дополняя скрипт счастливого пути негативными, граничными и очистительными логиками, команды получают воспроизводимые доказательства в CI, сохраняя решения о релизе под строгим контролем человека.
Источники
- Документация Playwright – Аннотации тестов: https://playwright.dev/docs/test-annotations
- Документация Playwright – Утверждения тестов: https://playwright.dev/docs/test-assertions
Оставить комментарий
Поделитесь своим мнением о статье. Регистрация не требуется.
Комментарии
Загрузка комментариев…