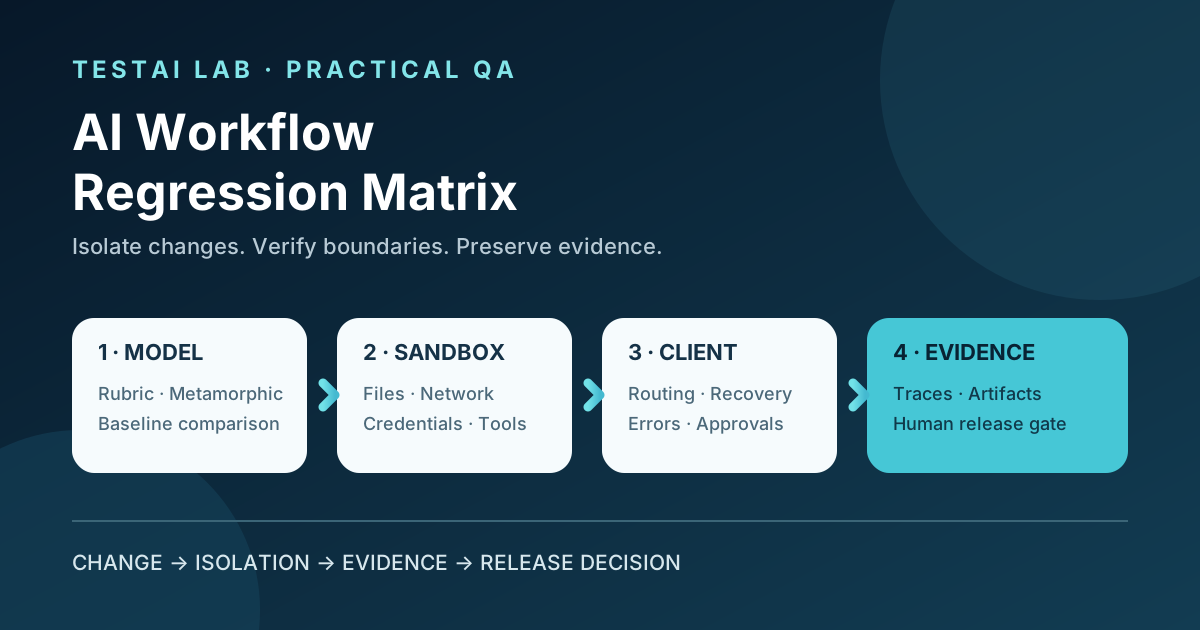
Рабочий процесс кодирования ИИ может изменяться одновременно в нескольких местах: выбранной модели, локальной песочнице, конфигурации телеметрии или клиенте, который запускает задачу. Один сбой, например «агент не смог завершить», не указывает, какой уровень регрессировал.
Полезный пример — пакет релиза Copilot от GitHub от 21 сентября. Он анонсировал дополнительные модели, локальную песочницу в публичном предварительном просмотре, настройку телеметрии и обновления интеграций с корпоративными чатами и средами разработки. Это факты о продукте. Ниже приведён дизайн теста — это наше предложение по QA; это не описание тестов, проведённых GitHub.
1. Определите систему как четыре тестируемых слоя
Рассматривайте рабочий процесс как четыре связанных слоя:
- Слой модели: создаёт вероятностный код или объяснения.
- Слой политики: определяет, разрешен ли доступ к файлу, сети, учетным данным или инструменту.
- Клиентский слой: отправляет контекст, показывает прогресс, запрашивает одобрения и показывает ошибки.
- Слой доказательств: записывает достаточно телеметрии и артефактов, чтобы объяснить, что произошло.
Ключевой вопрос тестирования — не только «Прошло ли задание?» А «Какой слой изменился, какие доказательства подтверждают результат и можем ли мы его воспроизвести?»
2. Создайте базовый уровень перед тем, как что‑либо менять
Используйте небольшой фиксированный набор задач, который представляет реальную работу, не касаясь производственных данных. Например:
- изменить одну функцию в одноразовом хранилище;
- проведите локальный модульный тест;
- прочитать файл, находящийся внутри разрешённого рабочего пространства;
- попытка прочитать синтетический файл вне разрешённого рабочего пространства;
- вызвать одобренный макет HTTP-конечной точки;
- попытка вызвать заблокированный имитационный хост;
- Запросить операцию, требующую явного одобрения человека.
Запустите набор на текущей стабильной конфигурации и сохраните выбранную модель, версию клиента, политику песочницы, коммит тестового репозитория, запросы, решения инструментов, сгенерированный патч, результаты тестов и итоговый статус.
Не используйте точный сгенерированный ответ в качестве базовой линии. GitHub документирует, что Copilot поддерживает несколько моделей с разными сильными сторонами, и что доступность моделей может меняться. Генерируемый контент является вероятностным; стабильный оракул должен быть наблюдаемым поведением и критериями принятия.
3. Отделить детерминированные контракты от вероятностного качества
Детерминированные проверки отвечают на вопросы с чётким ответом «да» или «нет»:
- Содержал ли ответ необходимые структурированные поля?
- Остался ли отклонённый путь файловой системы без изменений?
- Получал ли мок-сервер ноль запросов, когда его хост был заблокирован?
- Требовалось ли одобрение перед защищённым действием?
- Показывал ли клиент ошибку, пригодной для использования, вместо того чтобы оставаться в режиме загрузки?
- Были ли тестовые артефакты связаны с правильным забегом?
Вероятностные проверки оценивают качество предлагаемого изменения:
- Удовлетворяет ли патч задачу?
- Проходят ли существующие тесты?
- Вносила ли модель ненужные изменения?
- Технически ли это объяснение правильно?
- Можно ли поддерживать и безопасно ли это решение?
Оценивайте вероятностные результаты с помощью рубрики, принадлежащей человеку. Примеры измерений: корректность, контроль объёма, доказательства теста, безопасность и поддерживаемость. Любой числовой порог должен исходить из собственного базового уровня и риска проекта; это не требование GitHub.
4. Используйте матрицу с изоляцией изменений
Выполните тот же набор задач в контролируемых комбинациях:
- базовая модель + базовая политика + базовый клиент;
- модель кандидата + базовая политика + базовый клиент;
- базовая модель + кандидат-политика + базовый клиент;
- базовая модель + базовая политика + кандидат-клиент;
- Модель кандидата + политика кандидата + клиент-кандидат.
Изменить только одно измерение в средних периодах. Это создаёт доказательства для сортировки.
Если показатели качества снижаются только с моделью кандидата, проверьте поведение модели и подсказки. Если разрешённый инструмент начинает давать сбой только в рамках политики кандидата, проверьте правила песочницы. Если тот же запрос успешно проходит через одного клиента, но теряет контекст или одобрение через другой, рассматривайте это как дефект интеграции. Если все комбинации не работают, проверьте общие сервисы и данные тестирования, прежде чем обвинять какой-либо кандидат-компонент.
5. Проверьте границы песочницы через побочные эффекты
Локальная песочница предназначена для ограничения доступа к файловой системе, сетевого подключения и использования учетных данных. Проверьте политику через наблюдаемые побочные эффекты в одноразовом рабочем пространстве.
Для разрешённой записи проверьте точный путь файла, содержимое и различия. Для отказа при записи проверьте, что целевой файл не существует и что соседний файл не изменился. Для сетевых тестов используйте локальные мак-эндпоинты и подтверждайте разрешённые или заблокированные запросы в мок-логах. Для учетных данных используйте только синтетические токены и утверждайте, что секреты недоступны там, где политика предупреждает их маскировку.
Настройки настраиваются отдельно для поддерживаемых поверхностей, и поведение операционной системы может отличаться. Записывайте клиента, операционную систему и эффективную политику с каждым результатом. Никогда не делайте вывода, что политика, проверенная на одной поверхности, автоматически применяется ко всем другим клиентам.
6. Проверьте интеграцию с клиентами, не предполагая одинаковых характеристик
Релиз-пакет упоминал несколько клиентов, но это не значит, что каждый из них показывает одинаковое поведение песочницы или телеметрии. Сначала создайте карту возможностей.
Для каждого протестированного клиента записывайте:
- доступный выбор моделей;
- поддерживаемые контроли разрешений и одобрения;
- обработка контекста или привязанности;
- поведение при прерывании и восстановлении соединения;
- сообщения об ошибках;
- доступные журналы и телеметрия.
Затем запускайте только те проверки, поддерживаемые этой поверхностью. Кросс-клиентская регрессия означает сравнение общих контрактов, таких как идентификация задачи, выбор репозитория, язык, вложения, ссылки и итоговый статус. Клиент-специфические возможности требуют собственных ожиданий.
7. Проверьте прерывание и восстановление
Долгосрочная работа агента может быть прервана закрытым клиентом, потерей сети, истёкшей сессией или отклонённым вызовом инструмента. Используйте безопасную инъекцию отказа:
- запустить задачу в одноразовом хранилище;
- прерывает работу клиента или имитирует соединение;
- возобновить сессию;
- проверьте, возобновляется, возобновляется ли задача или не происходит ли явно;
- Подтвердите, что дублирующиеся коммиты, дублированные проблемы и повторяющиеся побочные эффекты не создавались.
Проверка восстановления проходит только тогда, когда состояние становится однозначным. «Интерфейс снова активен» не является доказательством. Сравните состояние репозитория, пробные запросы, статус сессии и артефакты.
8. Рассматривайте телеметрию как чувствительное доказательство теста
GitHub документирует поддержку OpenTelemetry для мониторинга сессий агентов, включая трассировки, метрики и события. Управляемые настройки могут контролировать, будут ли захвачены идентификация, подсказки, ответы, аргументы инструмента, вывод инструментов или детали политики. Некоторые классы могут содержать исходный код, команды, пути и секреты.
Проверьте саму конфигурацию телеметрии:
- ожидаемые сессии доходят до утверждённого коллектора;
- Пробег можно коррелировать без изобретения продуктовых названий span;
- отключённые классы захвата не отображаются;
- Доступные курсы ограничены одобренной тестовой средой;
- авторизационные заголовки и коллекторские удостоверения никогда не печатаются;
- Удержание и доступ соответствуют политике проекта.
Для рутинного контроля качества отдавайте предпочтение метаданным и результатам вместо захваченных запросов или источников. Включайте конфиденциальный захват только для одобренного расследования.
9. Классифицируйте ошибки перед повторной попыткой
Повторные попытки могут скрывать реальные регрессии. Разделить ошибки в:
- временный сбой сервиса: повторная попытка с небольшим закрытым отходом;
- отказ в политике: не пытаться повторить; проверьте, что отказ был ожидаем;
- сбой парсинга или рендеринга клиента: захват исходного ответа и журналов клиента;
- сбои качества: оставьте результат и результаты рубрики для проверки;
- сбой тестовой среды: отремонтировать светильник, затем запустить тот же кандидат.
Всегда прикрепляйте исходную попытку и историю повторных попыток. Проход за повтором не стирает первую неудачу.
10. Определите критерии выпуска и отката
Практические ворота могут потребовать:
- Все детерминированные проверки контрактов проходят;
- не возникает несанкционированных побочных эффектов файловой системы, сети, учетных данных или инструментов;
- Каждый поддерживаемый клиент выполняет основную задачу и четко сообщает об ошибках;
- Качество кандидатов не ниже утверждённого порога рубрики проекта;
- тесты прерывания не создают дублирования внешнего действия;
- Необходимые доказательства доступны без раскрытия секретов;
- Человеческий рецензент принимает образцы с наибольшим риском.
Откат должен быть возможен по измерениям. Отменить выбор модели без ослабления политики песочницы, откатить интеграцию с клиентом без удаления доказательств и восстановить известную политику, сохраняя при этом неудачную кандидатскую попытку для анализа.
11. Где помогает автоматизация
Автоматизация эффективна для захвата конфигурации, проверки схем, утверждений файловых систем и сети, анализа дифференциальных данных, выполнения тестов, обнаружения дубликатов и сбора артефактов. Она также может сравнивать исходные и кандидатские баллы.
Автоматизация не должна решать, приемлемо ли правдоподобное, но иное решение, оправдано ли расширение разрешений или пропорциональна ли собранная телеметрия. Эти решения принадлежат людям, ответственным за риски, безопасность и конфиденциальность продукта.
12. Чек‑лист QA
Перед релизом убедитесь:
- фиксируются базовая и кандидатная конфигурации;
- использовался тот же фиксированный набор задач;
- одномерные изоляционные серии завершены;
- детерминированные и вероятностные проверки разделяются;
- тесты песочницы используют одноразовые пути, имитации хостов и синтетические секреты;
- Каждый протестированный клиент имеет явную карту возможностей;
- прерывающие тесты проверяют наличие дублированных побочных эффектов;
- Захват телеметрии минимален и одобрен;
- История повторных попыток видна;
- передаётся право собственности на откат;
- окончательное решение фиксируется человеком-рецензентом.
Вопросы для обзора
- Почему точный сгенерированный ответ является слабым оракулом для изменения модели?
- Какие побочные эффекты доказывают, что правило песочницы сработало?
- Как запуск одномерной изоляции улучшает анализ коренных причин?
- Какие доказательства нужны после прерванной работы агента?
- Какие решения по выпуску должны оставаться в собственности человека?
Заключение
Многомерные выпуски ИИ требуют большего, чем одного сквозного дымового теста. Надёжная стратегия замораживает базовый уровень, меняет один слой за раз, проверяет детерминированные побочные эффекты, оценивает вероятностное качество с помощью рубрики и сохраняет доказательства для человеческого решения о выпуске. В результате получается регрессионный процесс, который может отличить изменение модели от отказа песочницы, дефекта клиента или разрыва наблюдаемости, не притворяясь, что результат ИИ детерминирован.
Источники
- GitHub Copilot weekly releases — September 21: https://github.blog/changelog/2026-09-25-github-copilot-weekly-releases-september-21
- Supported ИИ models in GitHub Copilot: https://docs.github.com/en/copilot/reference/ai-models/supported-models
- Configuring local sandbox settings: https://docs.github.com/en/copilot/how-tos/cloud-and-local-sandboxes/configuring-local-sandbox-settings
- OpenTelemetry for agent monitoring: https://docs.github.com/en/copilot/concepts/enterprise/opentelemetry
Оставить комментарий
Поделитесь своим мнением о статье. Регистрация не требуется.
Комментарии
Загрузка комментариев…