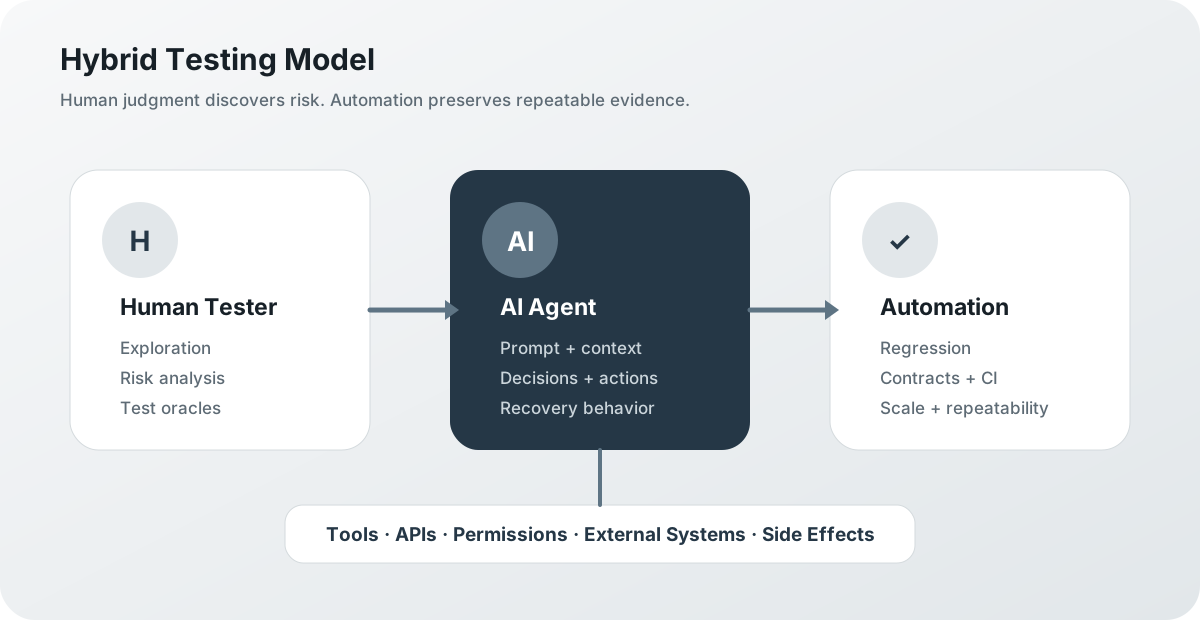
Как с помощью ИИ выявить первопричину периодических сбоев, сохранив артефакты первого сбоя и не позволяя автоматическому исправлению скрыть реальный дефект продукта.
1. Введение
Нестабильные тесты — это тесты, которые без изменений в коде то проходят, то завершаются сбоем. Они незаметно снижают эффективность команды. В конвейере непрерывной интеграции они могут превратить реальный дефект в «зелёную» сборку, подрывая доверие к автоматизации и вынуждая разработчиков игнорировать результаты тестирования. Тест-раннер Playwright поддерживает повторные запуски и предоставляет подробную трассировку, однако эти возможности нередко используют как грубый способ «сделать сборку зелёной».
В руководстве показано, как превратить механизмы повторных запусков и трассировки Playwright в диагностический сигнал, а не в способ маскировки статуса, и как дополнить собранные данные анализом с помощью ИИ, сохранив проверку человеком. Этот процесс учитывает риски, основан на доказательствах и совместим с типовыми конфигурациями CI.
2. Почему нестабильные тесты опасны
- Периодические сбои маскируют реальные дефекты. Когда тест сначала завершается с ошибкой, а затем проходит при повторном запуске, задание CI завершается с положительным результатом, но первоначальный сбой мог быть вызван реальной ошибкой (например, условием гонки в пользовательском интерфейсе).
- Команды теряют доверие к набору тестов. Если разработчики постоянно сталкиваются с «нестабильными» предупреждениями, они начинают воспринимать все сбои как «шум» и перестают их расследовать.
- Нестабильность тестов увеличивает затраты на сопровождение. Каждый нестабильный тест требует задачи на триаж, анализа первопричины и, возможно, переработки локатора или настройки тестовых данных.
Наиболее распространённые причины нестабильности тестов Playwright описаны в материалах сообщества Playwright и совпадают с выводами статьи Хари Гокула:
| Категория | Типичный симптом | Пример в Playwright |
|---|---|---|
| Синхронизация / условия гонки | Элемент не готов, скачки задержки в сети | await page.click('#submit') периодически завершается ошибкой |
| Хрупкие селекторы | Изменения DOM нарушают работу локаторов CSS/XPath | page.locator('text=Login') дает сбои после переработки интерфейса |
| Нестабильность сети | Таймауты внешнего API | Тест завершается сбоем, если сторонний сервис работает медленно |
| Общее состояние | Тесты изменяют общую запись в БД или состояние хранилища | Два параллельных воркера записывают данные в один файл |
| Различия среды | Разные системные шрифты, рендеринг в headless-режиме и режиме с интерфейсом | Визуальный регрессионный тест проходит локально, но завершается сбоем в CI |
Если конвейер CI просто повторяет тест и помечает его как пройденный, доказательства первого сбоя (консоль браузера, сетевые журналы, скриншоты) исчезают, из-за чего становится невозможно определить, был ли сбой безобидной неполадкой или реальным дефектом.
3. Повторные запуски Playwright: от «сделать сборку зелёной» к диагностическому сигналу
Повторные запуски тестов в Playwright по умолчанию отключены. Если их включить, тест-раннер классифицирует тест как пройденный, если он успешно завершился с первой попытки, как нестабильный, если первая попытка завершилась сбоем, а одна из последующих — успешно, и как непройденный, если все попытки завершились сбоем. Эта классификация должна оставаться видимой в CI: повторный запуск не должен незаметно превращать нестабильный результат в обычный успешный.
Выбор режима трассировки — это осознанный компромисс:
| Режим трассировки | Что записывается | Применение при триаже |
|---|---|---|
retain-on-failure | Записывает каждую попытку и сохраняет трассировки неудачных попыток | Наиболее подходящий вариант, когда главным доказательством служит первоначальный сбой |
on-first-retry | Записывает первую повторную, но не первоначальную попытку | Полезен для изучения нового контекста повторного запуска |
on-all-retries | Записывает все повторные попытки | Полезен для сравнения нескольких попыток, но создаёт больше артефактов |
Ни один режим не позволяет одновременно записать первоначальную попытку и каждый успешный повторный запуск. Выберите необходимые доказательства и дополните их скриншотами, видео, журналами консоли, сетевыми данными и HTML-отчётом.
Рекомендуемая базовая конфигурация для CI
// playwright.config.ts
import { defineConfig } from '@playwright/test';

export default defineConfig({
  retries: process.env.CI ? 2 : 0,
  reporter: [['list'], ['html', { open: 'never' }]],
  use: {
    trace: 'retain-on-failure',
    screenshot: 'only-on-failure',
    video: 'retain-on-failure',
  },
  workers: process.env.CI ? 1 : undefined,
  maxFailures: 20,
});
Эта конфигурация сохраняет доказательства неудачных попыток и оставляет повторные запуски видимыми в отчёте. Значения 2, 1 и 20 приведены как рабочие примеры, а не как универсальные рекомендации Playwright; команда должна подобрать их с учётом времени выполнения, инфраструктуры и рисков.
4. Сохранение артефактов первого сбоя
Диагностику необходимо включить до запуска теста. Начинать трассировку в afterEach слишком поздно: предыдущие действия в браузере уже нельзя восстановить. Встроенных скриншотов, видео и трассировок достаточно для большинства случаев, а небольшая автоматическая фикстура позволяет дополнительно сохранить сообщения консоли:
// fixtures.ts
import { test as base } from '@playwright/test';

export const test = base.extend<{ consoleEvidence: void }>({
  consoleEvidence: [async ({ page }, use, testInfo) => {
    const messages: string[] = [];
    page.on('console', message => {
      messages.push(`[${message.type()}] ${message.text()}`);
    });

    await use();

    if (testInfo.status !== testInfo.expectedStatus) {
      await testInfo.attach('console.log', {
        body: Buffer.from(messages.join('\n'), 'utf-8'),
        contentType: 'text/plain',
      });
    }
  }, { auto: true }],
});

export { expect } from '@playwright/test';
При trace: 'retain-on-failure' трассировка первой неудачной попытки сохраняется. Скриншот, видео, вложение с сообщениями консоли и данные репортера образуют единый набор доказательств. Если команде нужна трассировка повторной попытки, используйте on-first-retry и зафиксируйте в документации, что первоначальная попытка будет представлена другими артефактами.
5. Процесс триажа нестабильных тестов с помощью ИИ
Ниже представлен процесс с участием человека и учётом рисков. ИИ помогает выявить наиболее вероятную первопричину, но ни один реальный дефект не помещается в карантин автоматически.
┌─────────────────────┐
│ Test finishes (CI) │
└───────┬─────────────┘
        │
        ▼
┌─────────────────────┐
│ Did the test retry? │───── No ──► Mark as PASS/FAIL (no AI needed)
└───────┬─────────────┘
        │ Yes
        ▼
┌─────────────────────┐
│ Collect artifacts:  │
│  – retained failure trace│
│  – retry result/report   │
│  – screenshots, logs    │
│  – network HAR (if enabled)│
└───────┬─────────────┘
        │
        ▼
┌─────────────────────┐
│ Feed artifacts to AI│
│ (LLM or specialized│
│  log‑analysis model)│
└───────┬─────────────┘
        │
        ▼
┌─────────────────────┐
│ AI returns:         │
│  • Probable cause   │
│  • Confidence score│
│  • Suggested action│
└───────┬─────────────┘
        │
        ▼
┌─────────────────────┐
│ Human reviewer checks│
│  – confidence threshold │
│  – evidence checklist   │
│  – risk impact          │
└───────┬─────────────┘
        │
   ┌────┴─────┐
   │          │
   ▼          ▼
Quarantine   Fix / Refactor
(only if   (only after human sign‑off)
human confirms)
5.1 Контрольный список доказательств для проверки человеком
| Пункт | Почему это важно |
|---|---|
| Сохранённая трассировка неудачной попытки | Показывает действия браузера и его состояние при сбое, если используется retain-on-failure. |
| Результат повторного запуска и запись в отчёте | Подтверждает, прошла ли последующая попытка, и сохраняет классификацию результата как нестабильного. |
| Журналы консоли и сети | Помогают выявить тайм-ауты, ответы 5xx и исключения JavaScript. |
| Различия на скриншотах (если включено визуальное сравнение) | Помогают обнаружить различия рендеринга между headless-режимом и режимом с интерфейсом. |
| История запусков (последние 10 выполнений) | Помогает ИИ рассчитать показатель нестабильности, например долю запусков, потребовавших повторной попытки. |
| Метаданные теста (номер повторной попытки, индекс воркера) | Помогают исключить проблемы, связанные с общим состоянием. |
Перед автоматическим исправлением или изменением селектора проверяющий должен ответить на вопрос: «Достаточно ли доказательств того, что сбой вызван нестабильностью теста, а не дефектом продукта?»
5.2 Измеримые показатели нестабильности
| Показатель | Расчёт | Интерпретация |
|---|---|---|
| Доля нестабильных тестов | # tests classified as flaky / # tests executed | Отслеживайте по наборам тестов, веткам и средам; устойчивый рост требует расследования. |
| Доля успешных повторных запусков | # tests that passed on retry / # tests retried | Рост показателя может означать возрастающую зависимость от повторных запусков. |
| Распределение времени до сбоя | Время от начала теста до сбоя в разных запусках | Сравнивайте закономерности; сама по себе длительность не доказывает конкретную первопричину. |
| Оценка уверенности ИИ | Оценка конкретной модели и указанные ею доказательства | Используйте только для приоритизации проверки человеком, но не как разрешение на автоматическое помещение в карантин. |
Эти показатели можно отображать на панелях мониторинга CI, чтобы своевременно выявлять тенденции.
6. Матрица решений для триажа с учётом риска
| Уровень риска | Характер доказательств | Обязательное действие |
|---|---|---|
| Низкий | Воспроизводимая проблема в тестовом коде с однозначными доказательствами и без влияния на продукт | Создать задачу на сопровождение; проверяющий может одобрить исправление, затрагивающее только тест. |
| Средний | Противоречивые доказательства, повторяющиеся повторные запуски или зависимость от среды | Создать задачу на триаж, сохранить артефакты и воспроизвести сбой в контролируемых условиях; не помещать тест в карантин автоматически. |
| Высокий | Возможный дефект продукта, влияние на безопасность или данные либо необъяснимое периодическое поведение | Считать проблемой продукта, пока не доказано обратное; заблокировать автоматическое исправление и потребовать проверки владельцем соответствующей области. |
Матрица намеренно не содержит универсальных порогов в процентах или значений уверенности. Каждая команда должна определить пороги на основе собственных исходных показателей, однако неопределённость и серьёзные последствия всегда требуют расследования человеком.
7. Безопасные границы автоматизации
| Граница | Обоснование |
|---|---|
| Количество повторных попыток явно ограничено | Дополнительные попытки увеличивают затраты и могут сделать нестабильность привычной; точный лимит определяет команда. |
| Режим трассировки выбирается осознанно | retain-on-failure отдаёт приоритет неудачной попытке; режимы, записывающие только повторы, отвечают на другой вопрос. |
| Количество воркеров контролируется | Запуск с одним воркером может помочь диагностировать нехватку ресурсов или зависимость от общего состояния, но не устраняет дефекты изоляции. |
| Нет автоматической перезаписи селекторов | Автоматическое исправление необходимо проверять, иначе дефект пользовательского интерфейса может остаться незамеченным. |
| Хранение артефактов определяется политикой | Храните доказательства достаточно долго для триажа, соблюдая ограничения по объёму, конфиденциальности и безопасности. |
8. Конкретные примеры настройки Playwright
8.1 Конфигурация только для CI (переменная среды CI=true)
// playwright.config.ci.ts
import { defineConfig } from '@playwright/test';

export default defineConfig({
  retries: 2,
  workers: 1,
  maxFailures: 20,
  use: {
    trace: 'retain-on-failure',
    screenshot: 'only-on-failure',
    video: 'retain-on-failure',
    launchOptions: { headless: true },
  },
  reporter: [
    ['list'],
    ['html', { open: 'never', outputFolder: 'playwright-report' }],
  ],
});
8.2 Локальная конфигурация разработчика (без повторных запусков, полная трассировка)
// playwright.config.local.ts
import { defineConfig } from '@playwright/test';

export default defineConfig({
  retries: 0,
  workers: undefined, // default based on CPU cores
  use: {
    trace: 'on', // full local trace; expensive for CI
    screenshot: 'on',
    video: 'on',
  },
});
Переключаться между этими двумя файлами можно с помощью npm-скрипта:
{
  "scripts": {
    "test:ci": "playwright test --config=playwright.config.ci.ts",
    "test:local": "playwright test --config=playwright.config.local.ts"
  }
}
9. Меры безопасности с участием человека
- Ни в коем случае не сливайте PR с тестом, помещённым в карантин, без явного одобрения проверяющего.
- Требуйте комментарий о результатах триажа, в котором должен быть указан как минимум один артефакт (трассировка, журнал или скриншот), обосновывающий принятое решение.
- Регистрируйте каждую рекомендацию ИИ в сводке задания CI, чтобы команда могла проводить аудит ложных срабатываний и пропусков.
- Запланируйте периодический анализ (например, после каждого спринта) панели мониторинга показателей нестабильности, чтобы скорректировать ограничения на количество повторных попыток или усовершенствовать структуру тестов.
Эти меры обеспечивают прозрачность процесса и позволяют избежать ловушки «самовосстановления», когда каждый нестабильный тест незаметно исправляется ИИ без проверки со стороны человека.
10. Пять вопросов при оценке ИИ-агента для триажа нестабильных тестов
- На каких данных ИИ основывает выводы? Проверьте, анализирует ли он исходные трассировки Playwright, журналы консоли, сетевые данные и историю запусков или только предварительно обработанную сводку.
- Как модель выражает неопределённость? Требуйте калиброванной оценки неопределённости со ссылками на доказательства: одного числового показателя уверенности недостаточно.
- Может ли ИИ определить конкретный шаг, который различался при сбое и повторной попытке? Ответ должен ссылаться на конкретное действие или артефакт, а не ограничиваться формулировкой «проблема с синхронизацией».
- Как ведётся журнал аудита предлагаемого автоматического исправления? Фиксируйте исходный локатор или поведение, предлагаемое изменение и подтверждающие материалы.
- Как ИИ обрабатывает случаи с неизвестной причиной? Он должен направлять их на ручную проверку, а не по умолчанию помещать тест в карантин или автоматически исправлять его.
Эти вопросы помогают руководителям QA убедиться, что ИИ служит инструментом поддержки принятия решений, а не принимает решения самостоятельно.
11. В каких случаях автоматизация помогает
- Быстрый сбор данных — встроенные функции трассировки, создания скриншотов и сбора данных HAR в Playwright позволяют получить детерминированный снимок состояния, который было бы утомительно собирать вручную.
- Распознавание закономерностей — большие языковые модели отлично справляются с установлением взаимосвязей между сообщениями об ошибках, полученными в ходе множества прогонов, выявляя повторяющиеся сетевые таймауты или нестабильность селекторов, которые человеку могут ускользнуть из виду.
- Приоритезация — Оценивая вероятность нестабильности тестов, ИИ может в первую очередь выявлять наиболее опасные нестабильные тесты, что позволяет команде направить ограниченные ресурсы туда, где это наиболее важно.
- Единообразная отчётность — автоматизированные задания CI генерируют унифицированные наборы артефактов, что делает анализ сбоев воспроизводимым.
Таким образом, автоматизация служит усилителем эффективности: она предоставляет данные, искусственный интеллект помогает их интерпретировать, а человек-эксперт принимает окончательное решение.
12. Заключение
Нестабильные тесты Playwright не обязательно должны становиться скрытой угрозой для качества продукта. Благодаря продуманной настройке повторных попыток, фиксации состояния при первом сбое и передаче всех артефактов в конвейер триажа с помощью ИИ команды могут отличать настоящие дефекты от проблем тестового кода. Описанный здесь рабочий процесс позволяет сохранить важные доказательства, количественно оценить нестабильность и обеспечить применение матрицы принятия решений на основе оценки рисков, которая всегда требует подтверждения человеком перед выполнением каких-либо действий по самовосстановлению или изоляции. При ответственном использовании автоматизация и ИИ становятся мощными союзниками в поддержании надёжного набора тестов, при этом ручное тестирование и исследовательское тестирование остаются в центре обеспечения качества.
Источники
- Hari Gokul — Why Flaky Tests Are More Dangerous Than Failed Tests
- Документация Playwright — Повторные запуски
- Документация Playwright — Trace Viewer
- Документация Playwright — Репортёры
Для фактических утверждений использованы только исходная статья и официальная документация Playwright.
Оставить комментарий
Поделитесь своим мнением о статье. Регистрация не требуется.
Комментарии
Загрузка комментариев…