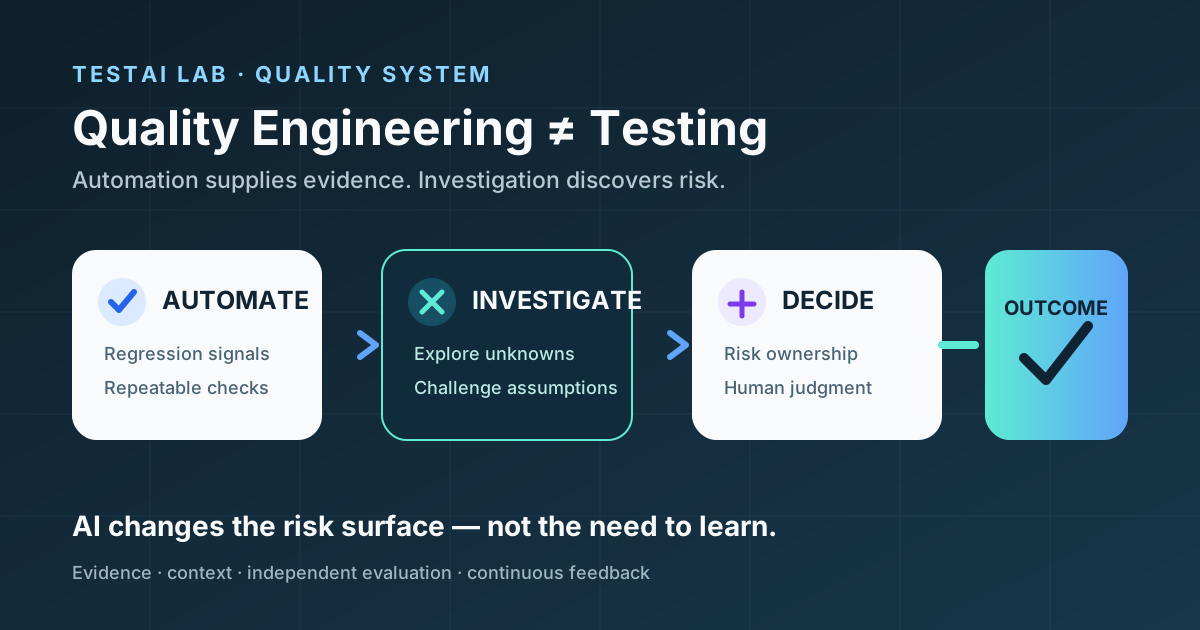
Eine grüne Pipeline liefert einen nützlichen Nachweis. Sie beweist jedoch nicht, dass ein KI-gestütztes Produkt sicher, nützlich oder für jede Situation geeignet ist, in der Menschen es einsetzen werden.
Diese Unterscheidung ist wichtig, weil das Verhalten von KI von Daten, Prompts, abgerufenem Kontext, Modellversionen, Berechtigungen und dem umgebenden Arbeitsablauf abhängt. Eine deterministische API kann für denselben Input dasselbe Ergebnis zurückgeben. Eine modellbasierte Funktion kann mehrere plausible Ergebnisse liefern, nur für eine bestimmte Nutzergruppe scheitern oder nach Änderungen an ihrer Wissensquelle weniger zuverlässig werden.
Qualitätsengineering ermöglicht es Teams, dieses umfassendere System zu steuern. Es ersetzt Testing nicht und ist kein modischer Name für Testautomatisierung. Es verbindet Anforderungen, Design, Testing, Observability, Sicherheit, Betrieb und Produktentscheidungen, sodass Risiken über den gesamten Lebenszyklus hinweg erkannt und adressiert werden.
Testing, Testautomatisierung und Qualitätsengineering
Die drei Aktivitäten unterstützen einander, beantworten aber unterschiedliche Fragen.
- Testing dient der Untersuchung. Tester entwerfen Experimente, hinterfragen Annahmen, gehen überraschendem Verhalten nach und untersuchen, wodurch der Produktnutzen gefährdet wird.
- Testautomatisierung prüft bekannte Erwartungen wiederholt. Sie eignet sich hervorragend für Verträge, Regressionssignale, Datenvalidierung, Berechtigungen, Latenzschwellenwerte und andere klar formulierbare Bedingungen.
- Qualitätsengineering koordiniert das gesamte Arbeitssystem. Es unterstützt das Team dabei zu entscheiden, welche Risiken relevant sind, welche Nachweise benötigt werden, wer für eine Entscheidung verantwortlich ist und wie Produktionsfeedback die weitere Arbeit beeinflusst.
Automatisierung liefert daher Nachweise; sie interpretiert nicht jede Konsequenz dieser Nachweise. Ein Dashboard kann eine Erfolgsquote von 92 % melden. Menschen müssen weiterhin beurteilen, ob der Datensatz reale Nutzer repräsentiert, ob sich unter den verbleibenden 8 % schwerwiegende Fehler befinden und ob die Kennzahl die tatsächliche geschäftliche Anforderung abbildet.
Das NIST AI Risk Management Framework behandelt das KI-Risikomanagement als eine Lebenszyklusaktivität, die um die vier Funktionen GOVERN, MAP, MEASURE und MANAGE organisiert ist. Die zugehörigen Ressourcen betonen Test, Evaluation, Verifizierung und Validierung (TEVV), Kontext, Dokumentation und fortlaufende Bewertung. Daraus folgt eine praktische Schlussfolgerung: Evaluation ist kein abschließendes Quality Gate, das allein der QA gehört. Sie ist eine gemeinsame, wiederkehrende Aktivität.
Ein Betriebsmodell mit fünf Ebenen
Ein kleines Team kann fünf Ebenen nutzen, ohne einen schwerfälligen Prozess einzuführen.
- Anforderungen und Risikoanalyse. Beschreiben Sie die vorgesehenen Nutzer, erlaubten Aktionen, unzulässigen Ergebnisse, Datengrenzen und Folgen eines Fehlers. Ordnen Sie jedem wesentlichen Risiko eine verantwortliche Person und ein beobachtbares Signal zu.
- Deterministische Softwareprüfungen. Testen Sie APIs, Schemata, Zugriffsregeln, Integrationen, Wiederholungsversuche, Timeouts, Logging und Fallback-Verhalten. Diese Prüfungen sollten reproduzierbar und für CI geeignet sein.
- KI-Evaluation und Unsicherheit. Bewerten Sie repräsentative Aufgaben sowie Groundedness, Retrieval-Qualität, Ablehnungsverhalten, Robustheit und relevante Fairness- oder Sicherheitseigenschaften. Dokumentieren Sie Datensätze, Prompts, Modellversionen, Schwellenwerte und bekannte Einschränkungen.
- Exploratives und soziotechnisches Testing. Lassen Sie Tester, Fachexperten, Sicherheitsspezialisten und repräsentative Nutzer mehrdeutige Szenarien untersuchen. Analysieren Sie, wie Menschen die Ergebnisse interpretieren und wie sich die KI im realen Arbeitsablauf verhält.
- Produktionsmonitoring und Feedback. Beobachten Sie Latenz, Fehler, Retrieval-Drift, verweigerte Zugriffe, Eskalationen, Nutzerkorrekturen und Incidents. Überführen Sie die gewonnenen Erkenntnisse in die Risikoanalyse und die Regressionstestsuiten.
Die Ebenen bilden kein Wasserfallmodell. Eine Erkenntnis aus der Produktion kann eine Anforderung verändern. Eine explorative Testsession kann eine neue deterministische Prüfung aufzeigen. Ein Modellupdate kann eine erneute Evaluation erfordern, selbst wenn der Anwendungscode unverändert bleibt.
Beispiel: ein KI-Support-Assistent
Stellen Sie sich einen Support-Assistenten vor, der internes Wissen abruft und eine Eskalation an einen menschlichen Supportmitarbeiter vorbereiten kann. Die Unit-Tests bestehen, die API-Verträge sind gültig, und der Evaluationsdatensatz zeigt eine gute Relevanz der Antworten. Dennoch kann das Release in wichtigen Punkten scheitern.
- Unklare Anforderung: „Anfragen schnell lösen“ definiert nicht, wann der Assistent seine Bearbeitung beenden und eskalieren muss.
- Retrieval-Drift: Durch eine Änderung der Indexierung werden veraltete Richtlinien höher eingestuft als aktuelle.
- Unbefugte Offenlegung: Eine korrekt wirkende Antwort enthält Informationen, auf die der aktuelle Nutzer nicht zugreifen darf.
- Unsichere Eskalation: Der Assistent erstellt oder routet ein Ticket ohne die vom Geschäftsprozess geforderte Bestätigung.
- Latenz- und Kostenspitzen: Lange Retrieval-Ketten funktionieren in einer kleinen Testumgebung, scheitern aber unter realer Last.
- Schaden für Nutzer: Eine überzeugend formulierte Antwort verleitet einen Nutzer dazu, ihr außerhalb des freigegebenen Anwendungsbereichs des Assistenten zu vertrauen.
Mehr Automatisierung hilft bei einigen dieser Risiken. Berechtigungsmatrizen, Retrieval-Regressionstests, Lasttests und Prüfungen der Audit-Logs sollten automatisiert werden. Automatisierung allein kann jedoch nicht entscheiden, ob „schnell“ die Absicht des Stakeholders widerspiegelt, ob eine Ablehnung im jeweiligen Kontext angemessen ist oder ob eine plausible Antwort inakzeptablen Schaden verursacht.
Genau hier bleiben exploratives Testing und die Beurteilung durch Fachexperten unverzichtbar.
Verantwortung ohne Diskussionen über Stellenbezeichnungen
Die genauen Stellenbezeichnungen sind weniger wichtig als eine klar zugewiesene Verantwortung.
- Das Produktteam verantwortet den angestrebten Nutzen, die Akzeptanzkriterien und die Priorisierung von Risiken.
- Das Engineering-Team verantwortet die Implementierungsqualität, deterministische Kontrollmaßnahmen und diagnostizierbare Fehler.
- KI- oder Datenspezialisten verantworten die Dokumentation von Modellen und Datensätzen, das Evaluationsdesign und die Berichterstattung über Unsicherheiten.
- QA verantwortet die Untersuchungsstrategie, Risiken für die Testbarkeit, Nachweislücken und die unabhängige kritische Prüfung.
- Security verantwortet Bedrohungsanalysen, Missbrauchsszenarien, Zugriffsgrenzen und den Umgang mit Secrets.
- Operations verantwortet Monitoring, Incident-Signale, Rollback-Bereitschaft und Produktionsfeedback.
- Vertreter der Fachdomäne und der Nutzer helfen dabei zu beurteilen, ob das Verhalten nützlich, sicher und verständlich ist.
„Qualität liegt in der Verantwortung aller“ wird erst dann konkret, wenn für jede Entscheidung und jeden Nachweis eine bestimmte Person verantwortlich ist.
Checkliste der Nachweise vor dem Release
Fordern Sie vor dem Release Nachweise an, die dem tatsächlichen Produktrisiko entsprechen. Eine praktische Checkliste lautet:
- Wesentliche Anforderungen und unzulässige Ergebnisse sind in testbarer Sprache formuliert.
- Risiken mit hohen Auswirkungen sind verantwortlichen Personen und Kontrollmaßnahmen zugeordnet und verfügen über beobachtbare Fehlersignale.
- Deterministische Prüfungen decken Schnittstellen, Berechtigungen, Fehlerbehandlung und Fallback-Pfade ab.
- KI-Evaluationen dokumentieren Datensatz, Prompts, Modellversion, Kennzahlen, Schwellenwerte und Einschränkungen.
- Eine von der Implementierung unabhängige Person hat die wichtigsten Annahmen kritisch hinterfragt.
- Exploratives Testing deckt mehrdeutige, adversariale und realistische End-to-End-Szenarien ab.
- Das Produktionsmonitoring kann Regressionen erkennen, die Tests vor dem Release möglicherweise übersehen.
- Das Team verfügt über Kriterien für Rollback, Deaktivierung und Incident Response.
Die Checkliste ist keine universelle Zertifizierung. Der Umfang der Nachweise sollte dem jeweiligen Kontext entsprechen. Eine Schreibhilfe mit geringen möglichen Auswirkungen und ein Assistent, der vertrauliche Informationen offenlegen kann, erfordern unterschiedlich umfangreiche Nachweise, Reviews und Schwellenwerte.
Häufige Antimuster
Achten Sie auf diese Warnzeichen:
- Eine grüne CI-Pipeline als Argument für ein Release zu behandeln, ohne nicht abgedeckte Risiken zu diskutieren.
- Einen einzelnen Genauigkeitswert als vollständiges Maß für Vertrauenswürdigkeit zu verwenden.
- Den Entwicklungsdatensatz zugleich als einzigen Evaluationsdatensatz zu verwenden.
- Das Modell zu testen, aber Retrieval, Berechtigungen, Benutzeroberfläche und nachgelagerte Aktionen zu ignorieren.
- Eine Evaluation nur einmal durchzuführen und sie nach Änderungen an Modell, Prompt, Daten oder Richtlinien nicht zu wiederholen.
- Produktionskennzahlen ohne verantwortliche Person oder Reaktionsschwelle zu erfassen.
- Jede automatisierte Prüfung als „Testing“ zu bezeichnen und keine Zeit für Untersuchungen einzuplanen.
Diese Antimuster erzeugen Aktivität, aber keinen verlässlichen Erkenntnisgewinn.
Ein einwöchiger Einführungsplan
Ein Team kann beginnen, ohne das Unternehmen neu zu organisieren.
- Wählen Sie am ersten Tag eine KI-gestützte Funktion aus und dokumentieren Sie ihren vorgesehenen Einsatz, ihre unzulässige Verwendung und die fünf wichtigsten Risiken.
- Erfassen Sie am zweiten Tag die bestehenden automatisierten Prüfungen und ermitteln Sie, für welche Risiken keine Nachweise vorliegen.
- Fügen Sie am dritten Tag eine deterministische Prüfung für das wichtigste noch nicht abgedeckte technische Risiko hinzu.
- Erstellen Sie am vierten Tag einen kleinen, versionierten Evaluationsdatensatz und dokumentieren Sie die Modell- und Prompt-Konfiguration.
- Führen Sie am fünften Tag gemeinsam mit QA und einem Fachexperten eine fokussierte explorative Testsession durch.
- Überprüfen Sie am sechsten Tag Monitoring, Rollback und die Zuständigkeiten für Incidents in einer sicheren Umgebung.
- Überprüfen Sie am siebten Tag gemeinsam mit dem Produkt- und Engineering-Team die Nachweise, ungelösten Risiken und nächsten Schritte.
Das Ziel ist kein perfektes Framework innerhalb von sieben Tagen. Es ist eine sichtbare Feedbackschleife, in der Nachweise Entscheidungen beeinflussen.
Fazit
KI macht diszipliniertes Testing nicht überflüssig. Sie macht die Abgrenzung zwischen wiederholbaren Prüfungen und menschlicher Untersuchung wichtiger.
Automatisieren Sie stabile Erwartungen. Bewerten Sie das Modellverhalten anhand eines dokumentierten Kontexts. Untersuchen Sie, was das Team noch nicht versteht. Überwachen Sie das reale System. Nutzen Sie anschließend Qualitätsengineering, um diese Signale mit klar verantworteten Entscheidungen zu verknüpfen.
So gelangt ein Team von „Die Pipeline ist grün“ zu einer besser begründbaren Aussage: „Wir verstehen die wesentlichen Risiken, verfügen über relevante Nachweise und wissen, wie wir reagieren, wenn sich diese Nachweise ändern.“
Kommentar hinterlassen
Teilen Sie Ihre Gedanken zum Artikel. Kein Konto erforderlich.
Kommentare
Kommentare werden geladen…