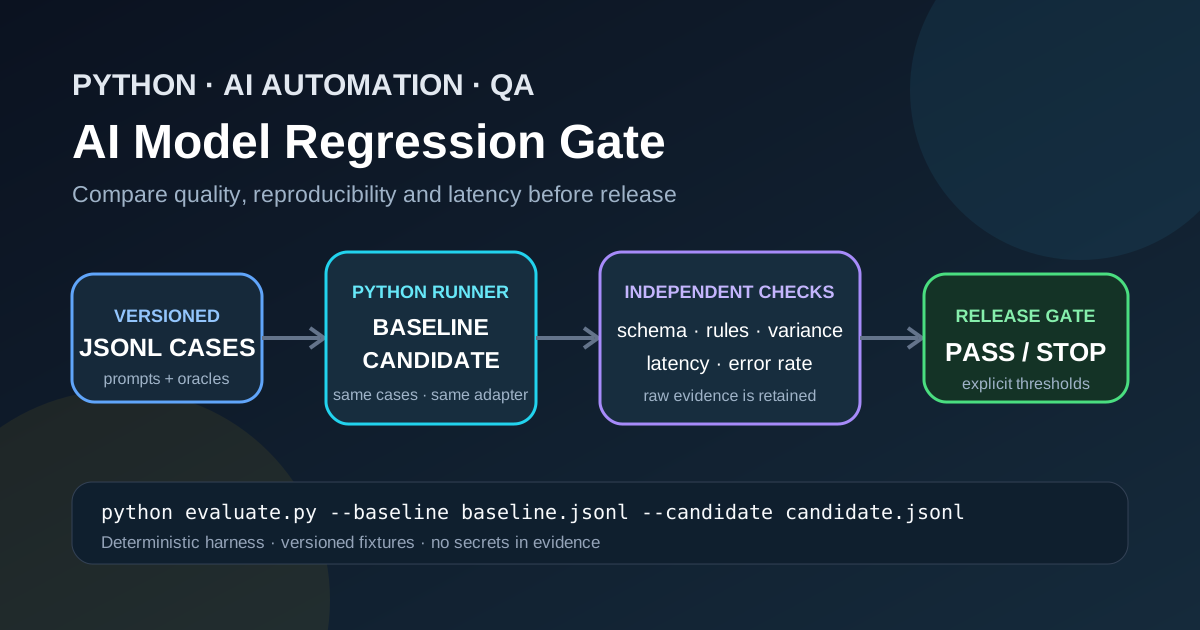
Eine Änderung des KI-Modells, der Prompt-Vorlage, der Temperatur, einer Tool-Definition oder der Retrieval-Konfiguration kann das Verhalten beeinflussen, ohne dass sich der Anwendungscode ändert. Eine erfolgreiche Unit-Testsuite beweist daher nicht, dass die neue Konfiguration sicher ist. Ein praxistaugliches Release-Gate muss den Kandidaten anhand derselben versionierten Testfälle mit einer bekannten Baseline vergleichen und genügend Nachweise speichern, um jede Entscheidung erklären zu können.
Dieser Artikel entwickelt ein kleines, anbieterneutrales Gate in Python. Es prüft die JSON-Struktur und Geschäftsregeln, wiederholt Testfälle, um Instabilität sichtbar zu machen, misst die Latenz, vergleicht die Kennzahlen des Kandidaten mit einer Baseline und liefert einen Exitcode ungleich null, wenn das vereinbarte Regressionsbudget überschritten wird. Das Gate ruft keine bestimmte kommerzielle API auf und enthält keine Zugangsdaten.
1. Die Entscheidung vor der Implementierung des Runners definieren
Beginnen Sie mit einer eindeutigen Release-Richtlinie. Zum Beispiel:
- Jede Antwort muss gültiges JSON sein und das Schema des jeweiligen Testfalls erfüllen.
- Deterministische Geschäftsregeln müssen bei jedem Durchlauf erfüllt sein.
- Die Erfolgsquote des Kandidaten darf nicht unter der Erfolgsquote der Baseline liegen.
- Die p95-Latenz des Kandidaten darf höchstens 20 % über der Baseline und nicht über einem absoluten Grenzwert liegen.
- Transportfehler, Timeouts und Ratenbegrenzungen werden getrennt von Qualitätsfehlern ausgewiesen.
- Ein Mensch prüft eine festgelegte Stichprobe der Ausgaben auf Bedeutung, Tonalität und schädliches Verhalten.
Der letzte Punkt ist wichtig. Eine Schemavalidierung kann nachweisen, dass ein Feld vorhanden ist. Sie kann jedoch weder die fachliche Richtigkeit einer Empfehlung noch die Vollständigkeit der wesentlichen Fakten in einer Zusammenfassung belegen. Automatisierte Testorakel und menschliche Evaluation beantworten unterschiedliche Fragen.
2. Testfälle und erwartetes Verhalten versionieren
JSON Lines eignet sich gut für einen kleinen Evaluationskorpus, weil jede Zeile ein eigenständiges JSON-Objekt enthält. Speichern Sie Prompts, Regeln und Testfallkennungen in der Versionsverwaltung.
{"case_id":"ticket-001","prompt":"Classify: Payment failed twice","schema":{"type":"object","required":["category","priority"],"properties":{"category":{"type":"string","enum":["billing","technical","other"]},"priority":{"type":"string","enum":["low","medium","high"]}},"additionalProperties":false},"contains":["billing"]}
{"case_id":"ticket-002","prompt":"Classify: How do I change my password?","schema":{"type":"object","required":["category","priority"],"properties":{"category":{"type":"string"},"priority":{"type":"string"}},"additionalProperties":false},"contains":["technical"]}
Wenn sich ein Prompt oder ein Testorakel ändert, ändert sich auch das Testartefakt. Erfassen Sie den Git-Commit und einen stabilen Hash, damit sich später exakt reproduzieren lässt, was das Gate ausgewertet hat.
Die Python-Dokumentation zu json weist darauf hin, dass nicht vertrauenswürdige JSON-Daten erhebliche CPU- oder Speicherressourcen beanspruchen können. Begrenzen Sie daher vor dem Parsen sowohl die Dateigröße als auch die Größe einzelner Zeilen.
import hashlib
import json
from pathlib import Path
from typing import Any

MAX_FILE_BYTES = 1_000_000
MAX_LINE_BYTES = 16_384

def load_cases(path: Path) -> list[dict[str, Any]]:
    if path.stat().st_size > MAX_FILE_BYTES:
        raise ValueError("case file is too large")

    cases: list[dict[str, Any]] = []
    with path.open(encoding="utf-8") as source:
        for number, line in enumerate(source, start=1):
            if not line.strip():
                continue
            if len(line.encode("utf-8")) > MAX_LINE_BYTES:
                raise ValueError(f"line {number} is too large")
            case = json.loads(line)
            if not {"case_id", "prompt", "schema"} <= case.keys():
                raise ValueError(f"line {number} misses required case fields")
            cases.append(case)
    return cases

def case_hash(case: dict[str, Any]) -> str:
    canonical = json.dumps(case, sort_keys=True, separators=(",", ":"))
    return hashlib.sha256(canonical.encode("utf-8")).hexdigest()
3. Den Anbieter hinter einem Adapter kapseln
Das Gate sollte nicht wissen müssen, ob das Modell über eine gehostete API, einen lokalen Server oder einen n8n-Sub-Workflow bereitgestellt wird. Geben Sie dem Runner einen einzigen aufrufbaren Vertrag: Er erhält Eingabetext und gibt ein geparstes Dictionary zurück. Der Adapter ist für Authentifizierung, Timeout-Behandlung, das Parsen der Antwort und anbieterspezifische Parameter zuständig.
Protokollieren Sie keine Autorisierungsheader oder unveränderten Prompts mit personenbezogenen Daten. Lesen Sie Secrets aus Umgebungsvariablen oder dem Secret Store der CI-Plattform, schwärzen Sie sensible Antwortfelder und bewahren Sie nur die für die Fehleranalyse erforderlichen Nachweise auf.
Verwenden Sie time.perf_counter() zur Messung der verstrichenen Zeit. Die Python-Dokumentation beschreibt diese Funktion als hochauflösenden Performance-Counter, der sich zur Messung kurzer Zeitintervalle eignet.
import time
from collections.abc import Callable

ModelCall = Callable[[str], dict[str, Any]]

def timed_call(call: ModelCall, prompt: str) -> tuple[dict[str, Any], float]:
    started = time.perf_counter()
    result = call(prompt)
    return result, time.perf_counter() - started
4. Unabhängige deterministische Testorakel anwenden
JSON Schema prüft den Antwortvertrag. Das Python-Paket jsonschema stellt versionierte Validatoren bereit, darunter Draft202012Validator und die Methode iter_errors. Validieren Sie zunächst das Schema selbst. Andernfalls kann ein fehlerhaftes Testorakel irreführende Ergebnisse erzeugen.
import re
from jsonschema import Draft202012Validator

def deterministic_errors(output: dict[str, Any], case: dict[str, Any]) -> list[str]:
    schema = case["schema"]
    Draft202012Validator.check_schema(schema)
    validator = Draft202012Validator(schema)

    errors = [error.message for error in validator.iter_errors(output)]
    rendered = json.dumps(output, ensure_ascii=False)

    for fragment in case.get("contains", []):
        if fragment.casefold() not in rendered.casefold():
            errors.append(f"missing required fragment: {fragment}")

    pattern = case.get("regex")
    if pattern and re.search(pattern, rendered) is None:
        errors.append("response does not match the required regex")

    return errors
Diese Prüfungen sind unabhängig, weil nicht das Kandidatenmodell selbst entscheidet, ob es bestanden hat. Eine modellbasierte Bewertung kann für Stil oder semantische Ähnlichkeit hilfreich sein. Sie sollte jedoch als separates Signal mit eigener Kalibrierung und Überprüfung ausgewiesen und nicht unbemerkt mit der deterministischen Bestanden-/Nicht-bestanden-Logik vermischt werden.
5. Testfälle wiederholen und vergleichbare Kennzahlen berechnen
Ein einzelner erfolgreicher Aufruf verdeckt mögliche Schwankungen. Führen Sie jeden Testfall mit derselben Konfiguration für Baseline und Kandidat mehrmals aus. Erfassen Sie jede Fehlerkategorie, statt Wiederholungsversuche unbemerkt fortzusetzen, bis der Test erfolgreich ist. Begrenzte Wiederholungsversuche können bei HTTP 429 oder ausgewählten 5xx-Antworten sinnvoll sein. Der ursprüngliche Fehler und die Anzahl der Versuche müssen jedoch Teil der Nachweise bleiben.
Bei einer kleinen beobachteten Stichprobe hält ein inklusives Perzentil den berechneten p95-Wert zwischen dem Minimum und Maximum der Stichprobe. Die Python-Dokumentation zu statistics.quantiles unterscheidet zwischen inklusiven und exklusiven Methoden.
from statistics import quantiles

def evaluate(call: ModelCall, cases: list[dict[str, Any]], repeats: int = 5) -> dict:
    latencies: list[float] = []
    passed = 0
    total = 0
    evidence: list[dict[str, Any]] = []

    for case in cases:
        for run_number in range(1, repeats + 1):
            total += 1
            try:
                output, elapsed = timed_call(call, case["prompt"])
                problems = deterministic_errors(output, case)
                latencies.append(elapsed)
                passed += int(not problems)
                evidence.append({
                    "case_id": case["case_id"],
                    "case_hash": case_hash(case),
                    "run": run_number,
                    "elapsed_s": round(elapsed, 4),
                    "problems": problems,
                })
            except Exception as exc:
                evidence.append({
                    "case_id": case["case_id"],
                    "case_hash": case_hash(case),
                    "run": run_number,
                    "error_type": type(exc).__name__,
                })

    p95 = quantiles(latencies, n=100, method="inclusive")[94] if len(latencies) >= 2 else (latencies[0] if latencies else float("inf"))
    return {"pass_rate": passed / total, "p95_s": p95, "evidence": evidence}
Bei stochastisch erzeugtem Text messen exakte Hashes der Ausgabe in der Regel Gleichheit statt Korrektheit. Bevorzugen Sie wiederholt ausgeführte Testorakel sowie eine kalibrierte semantische oder menschliche Überprüfung. Wenn der Anbieter einen Seed bereitstellt, erfassen Sie ihn. Versprechen Sie jedoch keine Reproduzierbarkeit, die der Anbieter nicht garantiert.
6. Baseline und Kandidat anhand expliziter Budgets vergleichen
Das Gate sollte Gleiches mit Gleichem vergleichen: denselben Korpus, denselben Adaptervertrag, dieselbe Anzahl von Wiederholungen, denselben Timeout und dieselbe Umgebung.
def release_allowed(baseline: dict, candidate: dict) -> tuple[bool, list[str]]:
    reasons: list[str] = []

    if candidate["pass_rate"] < baseline["pass_rate"]:
        reasons.append("candidate pass rate is below baseline")

    absolute_limit_s = 2.0
    relative_limit_s = baseline["p95_s"] * 1.20
    if candidate["p95_s"] > min(absolute_limit_s, relative_limit_s):
        reasons.append("candidate p95 latency exceeds the regression budget")

    return not reasons, reasons
Legen Sie die Schwellenwerte anhand des Produktrisikos und realer historischer Daten fest. Ein Klassifikator für den Payment-Support und ein internes Brainstorming-Tool sollten nicht dieselbe Release-Richtlinie verwenden.
Speichern Sie einen bereinigten JSON-Bericht mit den Modell- und Konfigurationskennungen, dem Commit des Testfallkorpus, den Hashes, der Anzahl der Wiederholungen, der Umgebung, den Kennzahlen, den Fehlern und der Entscheidung. Speichern Sie weder Secrets noch unnötige Kundendaten.
7. Testfälle mit pytest wiederverwenden
Der Marker @pytest.mark.parametrize von pytest führt denselben Test mit mehreren Argumentsätzen aus. Die Dokumentation weist außerdem darauf hin, dass Parameterwerte unverändert übergeben werden. Das Verändern eines Dictionary kann sich daher auf spätere Testaufrufe auswirken. Laden Sie unveränderliche Testdaten während der Test-Collection und verändern Sie sie nicht.
import os
import pytest

CASES = load_cases(Path("tests/cases.jsonl"))

@pytest.fixture
def candidate_model():
    return build_model_adapter(
        endpoint=os.environ["CANDIDATE_ENDPOINT"],
        token=os.environ["CANDIDATE_TOKEN"],
    )

@pytest.mark.parametrize("case", CASES, ids=lambda case: case["case_id"])
def test_candidate_contract(case, candidate_model):
    output, _ = timed_call(candidate_model, case["prompt"])
    assert deterministic_errors(output, case) == []
Der vollständige Vergleichs-Runner kann als separater CI-Befehl ausgeführt werden. Wenn release_allowed den Wert false zurückgibt, gibt der Runner prägnante Gründe aus und wird mit Exitcode 1 beendet. Damit erhalten GitHub Actions, Jenkins, Azure DevOps oder n8n ein eindeutiges, maschinenlesbares Gate.
8. Fehlerbehandlung und Nachweise
Halten Sie die Fehlerkategorien unterscheidbar:
- Ein Validierungsfehler bedeutet, dass die Ausgabe einen bekannten Vertrag verletzt hat.
- Ein Transportfehler bedeutet, dass der Anbieteraufruf nicht abgeschlossen wurde.
- Timeouts und Ereignisse aufgrund von Ratenbegrenzungen weisen auf ein Verfügbarkeits- oder Kapazitätsrisiko hin.
- Infrastrukturfehler bedeuten, dass die Evaluation selbst nicht zuverlässig ist.
- Ein Fehler bei der semantischen Überprüfung bedeutet, dass die Struktur korrekt war, der Inhalt jedoch nicht.
Wenn die Nachweise für ein risikoreiches Release unvollständig sind, muss das Gate die Freigabe verweigern. Bei einem Experiment mit geringem Risiko kann sich das Team für eine Warnung entscheiden. Diese Entscheidung sollte jedoch in der Richtlinie sichtbar und nicht im Code verborgen sein.
9. Release-Checkliste
- Prüfen Sie, dass Testfallkorpus, Schemata, Prompts und Schwellenwerte überprüft und versioniert sind.
- Führen Sie Baseline und Kandidat mit derselben Konfiguration und in derselben Umgebung aus.
- Stellen Sie sicher, dass Secrets sicher injiziert und Logs geschwärzt werden.
- Prüfen Sie deterministische Fehler, Transportfehler, Wiederholungsversuche, die Differenz der Erfolgsquoten und die p95-Latenz.
- Prüfen Sie die vorgeschriebene menschliche Stichprobe hinsichtlich fachlicher Richtigkeit, Sicherheit und Auswirkungen auf Nutzer.
- Speichern Sie den bereinigten Bericht zusammen mit den Commit- und Konfigurationskennungen.
- Geben Sie den Kandidaten nur frei, wenn alle vorgeschriebenen Gates bestanden sind.
10. Fehlerbehebung
Wenn jeder Testfall bei der Schemavalidierung fehlschlägt, validieren Sie zunächst das Schema und prüfen Sie, ob der Adapter die Antwort des Anbieters in das erwartete Objekt geparst hat. Steigt die p95-Latenz stark an, trennen Sie die Drosselung durch den Anbieter von Änderungen an der Anwendung und vergleichen Sie die Werte in derselben Umgebung. Schwanken die Ergebnisse bei Temperatur null, behandeln Sie diese Schwankungen als beobachtetes Verhalten. Eine Temperatur von null ist keine allgemeingültige Garantie für Determinismus. Wenn die CI-Plattform ein Secret nicht lesen kann, prüfen Sie dessen Namen und Geltungsbereich, ohne den Wert auszugeben. Schlägt das Parsen der JSONL-Datei fehl, validieren Sie jede Zeile einzeln und geben Sie ausschließlich die Zeilennummer aus, keine sensiblen Inhalte.
Fazit
Ein Python-Regressions-Gate macht die Änderung eines KI-Modells zu einer überprüfbaren Engineering-Entscheidung. Versionierte Testfälle sorgen für Rückverfolgbarkeit, unabhängige Testorakel prüfen Verträge, wiederholte Durchläufe machen Instabilität sichtbar, Latenzbudgets schützen die Nutzererfahrung und ein Exitcode ungleich null verhindert eine unsichere Bereitstellung. Am stärksten ist das Gate, wenn seine Grenzen ausdrücklich benannt sind: Deterministische Automatisierung weist nur nach, was ihre Testorakel messen. Semantische Qualität und Geschäftsrisiken erfordern weiterhin eine kalibrierte Evaluation und menschliches Urteilsvermögen.
Kommentar hinterlassen
Teilen Sie Ihre Gedanken zum Artikel. Kein Konto erforderlich.
Kommentare
Kommentare werden geladen…