Wie ersetzt man die vage Behauptung „100 % QA‑tested“ durch eine konkrete, auditierbare Release‑Gate‑Pipeline.
Einleitung
Jedes Team, das eine Webanwendung ausliefert, möchte Vertrauen darin, dass der Code, der in die Produktion kommt, für echte Nutzer funktioniert. Marketingtexte reduzieren dieses Vertrauen oft auf einen Slogan wie "100 % QA-getestet". Der Ausdruck ist attraktiv, beschreibt aber nicht was getestet wurde, wie Fehler entdeckt werden oder welche Beweise für eine spätere Überprüfung gespeichert werden.
Ein verteidigungsfähigerer Ansatz ist es, die CI/CD-Pipeline selbst als eine Reihe von Release-Gates zu behandeln. Jedes Gate hat ein deterministisches Pass/Fail-Kriterium, erzeugt unveränderliche Beweise und ist auf eine bestimmte Risikofläche beschränkt. Wenn ein Gate scheitert, stoppt die Pipeline; wenn sie passiert, läuft das nächste Gate. Das letzte Gate ist eine explizite menschliche Entscheidung, die die angesammelten Beweise verbraucht.
Nachfolgend finden Sie ein praktisches Design für eine kleine Webanwendung (z. B. eine Produktkatalogseite), die acht Gates in GitHub Actions implementiert. Das Design basiert auf offizieller Dokumentation für Playwright, GitHub Actions, Lighthouse CI und OWASP ZAP und zeigt, wie man fehlerhafte Tests ehrlich hält, Spuren erhält und vermeidet, dass eine KI-generierte Zusammenfassung zur Veröffentlichungsentscheidung wird.
Das Problem mit "100 % QA-getestet"
- Unüberprüfbarer Umfang – "100 %" sagt nichts darüber aus, welche User Journeys, APIs oder nicht-funktionale Anforderungen abgedeckt wurden.
- Keine Beweise – Ohne Artefakte (Screenshots, Protokolle, Berichte) kann die Behauptung nicht nachträglich überprüft werden.
- Alles-oder-nichts-Mentalität – Teams können einen einzelnen grünen Check als pauschale Genehmigung behandeln und dabei die Feinheiten der Beratungsergebnisse ignorieren (z. B. eine Leistungswarnung, die die Freigabe nicht blockiert).
Die Ersetzung des Slogans durch ein evidenzbasiertes Gate-Modell zwingt das Team, für jedes Gate drei Fragen zu beantworten:
- Welches Risiko deckt das Tor?
- Welche deterministische Bedingung bestimmt Bestehen/Nichtbestehen?
- Welche Artefakte werden für spätere Prüfungen aufbewahrt?
Die folgenden Abschnitte gehen durch jedes Tor, die Signale, die es beweisen kann, seine Grenzen und die praktischen Schritte, die nötig sind, um es durchzusetzen.
Entwicklung einer evidenzbasierten Release Gate-Pipeline
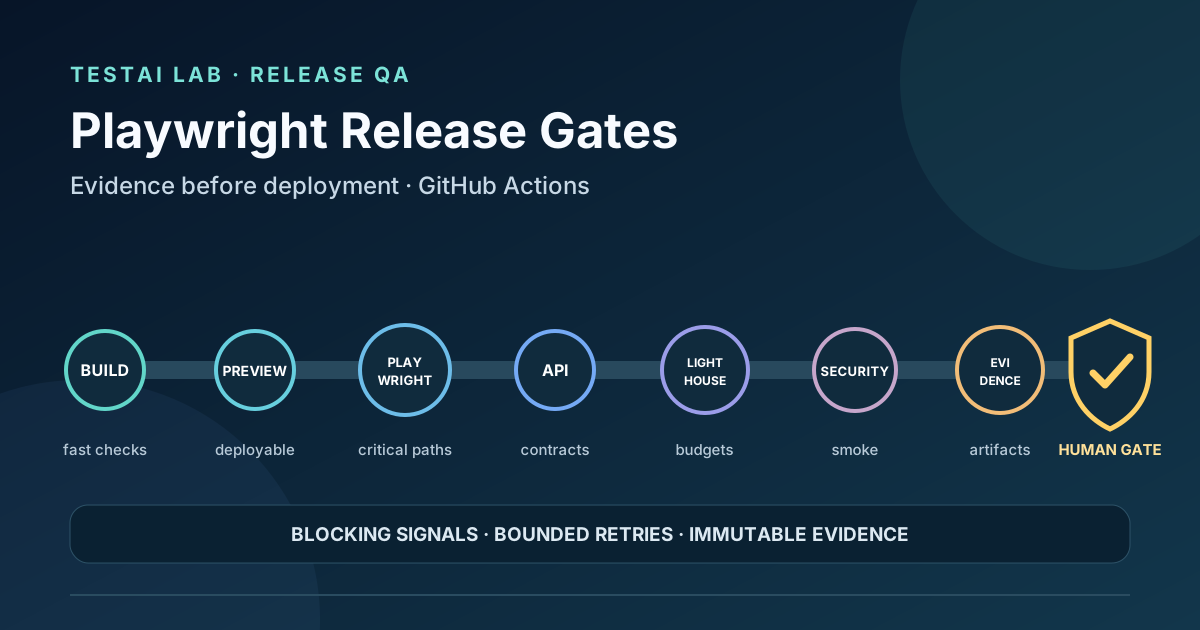
Die Pipeline wird als lineare Kette visualisiert, aber GitHub Actions ermöglicht parallele Ausführung, bei der Abhängigkeiten mit needs ausgedrückt werden. Die acht Gatter sind:
- Fehlschneller Bau und Einheitenprüfungen
- Vorschau-Bereitstellung
- Playwright-Critical-Journey-Tests (Desktop & Mobil)
- API-Vertragsvalidierung
- Barrierefreiheits- und Leistungsbudgets (Lighthouse CI)
- Leichter Sicherheitsrauch (OWASP ZAP)
- Unveränderliche Beweisartefakte
- Explizite Genehmigung der menschlichen Freigabe
Jedes Gate erzeugt ein blockierendes Signal (muss grün sein, um fortzufahren) oder ein Beratungssignal (aufgezeichnet, aber stoppt die Pipeline nicht). Die Unterscheidung wird im Workflow kodiert, indem continue-on-error: true für Beratungsaufgaben verwendet und deren Berichte als Artefakte veröffentlicht werden.
Gate 1 – Fail‑Fast‑Build & Unit‑Checks
Was es beweist – Der Quellcode kompiliert, Linting-Durchgänge und Unit-Tests testen die Kernlogik.
Was es nicht beweisen kann – Integrationsverhalten, UI-Rendering oder Leistung unter Last.
Implementierung
name: CI
on:
  push:
    branches: [main]
  pull_request:

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Set up Node
        uses: actions/setup-node@v4
        with:
          node-version: '20'
      - name: Install dependencies
        run: npm ci
      - name: Lint
        run: npm run lint
      - name: Unit tests
        run: npm test -- --ci --reporter=dot
      - name: Upload unit report
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: unit-report
          path: coverage/
Der Auftrag scheitert bei jedem von null bestimmten Exit-Code, was ein blockierendes Ergebnis garantiert.
Wiederholungsrichtlinie – Es werden keine Wiederholungsversuche konfiguriert; ein durchgefallener Unit-Test ist ein harter Stopp. Unzuverlässige Unit-Tests sollten behoben werden, bevor sie CI erreichen.
Gate 2 – Preview‑Deployment
Eine kurzlebige Vorschauumgebung (z. B. mit GitHub Pages, Vercel-Vorschau oder einem Docker-Container auf einem selbstgehosteten Runner) validiert, dass die Build-Artefakte bereitgestellt werden können.
Was es beweist – Das Deployment-Skript funktioniert, statische Assets sind erreichbar und Umgebungsvariablen werden korrekt eingeschleust.
Was es nicht beweisen kann – Funktionale Korrektheit von UI-Flüssen.
Implementierung (vereinfacht)
  preview:
    runs-on: ubuntu-latest
    needs: build
    outputs:
      preview_url: ${{ steps.deploy.outputs.preview_url }}
    steps:
      - uses: actions/checkout@v4
      - name: Deploy preview
        id: deploy
        run: |
          PREVIEW_URL="$(./scripts/deploy-preview.sh)"
          echo "preview_url=$PREVIEW_URL" >> "$GITHUB_OUTPUT"
      - name: Wait for health endpoint
        env:
          PREVIEW_URL: ${{ steps.deploy.outputs.preview_url }}
        run: |
          for i in {1..30}; do
            curl -sf "$PREVIEW_URL/health" && exit 0
            sleep 1
          done
          exit 1
Der Preview-Job muss eine echte, extern erreichbare URL als Job-Output zurückgeben. $GITHUB_ENV gilt nur innerhalb eines Jobs, und ein Hintergrundserver auf einem von GitHub gehosteten Runner läuft nicht in einem anderen Job weiter. Nachfolgende Jobs lesen deshalb ${{ needs.preview.outputs.preview_url }}. Wenn Deployment oder der begrenzte Health-Check fehlschlägt, stoppt die Pipeline.
Gate 3 – Playwright Critical‑Journey-Tests (Desktop & Mobile)
Playwrights offizielle CI-Anleitung beschreibt, wie man Browser im headless-Modus innerhalb von GitHub Actions ausführen kann. Kritische Reisen (z. B. "Suche → Produktdetail → in den Warenkorb legen") werden sowohl auf einem Desktop-Viewport als auch auf einer mobilen Emulation ausgeführt.
Was es beweist – Der End-to-End-Funktionsablauf funktioniert in den Zielbrowsern, Selektoren sind stabil und wichtige UI-Elemente werden gerendert.
Was es nicht beweisen kann – Vollständige Cross-Browser-Abdeckung (nur die Browser, die du benutzt), Leistung unter realen Netzwerkbedingungen oder Sicherheit.
Blockierend oder beratend – Funktionale Playwright-Fehler sind blockierend. Eine fehlgeschlagene expect.soft-Assertion lässt den aktuellen Test weiterlaufen, Playwright markiert den Test am Ende jedoch als fehlgeschlagen. Soll ein visueller Vergleich nur beratend sein, muss er in einem separaten Job oder Schritt mit der expliziten Richtlinie continue-on-error: true laufen und seinen Bericht speichern.
Playwright TypeScript Beispiel
import { test, expect } from '@playwright/test';

test.describe('Critical purchase journey', () => {
  // Run on both desktop and mobile
  test.use({
    viewport: { width: 1280, height: 720 },
    userAgent: 'desktop',
  });

  test('Desktop flow', async ({ page }) => {
    await page.goto(process.env.PREVIEW_URL!);
    await page.fill('#search', 'widget');
    await page.press('#search', 'Enter');
    await page.click('text=Widget Pro');
    await page.click('button#add-to-cart');

    // Soft assertion: continue collecting evidence, but the test still fails
    await expect(page.locator('#cart-count')).toHaveText('1', { timeout: 5000 });
    await expect.soft(page).toHaveScreenshot('cart-desktop.png');
  });

  test.use({
    viewport: { width: 375, height: 667 },
    deviceScaleFactor: 2,
    isMobile: true,
    userAgent: 'mobile',
  });

  test('Mobile flow', async ({ page }) => {
    await page.goto(process.env.PREVIEW_URL!);
    await page.tap('#search');
    await page.fill('#search', 'widget');
    await page.press('#search', 'Enter');
    await page.tap('text=Widget Pro');
    await page.tap('button#add-to-cart');

    await expect(page.locator('#cart-count')).toHaveText('1');
    await expect.soft(page).toHaveScreenshot('cart-mobile.png');
  });
});
Wichtige Punkte
process.env.PREVIEW_URLwird aus dem Vorschaujob eingeschleust.expect.softsetzt den Test nach einer fehlgeschlagenen Assertion fort, aber der Test endet trotzdem als fehlgeschlagen; allein dadurch entsteht kein beratendes Release-Signal.- Screenshots werden automatisch als Artefakte hochgeladen (siehe Schritt
upload-artifactim Workflow).
Schutz vor Flaky Tests – Playwright-Wiederholungsversuche werden ausdrücklich in playwright.config.ts oder über den entsprechenden Kommandozeilenschalter konfiguriert. Standardmäßig gibt es keine Wiederholung. Dieses Beispiel setzt die Anzahl auf null, damit der erste Fehler das Gate blockiert; falls ein Wiederholungsversuch zur Beweissammlung erlaubt ist, muss er ausdrücklich konfiguriert und das Ergebnis als instabil ausgewiesen werden.
Gate 4 – API‑Contract‑Validierung
Die Verwendung eines Vertragstest-Tools (z. B. OpenAPI-Validator) stellt sicher, dass die Backend-Antworten dem veröffentlichten Schema entsprechen.
Was es beweist – Der API-Vertrag wird für die ausgeübten Endpunkte respektiert.
Was es nicht beweisen kann – Geschäftslogik-Korrektheit jenseits des Schemas oder Leistung unter Last.
Implementierung
  api-contract:
    runs-on: ubuntu-latest
    needs: preview
    steps:
      - uses: actions/checkout@v4
      - name: Install validator
        run: npm ci
      - name: Run contract tests
        env:
          BASE_URL: ${{ needs.preview.outputs.preview_url }}
        run: npm run contract:test
      - name: Upload contract report
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: contract-report
          path: contract-report/
Das Vertragstestskript sollte bei jedem Schemaverstoß mit einem nicht null Status beenden, wodurch das Gate blockiert wird.
Gate 5 – Accessibility‑ & Performance‑Budgets (Lighthouse CI)
Lighthouse CI kann mit der Vorschau-URL ausgeführt werden, um Budgetschwellenwerte für Zugänglichkeit, Leistung und Best Practices durchzusetzen. Die offizielle Lighthouse CI-Dokumentation beschreibt, wie Budgets in einer lighthouserc.json-Datei konfiguriert werden.
Was es beweist – Die Seite erfüllt definierte quantitative Schwellenwerte (z. B. Barrierefreiheitswert ≥ 90, Erst-Contentful-Paint ≤ 1,5 S).
Was es nicht beweisen kann – Subjektive Benutzerfreundlichkeitsprobleme oder reale Netzwerkvariabilität jenseits der simulierten Bedingungen.
Implementierung
  lighthouse:
    runs-on: ubuntu-latest
    needs: preview
    steps:
      - uses: actions/checkout@v4
      - name: Install Lighthouse CI
        run: npm ci && npm install -g @lhci/cli@0
      - name: Run LHCI
        env:
          LHCI_BUILD_CONTEXT__CURRENT_BRANCH: ${{ github.ref_name }}
          LHCI_BUILD_CONTEXT__GITHUB_PULL_REQUEST: ${{ github.event.pull_request.number }}
        run: |
          lhci collect --url=${{ needs.preview.outputs.preview_url }} --numberOfRuns=3
          lhci assert --config=./lighthouserc.json
      - name: Upload LHCI report
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: lighthouse-report
          path: .lhci/
Der lhci assert Schritt scheitert an der Arbeit, wenn ein Budget überschritten wird, wodurch das Gate blockiert wird. Advisory-Ergebnisse (z. B. eine Leistungswarnung, die noch über dem Budget liegt) können erfasst werden, indem man den assert Schritt weglässt und nur den Bericht hochlädt.
Gate 6 – Lightweight Security Smoke (OWASP ZAP)
Ein schneller Scan mit dem Baseline-Scan von OWASP ZAP ermöglicht eine frühzeitige Erkennung häufiger Schwachstellen (z. B. fehlender Sicherheitsheader).
Was es beweist – Die bereitgestellte Vorschau enthält keine offensichtlichen Sicherheitsfehler.
Was es nicht beweisen kann – Umfassende Penetrationstests oder Zero-Day-Exploits.
Implementierung
  zap:
    runs-on: ubuntu-latest
    needs: preview
    steps:
      - uses: actions/checkout@v4
      - name: Baseline scan
        env:
          ZAP_TARGET: ${{ needs.preview.outputs.preview_url }}
        run: |
          docker run --rm -v "$PWD:/zap/wrk:rw" -t ghcr.io/zaproxy/zaproxy:stable \
            zap-baseline.py -t "$ZAP_TARGET" -c /zap/wrk/zap-rules.conf \
            -r zap-report.html -I
      - name: Upload ZAP report
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: zap-report
          path: zap-report.html
Mit dem Schalter -I führen WARN-Funde nicht zum Fehlschlag des Jobs. In zap-rules.conf als FAIL markierte Regeln erzeugen Exit-Code 1 und blockieren das Gate; Exit-Code 3 signalisiert einen anderen Betriebsfehler. Damit ist die Richtlinie explizit, statt jede Warnung als Release-Blocker zu behandeln.
Gate 7 – Immutable Evidence Artifacts
Alle vorangegangenen Gates laden ihre Artefakte hoch (Einheitenabdeckung, Playwright-Screenshots, Vertragsberichte, Lighthouse JSON, ZAP HTML). Die Artefakte werden im Artefaktspeicher von GitHub gespeichert, der während des gesamten Workflow-Laufs unveränderlich ist.
Warum es wichtig ist – Prüfer, Veröffentlichungsmanager oder zukünftige Forscher können die genauen Beweise finden, die die Veröffentlichungsentscheidung rechtfertigten. Die Artefakte dienen auch als Grundlage für die Regressionsanalyse.
  archive-evidence:
    runs-on: ubuntu-latest
    needs: [build, preview, playwright, api-contract, lighthouse, zap]
    if: always()
    steps:
      - name: Gather all artefacts
        run: echo "All artefacts already uploaded by individual jobs."
Der archive-evidence Auftrag erzeugt keine neuen Artefakte, sondern stellt sicher, dass die Pipeline erst versagt, nachdem alle Beweise sicher gelagert sind.
Gate 8 – Explicit Human Release Approval
Das letzte Gate ist ein manueller Genehmigungsschritt, der eine Zusammenfassung der gesammelten Beweise präsentiert. Die Entscheidung, die Vorschau zur Produktion zu bewerben, liegt bei einem designierten Release Manager oder Product Owner.
Implementierung
  approve:
    runs-on: ubuntu-latest
    needs: archive-evidence
    environment:
      name: production
      url: ${{ needs.preview.outputs.preview_url }}
    steps:
      - name: Request approval
        uses: peter-evans/repository-dispatch@v2
        with:
          token: ${{ secrets.GITHUB_TOKEN }}
          event-type: release-approval
          client-payload: |
            {
              "preview_url": "${{ needs.preview.outputs.preview_url }}",
              "artifacts": [
                "unit-report",
                "playwright-screenshots",
                "contract-report",
                "lighthouse-report",
                "zap-report"
              ]
            }
Die environment Schutzregeln in GitHub können so konfiguriert werden, dass ein Reviewer erforderlich ist. Der Reviewer inspiziert die Artefakte über die GitHub-Benutzeroberfläche, bestätigt, dass alle blockierenden Gates bestanden sind, und klickt dann auf "Approve and Deploy". Die Pipeline führt dann zum Produktions-Deployment-Job (nicht angezeigt).
Umgang mit unzuverlässigen Tests und begrenzten Wiederholungen
- Keine impliziten Wiederholungen – GitHub Actions wiederholt fehlgeschlagene Schritte nicht automatisch, und Playwright verwendet standardmäßig null Wiederholungsversuche. Die Anzahl wird in der Playwright-Konfiguration oder über den entsprechenden Kommandozeilenschalter festgelegt; ein beliebiges Matrixfeld ändert den Test-Runner nicht.
- Beratende Ergebnisse trennen –
expect.softlässt nach einem Fehler weitere Prüfungen zu, markiert den Test aber weiterhin als fehlgeschlagen. Beratende visuelle Ergebnisse gehören in einen ausdrücklich nicht blockierenden Job oder Schritt, dessen Artefakte für die Triage erhalten bleiben. - Timeouts und Wiederholungen auf Testniveau – Playwrights
test.setTimeoutund pro-Schritt-Wiederholungen können sparsam verwendet werden; jede Anzahl von Wiederholungen über einer sollte zur Untersuchung markiert werden.
Beweise zugänglich halten
- Artefaktbenennung – Verwenden Sie klare, versionierte Namen (z. B.
playwright-screenshots-${{ github.sha }}). - Aufbewahrungsrichtlinie – GitHub speichert Artefakte standardmäßig für 90 Tage; passen Sie die
retention-daysdes Workflows an, wenn längere Audittrails erforderlich sind. - Verlinkung aus der Genehmigungs-UI – Der manuelle Genehmigungsschritt kann eine Markdown-Zusammenfassung anzeigen, die direkt auf jedes Artefakt verlinkt ist, sodass die Prüfer mit einem Klick die Beweise ansehen können.
KI‑generierte Zusammenfassungen als Veröffentlichungsentscheidungen vermeiden
Die Automatisierung kann eine prägnante Markdown-Zusammenfassung des Durchlaufs generieren (z. B. mit actions/github-script). Obwohl praktisch, sollte diese Zusammenfassung niemals das manuelle Genehmigungsgitter ersetzen. Um zu verhindern, dass ein KI-generiertes Abzeichen zum de-facto-Entscheidungspunkt wird:
- Erfordern Sie eine geschützte Umgebung mit mindestens einem menschlichen Prüfer.
- Sperre die Produktionsbereitstellung nicht bei einer Statusprüfung, die von einem Bot überschrieben werden kann.
- Speichere die KI-Zusammenfassung als Artefakt nur zur Referenz.
Indem das menschliche Tor von einem automatisierten Ausweis getrennt bleibt, bewahrt das Team die Verantwortlichkeit und vermeidet die Illusion von "Vollautomatisierung".
Wo Automatisierung hilft
| Gebiet | Automatisierungsstärke | Verbleibendes menschliches Urteil |
|---|---|---|
| Bau- und Unit-Tests | Schnell, deterministisch, wiederholbar. | Entscheidung über die Angemessenheit der Testdeckung. |
| Vorschau der Bereitstellung | Garantiert, dass die Build-Artefakte bedient werden können. | Bewertung der umgebungsspezifischen Konfiguration. |
| Playwright Kritische Reisen | Erkennt Regressionen in den Kern-Nutzerströmen über Browser hinweg. | Bewertung der UI/UX-Qualität über die funktionale Korrektheit hinaus. |
| API-Vertragsprüfungen | Setzt automatisch die Einhaltung des Schemas durch. | Feststellung, ob Vertragsänderungen akzeptabel sind. |
| Lighthouse-Budgets | Quantifiziert Leistungs- und Zugänglichkeitsgrenzen. | Abwägungen zu interpretieren, wenn ein Budget nur geringfügig verpasst wird. |
| Sicherheitsrauch-Scan | Erkennt offensichtliche Fehlkonfigurationen früh. | Durchführung tiefgehender Sicherheitsbewertungen. |
| Beweisarchiv | Unveränderliche Speicherung von Protokollen, Screenshots, Berichten. | Prüfung und Obduktion. |
| Menschliche Zustimmung | Bietet einen einzigen, prüfbaren Entscheidungspunkt. | Wir wägen die Auswirkungen des Unternehmens, den Veröffentlichungszeitpunkt und die Risikotoleranz ab. |
Automatisierung ist hervorragend darin, Abweichungen von definierten Erwartungen zu erkennen; Menschen sind hervorragend darin, die Bedeutung dieser Abweichungen zu interpretieren.
Überprüfungsfragen
- Was unterscheidet ein Blocking Gate von einem Advisory Fund, und wie wird dies in einem GitHub Actions-Workflow ausgedrückt?
- Warum führt
expect.softtrotzdem zu einem fehlgeschlagenen Test, und wie wird eine beratende visuelle Prüfung vom blockierenden Playwright-Gate getrennt? - Welche Artefakte werden nach dem Lighthouse CI-Job hochgeladen und welche Budgetbedingung führt zum Scheitern des Auftrags?
- Wie trägt der OWASP ZAP-Baseline-Scan zum Sicherheitsgate bei, und welcher Ausgangsstatus weist auf einen Blockierungsfehler hin?
- Welche Schutzmaßnahmen verhindern, dass eine KI-generierte Zusammenfassung zur alleinigen Veröffentlichungsentscheidung wird?
Fazit
Der Ersatz der marketing‑artigen Behauptung „100 % QA‑tested“ durch eine evidence‑based Release‑Gate‑Pipeline zwingt jedes Team, zu erläutern, was geprüft wird, wie Fehler behandelt werden und wo menschliches Urteil weiterhin nötig ist. Durch das Verketten von Fail‑Fast‑Builds, Preview‑Deployments, Playwright‑Critical‑Journey‑Tests, API‑Contract‑Validierung, Lighthouse‑Budgets, einem leichten ZAP‑Scan, unveränderlichen Artefakten und einer abschließenden manuellen Freigabe liefert die Pipeline konkrete, auditierbare Beweise dafür, dass das Release die definierten Risikokriterien erfüllt. Der Ansatz ist transparent, wiederholbar und anpassbar an jede Web‑Anwendung – er bietet Vertrauen, das messbar ist, nicht nur beworben.
Quellen
- Playwright CI documentation – https://playwright.dev/docs/ci
- GitHub Actions documentation – https://docs.github.com/en/actions
- Lighthouse CI documentation – https://github.com/GoogleChrome/lighthouse-ci
- OWASP ZAP documentation – https://www.zaproxy.org/docs/
Kommentar hinterlassen
Teilen Sie Ihre Gedanken zum Artikel. Kein Konto erforderlich.
Kommentare
Kommentare werden geladen…