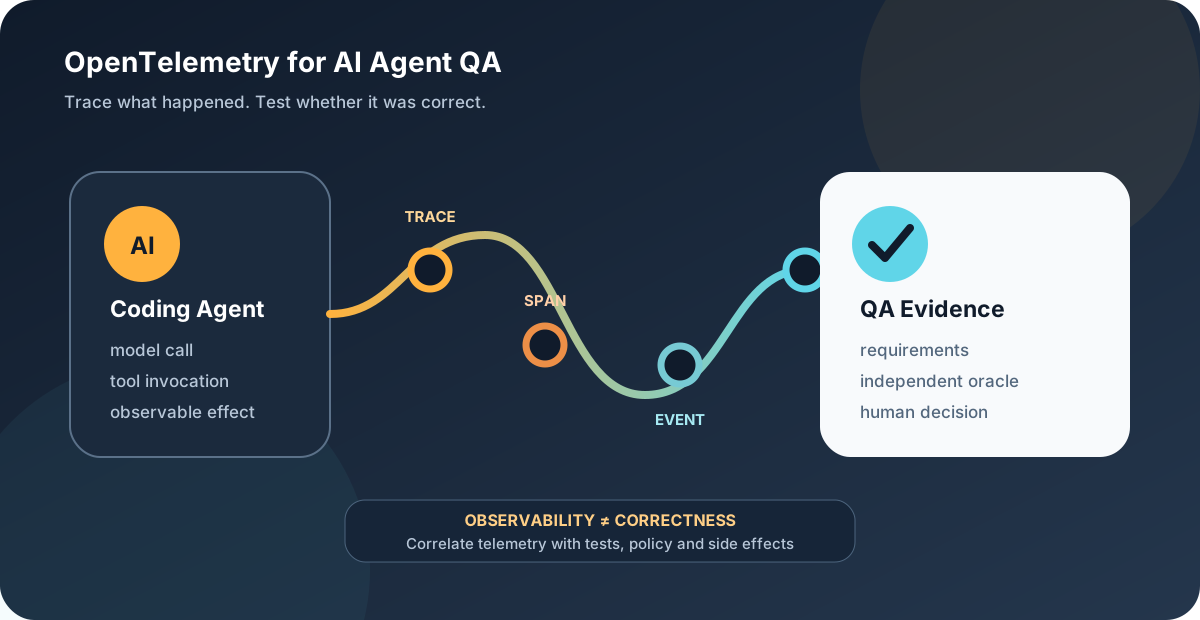
OpenTelemetry macht die Arbeit eines Coding-Agenten beobachtbar. Für Qualitätssicherung ist das wertvoll, weil ein Trace zeigt, welche Modell- und Werkzeugaufrufe während einer Sitzung stattgefunden haben. Ein Trace beweist jedoch nicht, dass der erzeugte Code fachlich richtig, sicher oder vollständig ist. Er ist ein zusätzlicher Nachweis, der mit Anforderungen, Testergebnissen und beobachtbaren Nebeneffekten verbunden werden muss.
GitHub unterstützt OpenTelemetry für die GitHub-Copilot-App über zentral verwaltete Unternehmenseinstellungen. Laut GitHub-Dokumentation können Traces Modell- und Werkzeugaufrufe abbilden; Metriken können unter anderem Tokenzahlen liefern und Ereignisse können Feedback zu Bearbeitungen beschreiben. Inhalte von Prompts, Antworten und Werkzeugargumenten werden standardmäßig nicht erfasst. Diese Grenze ist für eine datenschutzbewusste QA-Strategie entscheidend.
1. Was OpenTelemetry im Agentenkontext liefert
OpenTelemetry unterscheidet mehrere Signale. Ein Trace beschreibt den Weg einer Anfrage durch eine Sitzung. Ein Span repräsentiert eine zeitlich begrenzte Operation innerhalb dieses Weges. Attribute ergänzen einen Span um strukturierte Angaben, Ereignisse markieren relevante Zeitpunkte und der Status kann einen Fehler anzeigen. Metriken fassen numerische Entwicklungen zusammen.
| Signal | Bedeutung für eine Agentensitzung | Nutzen für QA |
|---|---|---|
| Trace | Zusammenhängender Ablauf einer Benutzeranfrage | Verbindet alle Beobachtungen mit einem Testlauf |
| Span | Einzelne Operation, etwa Modell- oder Werkzeugaufruf | Prüft Reihenfolge, Dauer und Auftreten eines Schritts |
| Attribut | Strukturierter Kontext eines Spans | Ermöglicht Regeln für Modell, Werkzeug oder Sitzung |
| Ereignis | Zeitmarkierte Zusatzinformation | Liefert Kontext zu Fehlern oder Bearbeitungsfeedback |
| Metrik | Aggregierter Zahlenwert | Zeigt Trends bei Nutzung, Fehlern oder Laufzeit |
Die konkreten Namen von Spans und Attributen hängen von der eingesetzten Instrumentierung und vom Backend ab. Ein Team darf deshalb Beispielnamen nicht ungeprüft als GitHub-Vertrag behandeln. Vor automatisierten Assertions muss es das tatsächlich exportierte Schema dokumentieren und versionieren.
2. Beobachtbarkeit ist kein Korrektheitsbeweis
Ein grüner Trace kann trotzdem zu falschem Code führen. Ein Agent kann das zugelassene Modell und alle vorgesehenen Werkzeuge verwenden und dennoch eine Anforderung missverstehen. Umgekehrt kann ein fehlender Span auf Sampling, Exportfehler oder eine geänderte Instrumentierung zurückgehen, ohne dass die Produktfunktion fehlerhaft ist.
Für eine belastbare Bewertung werden drei Ebenen kombiniert:
- Produktnachweis: Unit-, Integrations-, Vertrags-, Sicherheits- und explorative Tests bewerten das Ergebnis.
- Prozessnachweis: Telemetrie zeigt, welche Schritte, Werkzeuge und Entscheidungen beobachtet wurden.
- Governance-Nachweis: Richtlinien, Berechtigungen, Aufbewahrung und menschliche Freigaben zeigen, wer über Risiken entscheidet.
Die Telemetrie ist damit ein unabhängiger Beobachtungskanal, aber kein Ersatz für ein Testorakel.
3. Von Anforderungen zu Telemetrieprüfungen
Jede Prüfung beginnt mit einer klaren Anforderung. Danach wird festgelegt, welches beobachtbare Signal diese Anforderung unterstützt und welcher zusätzliche Nachweis benötigt wird.
| Anforderung | Telemetrischer Nachweis | Zusätzliches Testorakel | Entscheidung |
|---|---|---|---|
| Nur freigegebene Werkzeuge dürfen laufen | Werkzeugaufrufe im Trace | Berechtigungsmatrix und negativer Test | Abweichung blockiert den Lauf |
| Dateischreibvorgänge müssen nachvollziehbar sein | Span oder Ereignis zum Schreibvorgang | Dateisystem-Diff und erwarteter Pfad | Unerwartete Datei ist ein Defekt |
| Sicherheitsfehler müssen den Ablauf stoppen | Fehlerstatus und zugehöriges Ereignis | Security-Test und unveränderte Daten | Fortsetzung nach Fehler ist kritisch |
| Modellnutzung muss zur Richtlinie passen | Modellinformation, falls exportiert | Unternehmenskonfiguration | Unbekanntes Modell wird untersucht |
| Ergebnis muss die Anforderung erfüllen | Trace der Sitzung | Fachliche Assertions und Review | Trace allein reicht nicht |
Feldnamen wie model.id, tool.name oder file.path sind in dieser Matrix nur Beispiele. Das reale Collector-Schema ist die verbindliche Quelle.
4. Praktische Assertions
Eine QA-Suite kann exportierte Daten lesen, ohne den Agenten zu verändern. Sinnvolle Assertions sind beispielsweise:
- Für eine Sitzung existiert genau ein erwarteter Start- und Abschlusskontext.
- Jeder beobachtete Werkzeugaufruf gehört zur aktuellen Freigabeliste.
- Ein verweigerter Zugriff erzeugt einen erkennbaren Fehlerpfad.
- Eine Dateiänderung im Repository lässt sich mit einem beobachteten Schreibschritt und dem tatsächlichen Diff korrelieren.
- Nach einem kritischen Scannerfehler folgen keine schreibenden Aktionen.
- Ein Trace enthält keine unerwarteten Inhaltsfelder, solange Content Capture deaktiviert ist.
Assertions sollten tolerant gegenüber nicht wesentlichen Änderungen sein. Eine Prüfung, die auf der exakten Reihenfolge aller internen Spans besteht, wird schnell instabil. Stabiler sind Regeln zu Sicherheitsgrenzen, verpflichtenden Schritten und sichtbaren Nebeneffekten.
5. Negative und sicherheitsorientierte Szenarien
Positive Abläufe reichen für Agentensysteme nicht aus. Besonders nützlich sind kontrollierte Fehlerfälle:
- Das Werkzeug ist nicht autorisiert. Erwartet werden Ablehnung, kein Nebeneffekt und ein prüfbarer Fehlerpfad.
- Ein Werkzeug antwortet zu spät. Erwartet werden Timeout-Behandlung, begrenzte Wiederholungsversuche und keine Endlosschleife.
- Ein Secret-Scanner meldet einen Treffer. Erwartet werden Abbruch oder sichere Eskalation und kein Commit des Secrets.
- Der Collector ist nicht verfügbar. Die Produktfunktion muss entsprechend der Architektur sicher reagieren; ein Telemetrieausfall darf nicht unbemerkt als erfolgreicher Test gelten.
- Ein Export enthält unerwartet Prompt- oder Codeinhalt. Der Lauf wird als Datenschutz- oder Konfigurationsproblem behandelt.
- Ein Trace ist unvollständig. Das Ergebnis erhält den Status „Nachweis unzureichend“ statt automatisch „bestanden“.
Damit trennt das Team Produktfehler, Instrumentierungsfehler und Richtlinienverstöße.
6. Datenschutzbewusste Voreinstellungen
GitHub erklärt, dass Prompttexte, Modellantworten und Werkzeugargumente standardmäßig ausgeschlossen sind. Optionales Content Capture kann hingegen Code, Dateiinhalte oder Prompts sichtbar machen. Deshalb sollte es in Produktionsumgebungen grundsätzlich deaktiviert bleiben, sofern kein dokumentierter Zweck, keine angemessene Rechtsgrundlage und keine wirksamen Schutzmaßnahmen bestehen.
Für Testumgebungen sind mindestens folgende Kontrollen sinnvoll:
- minimale Datenerfassung und kurze, begründete Aufbewahrung;
- rollenbasierter Zugriff auf Collector und Backend;
- Verschlüsselung während Übertragung und Speicherung;
- Protokollierung administrativer Zugriffe;
- Redaction für Secrets, personenbezogene Daten und Quellcode;
- getrennte Konfigurationen für Produktion und kontrollierte Testläufe;
- regelmäßige Prüfung, ob neue Attribute sensible Inhalte enthalten.
Ein erfolgreicher Export ist kein Grund, möglichst viele Daten zu sammeln. QA benötigt relevante Evidenz, nicht vollständige Gesprächsinhalte.
7. Sampling, Aufbewahrung und Lücken
Sampling senkt Kosten und Datenvolumen, kann aber seltene Fehler verbergen. Für sicherheitskritische oder neu eingeführte Abläufe ist eine höhere Erfassungsrate sinnvoll. Für häufige, risikoarme Sitzungen kann ein geringerer Wert genügen. Die Entscheidung sollte auf Risiko und Datenvolumen beruhen, nicht auf einer universellen Prozentzahl.
Tail-based Sampling kann fehlgeschlagene oder langsame Traces bevorzugt behalten. Dennoch muss QA dokumentieren, welche Daten möglicherweise fehlen. Aufbewahrungsfristen sollten lang genug für Fehleranalyse und Trendvergleich, aber so kurz wie möglich für Datenschutz und Kostenkontrolle sein.
Wichtige Qualitätsindikatoren können sein:
- Anteil vollständiger Traces für definierte Testläufe;
- Rate fehlgeschlagener Werkzeugaufrufe;
- Latenz wichtiger Schritte;
- Häufigkeit verweigerter Aktionen;
- Anteil von Läufen ohne korrelierbaren Produktnachweis;
- Zahl der Datenschutz- oder Schemaprobleme.
Zielwerte entstehen aus einer Baseline des eigenen Systems. Erfundenen allgemeinen Grenzwerten sollte das Team nicht vertrauen.
8. Risikobasierter Triage-Ablauf
- Korrelieren: Testlauf, Commit, Sitzung und Trace erhalten eine gemeinsame Referenz.
- Validieren: Das Team prüft Vollständigkeit, Zeitfenster und Schema der Telemetrie.
- Bewerten: Automatische Regeln vergleichen Werkzeugnutzung, Fehlerpfade und Nebeneffekte mit der Anforderung.
- Anreichern: Diff, CI-Ergebnisse, Sicherheitsberichte und fachliche Assertions werden ergänzt.
- Klassifizieren: Das Ergebnis wird als Produktdefekt, Instrumentierungsfehler, Richtlinienverstoß oder unzureichender Nachweis eingeordnet.
- Entscheiden: Ein verantwortlicher Mensch entscheidet über Freigabe, Blockierung oder weitere Analyse.
- Dokumentieren: Verwendete Nachweise, Versionen und Begründung werden für spätere Audits festgehalten.
Dieser Ablauf verhindert, dass ein einzelnes Dashboard automatisch zur Freigabeinstanz wird.
9. Fragen für das Review
Vor einer Freigabe sollte ein Tester mindestens klären:
- Welche Anforderung soll der Trace unterstützen?
- Welches reale Schema und welche Instrumentierungsversion wurden verwendet?
- Sind alle erwarteten Werkzeugaufrufe und kritischen Nebeneffekte korrelierbar?
- Können Sampling, Exportfehler oder fehlende Rechte den Nachweis verfälschen?
- Sind Content Capture, Zugriff und Aufbewahrung datenschutzgerecht konfiguriert?
- Welches unabhängige Produktorakel bestätigt das tatsächliche Ergebnis?
- Welche Entscheidung bleibt ausdrücklich bei einer verantwortlichen Person?
10. Fazit
OpenTelemetry erweitert den Werkzeugkasten für das Testen von KI-Coding-Agenten. Traces helfen, Modell- und Werkzeugnutzung, Fehlerpfade und Laufzeiten zu untersuchen. Metriken und Ereignisse unterstützen Trendanalyse und Triage. Der Nutzen entsteht aber erst, wenn diese Signale mit Anforderungen, tatsächlichen Nebeneffekten und unabhängigen Tests verbunden werden.
Eine robuste Strategie hält Content Capture standardmäßig aus, schützt Zugriff und Aufbewahrung, behandelt Sampling-Lücken offen und versioniert das verwendete Schema. Automatisierung kann Abweichungen erkennen und Belege sammeln. Die Freigabe eines risikoreichen Agentenablaufs bleibt eine menschliche Entscheidung.
Quellen
- GitHub Changelog – OpenTelemetry in the GitHub Copilot app – https://github.blog/changelog/2026-09-22-opentelemetry-in-the-github-copilot-app/
- GitHub Docs – OpenTelemetry for Copilot – https://docs.github.com/en/copilot/concepts/enterprise/opentelemetry
- OpenTelemetry – Observability Primer – https://opentelemetry.io/docs/concepts/observability-primer/
- OpenTelemetry – Tracing API – https://opentelemetry.io/docs/specs/otel/trace/api/
Kommentar hinterlassen
Teilen Sie Ihre Gedanken zum Artikel. Kein Konto erforderlich.
Kommentare
Kommentare werden geladen…