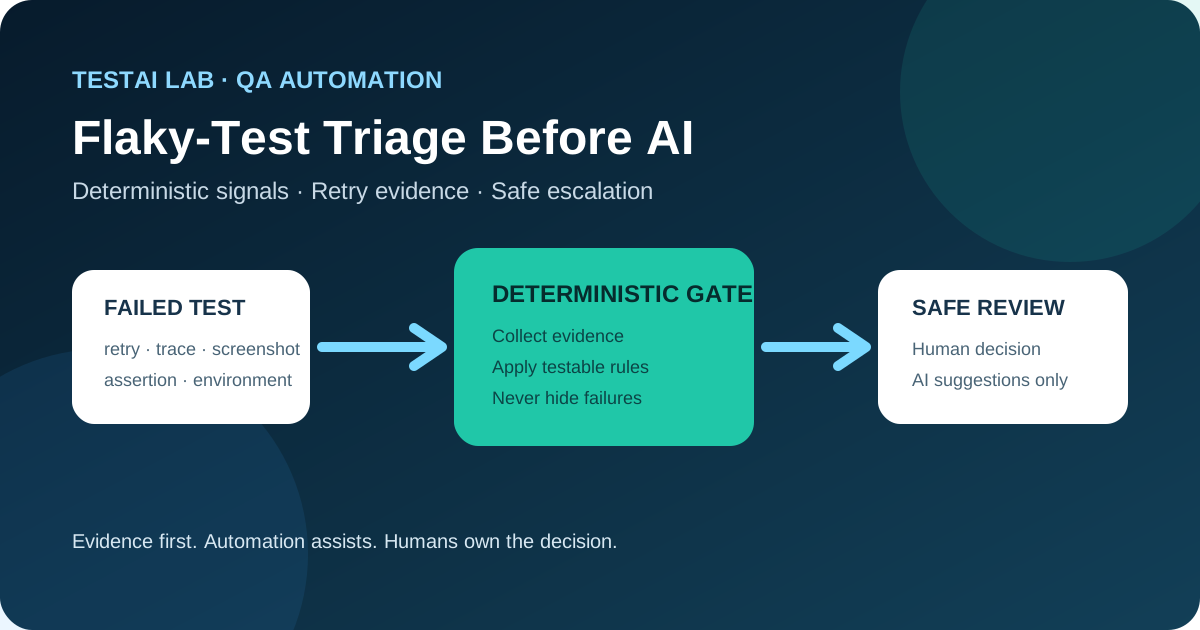
Wie man rohe Playwright CI-Daten in eine zuverlässige First-Pass-Klassifikation verwandelt, bevor ein KI-Assistent eingeschaltet wird.
1. Warum eine deterministische Triageschicht wichtig ist
Unzuverlässige Tests verschwenden Entwicklerzeit, verbergen echte Regressionen und untergraben das Vertrauen in die CI-Pipeline. Die Versuchung besteht darin, jeden mehrdeutigen Fehler an ein KI-Modell zu überlassen, das Änderungen am Locator vorschlägt oder den Test automatisch deaktiviert. Obwohl KI ein nützlicher Assistent sein kann, darf sie niemals einen disziplinierten Schritt zur Beweiserhebung ersetzen. Eine deterministische Triageschicht garantiert, dass die Entscheidung, einen Menschen – oder eine KI einzubeziehen – auf konkreten, reproduzierbaren Signalen und nicht auf Spekulationen beruht.
Playwrights eingebaute Wiederholungsunterstützung, Trace-Viewer, Screenshots und Artefaktveröffentlichung (wie in der offiziellen Dokumentation beschrieben) liefern uns genau die Daten, die für diesen ersten Durchgang benötigt werden. Indem wir die Anzahl der Wiederversuche, das Ergebnis jedes Versuchs, die Art der fehlgeschlagenen Behauptung und die Umweltmetadaten extrahieren, können wir Hochkonfidenz-Infrastruktur- oder Produktfehler von weiterhin mehrdeutigen Fällen trennen.
2. Ein konkretes CI-Szenario
Betrachten wir einen GitHub Actions-Workflow, der Playwright-Tests auf einer Matrix von Browsern ausführt. Der Workflow veröffentlicht für jeden Durchlauf folgende Artefakte:
- Trace-Dateien (
.zip) – enthalten Schritt-für-Schritt-Netzwerk-, DOM- und Screenshotdaten. - Screenshots – bei Fehlschlag aufgenommen.
- Video – optional, aber nützlich für die visuelle Verifikation.
- Testmetadaten – über
testInfobereitgestellt (Wiederversuchsnummer, Arbeiterindex, Projektname usw.).
Wenn ein Test fehlschlägt, lädt der Workflow diese Artefakte automatisch als Teil der Run-Zusammenfassung hoch und macht sie sofort für eine nachgelagerte Analyse verfügbar.
3. Schritt-für-Schritt-deterministische Triage
| Schritt | Was wir einfangen | Warum es wichtig ist |
|---|---|---|
| 1. Fehler erkennen | Der Playwright kennzeichnet den Test im JSON-Bericht als durchgefallen. | Einstiegspunkt für Triage-Logik. |
| 2. Rekordversuchszahl | testInfo.retry (0 beim ersten Versuch, 1 beim ersten Versuch, ...). | Bestimmt, ob das Scheitern ein Erstversuch-Problem oder eine wiederholbare-Anomalie ist. |
| 3. Eroberungsergebnis des Wiederholungsversuchs | Erfolg oder Misserfolg des folgenden Versuchs. | Ein erneuter Versuch, der besteht, garantiert nicht, dass der ursprüngliche Fehler harmlos war; er zeigt nur, dass der Test unter leicht unterschiedlichen Zeit- oder Ressourcenbedingungen erfolgreich sein kann. |
| 4. Behauptung klassifizieren | Identifizieren Sie den Ausnahmetyp (AssertionError, TimeoutError, netzwerkbezogener Fehler usw.). | Bestimmte Kategorien (z. B. Netzwerk-Timeouts) sind eher infrastrukturbezogen, während andere (z. B. nicht übereinstimmender UI-Text) auf eine Produktänderung hinweisen können. |
| 5. Trace und Screenshot anhängen | Benutze testInfo.attachments, um die Trace-Datei und den Screenshot des Fehlers zu speichern. | Liefert deterministische visuelle Beweise, die inspiziert werden können, ohne den Test erneut durchzuführen. |
| 6. Metadaten der Umgebung aufzeichnen | Betriebssystem, Browserversion, CI-Runner-ID, Commit SHA und alle Feature-Flags. | Hilft, Muster wie "Fehlschläge nur unter Windows Chrome 115" zu erkennen. |
| 7. Wende deterministische Regeln an | Eine kleine, unit-testbare Funktion bewertet die gesammelten Daten und gibt eines von drei Labels zurück: Infrastruktur, Produkt, Mehrdeutig. | Der Regelsatz ist transparent, versionskontrolliert und kann vom Team überprüft werden. |
| 8. Routen Sie das Ergebnis | Infrastruktur → automatisch ein Ticket für das Infra-Team erstellen. <br>Produkt → automatisch ein Fehlerticket mit angeschlossener Spur erstellen. <br>Mehrdeutig → Flagge für menschliche Überprüfung oder optionale KI-Unterstützung. | Garantiert, dass nur hochkonfidenziell Fälle automatisch bearbeitet werden. |
Der Ablauf endet bei Schritt 7 für Infrastruktur- und Produkt-Klassifikationen. Nur wenn der Regelsatz keine sichere Entscheidung treffen kann, beziehen wir einen Menschen oder einen KI-Assistenten ein.
4. TypeScript-Beispiel – deterministische Beweise anhängen
import { test, expect, TestInfo } from '@playwright/test';

// Helper that builds a structured evidence object
function buildEvidence(info: TestInfo, error: Error) {
  const evidence = {
    retry: info.retry,                     // attempt number
    outcome: info.status,                  // "failed" or "passed"
    assertion: error.name,                 // e.g., "AssertionError"
    message: error.message,
    tracePath: info.attachments.find(a => a.name === 'trace')?.path,
    screenshotPath: info.attachments.find(a => a.name === 'screenshot')?.path,
    env: {
      os: process.platform,
      browser: info.project.name,
      commit: process.env.GITHUB_SHA,
      runId: process.env.GITHUB_RUN_ID,
    },
  };
  // Persist as JSON artifact for later rule evaluation
  info.attach('triage-evidence', {
    body: JSON.stringify(evidence, null, 2),
    contentType: 'application/json',
  });
}

// Example test that records evidence on failure
test('checkout flow shows correct total', async ({ page }, testInfo) => {
  try {
    await page.goto('https://example.com/checkout');
    await expect(page.locator('#total')).toHaveText('$42.00');
  } catch (err) {
    // Capture trace and screenshot before rethrowing
    await testInfo.attach('trace', { path: testInfo.outputPath('trace.zip'), contentType: 'application/zip' });
    await testInfo.attach('screenshot', { path: testInfo.outputPath('failure.png'), contentType: 'image/png' });
    buildEvidence(testInfo, err as Error);
    throw err; // Let Playwright mark the test as failed
  }
});
Wichtige Punkte
testInfo.retryist das deterministische Signal, das uns sagt, ob der Fehler beim ersten Versuch passiert ist.- Der
triage-evidenceAnhang ist eine JSON-Datei, die nachgelagerte Skripte parsen können, ohne den Test erneut auszuführen. - Alle Artefakte werden automatisch von GitHub Actions hochgeladen, sobald der Auftrag abgeschlossen ist, wodurch sie der Regel-Engine zur Verfügung stehen.
5. Deterministische Klassifikationsregeln (unit-testbar)
type Evidence = {
  retry: number;
  outcome: 'failed' | 'passed';
  assertion: string;
  env: { os: string; browser: string };
};

export function classify(e: Evidence): 'Infrastructure' | 'Product' | 'Ambiguous' {
  // Rule 1 – Infrastructure timeout on first attempt
  if (e.retry === 0 && e.assertion === 'TimeoutError') {
    return 'Infrastructure';
  }

  // Rule 2 – Assertion error that passes on retry → ambiguous
  if (e.retry > 0 && e.assertion === 'AssertionError' && e.outcome === 'passed') {
    return 'Ambiguous';
  }

  // Rule 3 – Consistent assertion error across all attempts → product defect
  if (e.retry === 0 && e.assertion === 'AssertionError') {
    return 'Product';
  }

  // Rule 4 – Known flaky pattern (e.g., Chrome on Linux) – treat as infrastructure
  if (e.env.browser.includes('chrome') && e.env.os === 'linux' && e.assertion === 'NetworkError') {
    return 'Infrastructure';
  }

  // Default – we cannot decide with confidence
  return 'Ambiguous';
}
Jede Regel ist bewusst einfach, was es erleichtert, Unit-Tests zu schreiben, die das erwartete Label für eine gegebene Beweisnutzlast überprüfen. Der Regelsatz kann sich weiterentwickeln, wenn das Team neue Muster entdeckt, aber jede Änderung muss überprüft und versionskontrolliert werden.
6. Warum ein "Retry-Passed"-Ergebnis kein Beweis für harmlose Flakiness ist
Playwrights Wiederholungsmechanismus führt den gesamten Test (oder den Fehlschritt, je nach Konfiguration) erneut durch. Ein bestandener Versuch zeigt, dass der Test unter einem leicht anderen Zeitpunkt oder Ressourcensnapshot bestehen kann, erklärt aber nicht warum der erste Versuch fehlschlug. Häufige versteckte Ursachen sind:
- Transiente Netzwerklatenz, die die Standardzeitgrenze beim ersten Versuch überschreitet, aber nicht beim erneuten Versuch.
- Rennbedingungen in der Anwendung, die sich nur manifestieren, wenn sich der DOM in einem bestimmten Zustand befindet.
- Ressourcenkonkurrenz beim CI-Runner (z. B. CPU-Drosselung), die nach einer kurzen Pause verschwindet.
Wenn wir solche Fälle automatisch als "harmlos" bezeichnen, riskieren wir, eine Regression zu übersehen, die nur unter einem bestimmten Belastungsmuster auftritt. Die deterministischen Beweise (Spur, Screenshot, Wiederholungsanzahl) ermöglichen es einem Menschen zu überprüfen, ob der Erfolg des erneuten Versuchs wirklich harmlos ist oder ob er ein tieferliegendes Problem verbirgt.
7. Warum ein AssertionError nicht automatisch ein Produktfehler ist
Ein AssertionError zeigt uns einfach, dass eine Erwartung im Test nicht mit dem beobachteten Wert übereinstimmte. Die Fehlanpassung kann sich daraus ergeben:
- Locator-Drift – der Selektor zeigt nach einem UI-Redesign auf ein anderes Element.
- Timing-Varianz – Der Text des Elements wird einige Millisekunden später aktualisiert, als die Behauptung ausgeführt wird.
- Umweltunterschiede – Schriftarten, Ort oder DPI-Einstellungen, die den gerenderten Text beeinflussen.
Nur wenn die Belege eine konsistente Diskrepanz über alle Versuche und Umgebungen hinweg zeigen, sollten wir es als Produktfehler behandeln. Andernfalls gehört der Fehler zum Infrastruktur- oder Fehlertest-Bucket, und die angemessene Antwort ist eine Anpassung der Wiederholungsrichtlinien oder eine Verbesserung der Teststabilität, nicht ein Fehlerticket.
8. Sichere Eskalation zu KI – was ein Assistent tun darf (und was nicht)
Wenn der deterministische Klassifikator Mehrdeutig zurückkehrt, kann ein Team einen KI-Assistenten für Vorschläge einbeziehen. Der Umfang dieser Unterstützung muss eng begrenzt sein:
| Erlaubte KI-Aktionen | Verbotene KI-Aktionen |
|---|---|
| Schlage einen neuen Locator basierend auf dem Trace-Screenshot vor. | Ändere die Testdatei direkt ohne menschliche Genehmigung. |
| Fassen Sie die Spuren zusammen, die zum Scheitern geführt haben. | Unterdrücken Sie den unzuverlässigen Test oder markieren Sie ihn als "Überspringen". |
| Markiere fehlende Netzwerkanfragen, die eine Auszeit erklären könnten. | Erstellen Sie eine Fehlerbeschreibung, die automatisch ohne Überprüfung eingereicht wird. |
Die Begründung ist einfach: Ein KI-Modell verfügt nicht über das kontextuelle Wissen über Produktabsicht, Veröffentlichungsplan oder Risikotoleranz. Es kann Hinweise aufdecken, aber die endgültige Entscheidung – ob ein Selektor geändert, eine Auszeit angepasst oder ein Defekt geöffnet wird – muss eine menschliche Entscheidung bleiben.
9. Wo Automatisierung hilft
- Beweissammlung – Playwrights integrierter
testInfound Trace-Viewer automatisieren die Erfassung deterministischer Daten und beseitigen manuelles Screenshot-Suchen. - Regel-Engine-Ausführung – Die Klassifikationsfunktion kann als GitHub-Aktionsschritt ausgeführt werden, der den Lauf mit einem Label (
infra,product,needs‑review) markiert. Dadurch entfällt die Notwendigkeit, jedes Fehlerprotokoll zu lesen. - Artefaktveröffentlichung – GitHub Actions speichert Traces und Screenshots automatisch als herunterladbare Artefakte und stellt sicher, dass die Daten unveränderlich und prüfbar sind.
- Benachrichtigungs-Routing – Basierend auf dem Label kann ein Workflow auf den entsprechenden Slack-Kanal posten oder ein Jira-Ticket erstellen, um sicherzustellen, dass das richtige Team das richtige Signal erhält.
Automatisierung schließt sich an Entscheidungsfindung zurück; sie liefert die Fakten, die eine schnelle, zuverlässige, menschliche oder KI-unterstützte Überprüfung ermöglichen.
10. Überprüfen Sie die Fragen
- Welches Playwright-Feld zeigt den aktuellen Wiederholungsversuch an, und warum ist es für eine deterministische Triage unerlässlich?
- Erklären Sie, warum ein Test, der bei einem erneuten Versuch besteht, dennoch geprüft werden sollte, bevor er als "unzuverlässig, aber harmlos" eingestuft wird.
- Listen Sie zwei Behauptungskategorien auf, die eher auf Infrastrukturprobleme als auf Produktmängel hinweisen.
- Was sind die drei möglichen Klassifikationsergebnisse der deterministischen Regel-Engine, und welche Aktion löst jede Aktion aus?
- Identifizieren Sie eine von der KI vorgeschlagene Handlung, die im Kategorie "Mehrdeutig" zulässig ist, und eine, die verboten werden muss.
11. Fazit
Unzuverlässige Tests sind unvermeidlich, aber die Art und Weise, wie wir sie handhaben, bestimmt, ob sie zu einer Produktivitätsbelastung oder zu einem handhabbaren Signal werden. Durch die Nutzung von Playwrights Retry-Metadaten, Trace-Artefakten und strukturierten Anhängen können wir eine deterministische Triage-Schicht aufbauen, die zuverlässig Hochvertrauens-Infrastruktur- oder Produktfehler von wirklich mehrdeutigen Fällen trennt. Nur letztere sollten an einen menschlichen Prüfer oder einen KI-Assistenten eskaliert werden, und selbst dann muss die Rolle der KI auf Vorschläge und nicht auf Ausführung beschränkt sein. Dieser disziplinierte Ansatz bewahrt die Testintegrität, hält die CI-Pipeline vertrauenswürdig und stellt sicher, dass Automatisierung ein Helfer und kein unkontrollierter Entscheidungsträger bleibt.
Quellen
- Playwright Test Versuche – https://playwright.dev/docs/test-retries
- Playwright Trace Viewer – https://playwright.dev/docs/trace-viewer
- GitHub Actions Dokumentation zum Artefakt-Upload – https://docs.github.com/en/actions/using-workflows/storing-workflow-data-as-artifacts
Kommentar hinterlassen
Teilen Sie Ihre Gedanken zum Artikel. Kein Konto erforderlich.
Kommentare
Kommentare werden geladen…