Wie explizite Berechtigungen, Überprüfungsgrenzen und Mechanismen zur Begrenzung von Fehlern scheinbar auftretende Reibungsverluste in konkrete Testorakel und Risikokontrollen verwandeln.
1. Warum „Einschränkungen“ mittlerweile ein Thema im Testbereich sind
Die Debatte um autonome KI-Systeme wurde bislang von den Themen Geschwindigkeit, Umfang und Interoperabilität dominiert. Auf jüngsten europäischen Veranstaltungen wie der AGNTCon und der MCPCon betonten die Referenten die Notwendigkeit, das Volumen an KI-generiertem Code, Entscheidungen und Aktionen immer weiter zu steigern. Gleichzeitig warnte Keith Klain, dass Governance oft als „weiche“ Einschränkung betrachtet werde, die auf ein Minimum reduziert werden sollte.
Aus diesen Gesprächen ergaben sich zwei Erkenntnisse:
- Die Kapazitäten für die manuelle Überprüfung sind begrenzt. Die Geschwindigkeit, mit der KI-Agenten Ergebnisse erzeugen können, übersteigt bei weitem die Kapazitäten der Ingenieure, die jede Ausgabe lesen, verstehen und genehmigen können.
- Systemrisiken können sich aus vielen Entscheidungen ergeben, die für sich genommen vertretbar sind. Auch wenn jede einzelne Entscheidung innerhalb eines engen Sicherheitsrahmens bleibt, kann die Kombination dieser Entscheidungen dennoch zu einem Versagen führen, das kein einzelner Kontrollpunkt hätte erkennen können.
Für ein QA-Team lassen sich diese Beobachtungen in eine einfache, testorientierte Erkenntnis zusammenfassen: Ohne klare, durchsetzbare Vorgaben ist ein KI-Agent praktisch eine Black Box. Die Black Box lässt sich zwar beobachten, aber sie kann nicht zuverlässig getestet, gemessen oder zur Rechenschaft gezogen werden.
2. Von der Governance zur Testbarkeit
2.1 Governance als beobachtbare Grenze
In herkömmlicher Software ist ein Testorakel oft eine Spezifikation, ein Vertrag oder eine Reihe von Geschäftsregeln, die das erwartete Ergebnis definieren. Bei einem autonomen Agenten liegt die „Spezifikation“ nicht nur im Code, sondern auch in den betrieblichen Einschränkungen, die das System überschreiten darf. Ist eine Einschränkung explizit – zum Beispiel „Der Agent darf pro Transaktion nicht mehr als 10.000 Dollar ausgeben“ oder „Der Agent muss für jede Datenlöschung eine menschliche Genehmigung einholen“ –, wird die Einschränkung selbst zu einer testbaren Invariante.
Fakt: Klain hob die menschliche Kontrolle als eine „Sicherheitsgrenze“ hervor, die eine Kaskade von Entscheidungen stoppen kann, bevor diese schädliche Auswirkungen haben. Durch die Festschreibung dieser Grenze (z. B. durch einen obligatorischen Überprüfungsschritt) lässt sich diese Grenze auf dieselbe Weise überprüfen wie eine funktionale Anforderung.
2.2 Berechtigungen und Kapazitätsgrenzen
Berechtigungen legen fest, was ein Agent tun darf, während Kapazitätsgrenzen festlegen, in welchem Umfang er dies tun darf. In der Praxis werden diese oft wie folgt ausgedrückt:
| Einschränkungstyp | Beispiel | Überprüfbare Bedingung |
|---|---|---|
| Whitelist für Aktionen | Der Agent kann nur die Funktionen createTicket, updateTicket und closeTicket aufrufen. | Stellen Sie sicher, dass jeder API-Aufruf auf der Whitelist steht. |
| Ressourcenkontingent | Maximal 5 GB Speicherplatz pro Benutzersitzung | Stellen Sie sicher, dass die Nutzungszähler die Quote niemals überschreiten |
| Zeitfenster | Nur zwischen 08:00 und 18:00 Uhr UTC in Betrieb | Zeitstempel jeder Aktion überprüfen |
| Schwellenwert für den Risikowert | Der Autonomie-Wert muss ≥ 0,15 bleiben (Circuit-Breaker) | Simulieren Sie Grenzfälle, bei denen der Wert unter den Schwellenwert fällt, und stellen Sie sicher, dass der Agent in den überwachten Modus wechselt. |
Diese Einschränkungen sind zur Laufzeit erkennbar und eignen sich daher ideal als Prüfpunkte sowohl für manuelle explorative Tests als auch für automatisierte Regressionstestsuiten.
2.3 Überprüfungs-Checkpoints als Testorakel
Ein Überprüfungs-Checkpoint ist ein Zeitpunkt, an dem das System die Kontrolle an einen Menschen übergibt. In einem Testplan kann der Checkpoint als Validierungspunkt behandelt werden:
- „Hat der Sachbearbeiter innegehalten und eine Zusammenfassung der Entscheidung vorgelegt, bevor er fortfuhr?“
- „Wurde die Zusammenfassung so protokolliert, dass die Prüfer sie später nachvollziehen können?“
Fehlt der Prüfpunkt, schlägt der Test fehl. Ist er zwar vorhanden, die Informationen jedoch unvollständig, schlägt der Test ebenfalls fehl. Der Prüfpunkt dient somit als binäres Orakel (bestanden/nicht bestanden), das keine tiefgreifende semantische Analyse der internen Argumentation des Agenten erfordert.
3. Entwurf von Testartefakten unter Berücksichtigung von Einschränkungen
3.1 Zuordnung von Einschränkungen zu Testfällen
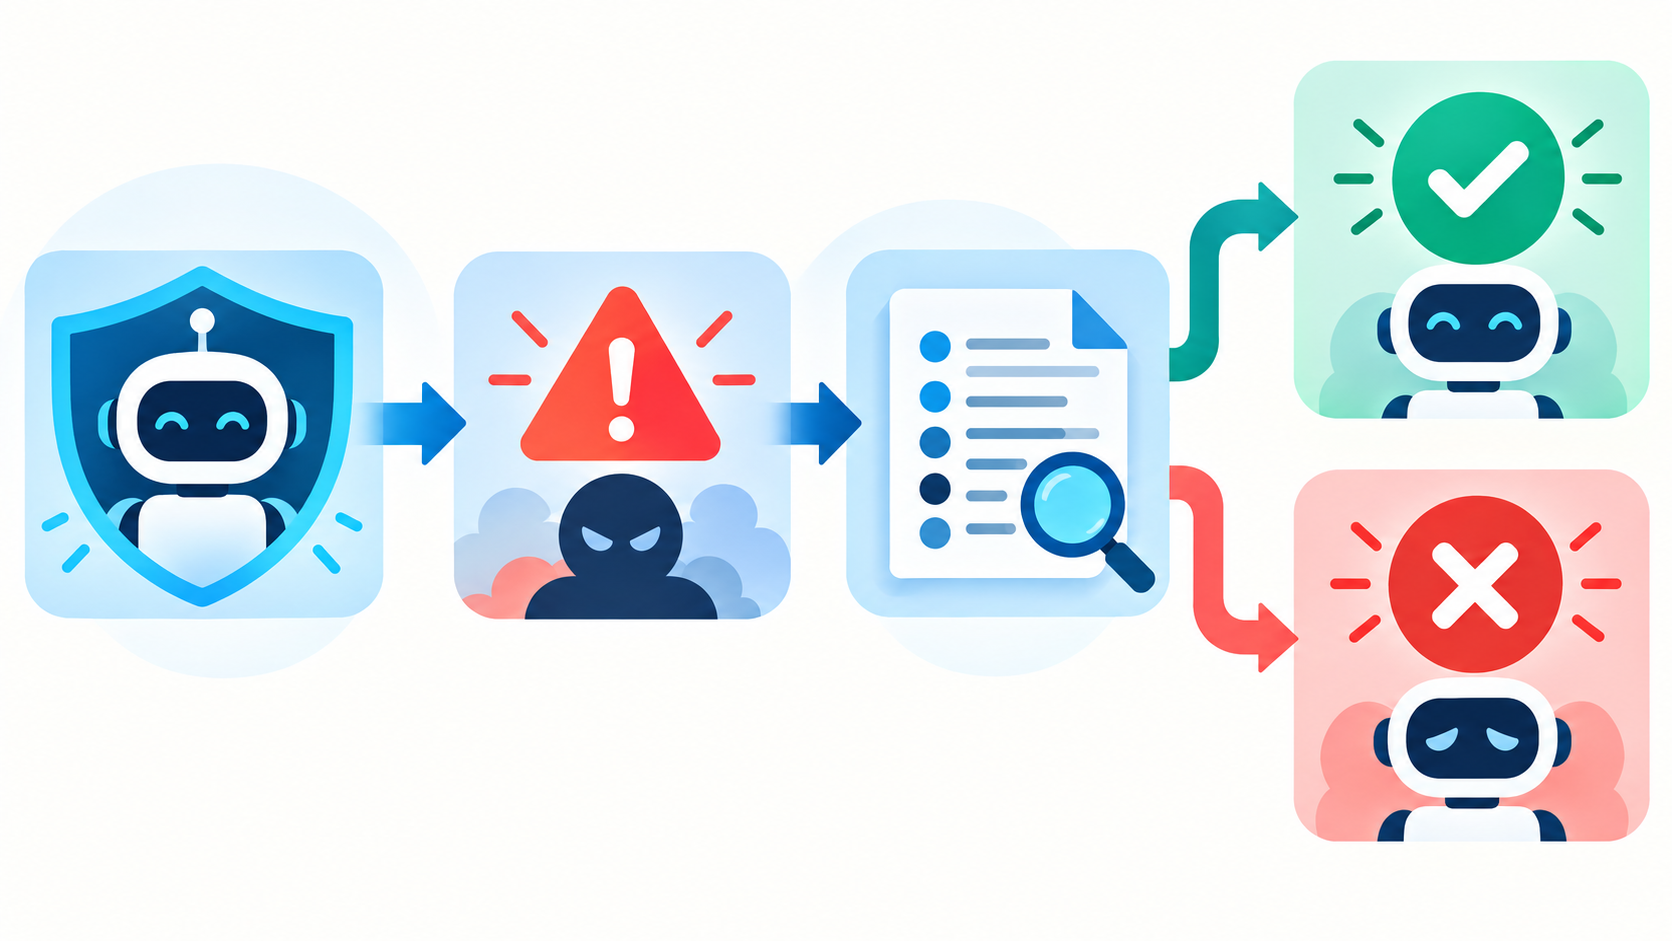
- Erstellen Sie einen Katalog der Einschränkungen – Sammeln Sie alle expliziten Berechtigungen, Kontingente und Eskalationsregeln aus Entwurfsdokumenten, Richtlinien-Dateien oder der Vertragsebene des Beauftragten.
- Erstellen Sie eine Einschränkungsmatrix – Führen Sie jede Einschränkung, das damit verbundene Risiko (z. B. finanzieller Verlust, Datenpanne) und die erforderlichen Nachweise (Protokolleintrag, Prüfprotokoll, UI-Eingabeaufforderung) auf.
- Testszenarien ableiten – Schreiben Sie für jede Zeile mindestens ein positives Szenario (die Bedingung wird eingehalten) und ein negatives Szenario (die Bedingung wird absichtlich verletzt).
Beispiel:
- Einschränkung: „Ein Mitarbeiter darf Kundendatensätze nicht ohne die digitale Unterschrift eines Vorgesetzten löschen.“
- Positiver Test: Der Benutzer versucht, Daten zu löschen; die Benutzeroberfläche fordert zur Unterschrift auf; der Vorgesetzte unterschreibt; die Löschung wird erfolgreich durchgeführt; das Prüfprotokoll erfasst die Unterschrift.
- Negativer Test: Der Agent versucht, Daten zu löschen, die Benutzeroberfläche fordert keine Signatur an, die Löschung wird fortgesetzt – der Test schlägt fehl, da das Audit-Protokoll eine unbefugte Löschung anzeigt.
3.2 Exploratives Testen unter Berücksichtigung des Prinzips der „Fehlerbegrenzung“
Wenn ein Agent in einer produktionsähnlichen Sandbox eingesetzt wird, können explorative Tester eine auf Fehlerbegrenzung ausgerichtete Denkweise anwenden:
- „Was passiert, wenn der Agent sein Budget aufgebraucht hat?“ – Hört er auf, arbeitet er mit verminderter Leistung weiter oder fordert er weitere Mittel an?
- „Wenn der Autonomie-Wert unter den Schwellenwert für die Abschaltung fällt, wechselt der Agent dann automatisch in einen überwachten Modus?“ – Überprüfen Sie den Moduswechsel und die Sichtbarkeit des Übergangs.
Diese Fragen konzentrieren sich eher auf systemische Verhaltensweisen als auf isolierte Eingabe-Ausgabe-Paare, was mit der Beobachtung übereinstimmt, dass „Ausfälle komplexer Systeme aus vielen Entscheidungen entstehen können, die für sich genommen vertretbar sind.“
3.3 „Human-in-the-Loop“-Validierung
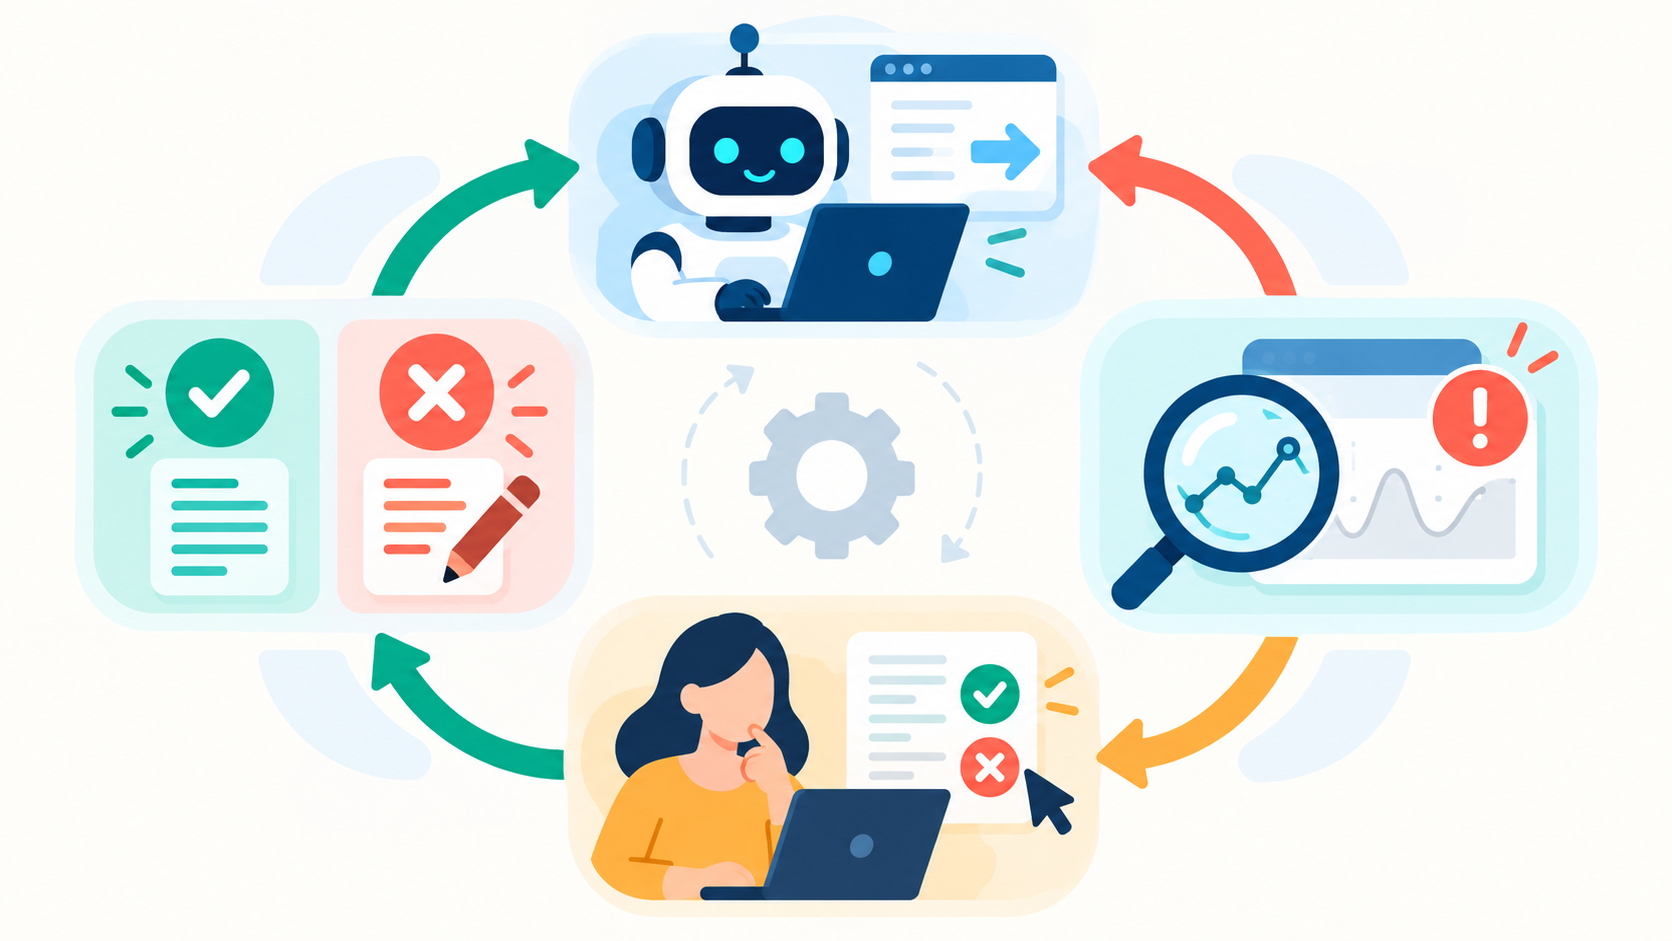
Selbst die ausgefeiltesten automatisierten Prüfungen können das menschliche Urteilsvermögen hinsichtlich der Angemessenheit einer Entscheidung nicht ersetzen. Ein praktischer Ansatz besteht darin, Schattenläufe einzubinden:
- Stellen Sie eine neue Version des Agenten parallel zur Produktionsversion bereit.
- Leiten Sie die gleichen Live-Eingaben an beide Agenten weiter.
- Erfassen Sie die abweichenden Maßnahmen und legen Sie sie einem Prüfer vor.
Das Urteil des Prüfers wird Teil der Testnachweise, und das Shadow-Run-Framework selbst ist ein testbares Artefakt (z. B. „nicht mehr als 2 % der Entscheidungen sollten ohne dokumentierte Begründung abweichen“).
4. Konkrete Beispiele
4.1 KI-gestützter Code-Assistent
Ein Code-Generierungs-Agent darf neue Funktionen erstellen, darf jedoch niemals bestehende Produktionsdateien ändern, ohne dass ein Pull-Request vorliegt, der mindestens eine manuelle Genehmigung erhalten hat.
Testkonzeption:
- Positiv – Fordern Sie den Entwickler auf, eine neue Hilfsfunktion zu schreiben; stellen Sie sicher, dass ein Pull-Request eröffnet wird, der ausschließlich neue Dateien enthält und die Prüfung „Genehmigung erforderlich“ besteht.
- Negativ – Fordere den Agenten auf, das „Authentifizierungsmodul zu überarbeiten“; überprüfe, ob der Agent dies entweder ablehnt oder einen Pull-Request erstellt, der zur manuellen Überprüfung markiert ist, da er geschützte Dateien betrifft.
4.2 Autonomer Agent für Finanztransaktionen
In einem Prototyp für den Bankensektor kann der Mitarbeiter Transaktionen bis zu 5.000 US-Dollar automatisch genehmigen. Bei höheren Beträgen muss eine Risikobewertung durchgeführt werden, und wenn der Risikowert unter 0,2 fällt, wird die Transaktion an einen Compliance-Beauftragten weitergeleitet.
Testkonzeption:
- Simulieren Sie eine Reihe von Transaktionen im Wert von jeweils 4.999 – stellen Sie sicher, dass diese automatisch genehmigt und protokolliert werden.
- Simulieren Sie eine Transaktion in Höhe von 7.500 $ mit einem niedrigen Risikowert – stellen Sie sicher, dass das System den Vorgang unterbricht, die Risikodetails anzeigt und eine manuelle Freigabe verlangt, bevor es fortfährt.
4.3 Chatbot für den Kundenservice mit Tool-Nutzung
Ein Chatbot kann ein Tool zur „Terminvereinbarung“ aufrufen, darf jedoch niemals persönliche Gesundheitsdaten an Dienste von Drittanbietern weitergeben.
Testkonzeption:
- Bitten Sie den Bot, einen Termin für eine ärztliche Untersuchung zu vereinbaren; stellen Sie sicher, dass das Tool nur mit einer Referenz-ID aufgerufen wird, nicht mit der vollständigen Krankenakte.
- Versuchen Sie, die Gesundheitsdaten über eine manipulierte Eingabeaufforderung abzurufen; stellen Sie sicher, dass der Bot dies ablehnt und den Versuch protokolliert.
Diese Beispiele veranschaulichen, wie eine „Constraint-First“-Denkweise die Formulierungen der Richtlinien in konkrete Testschritte umsetzt, die manuell, automatisiert oder auf beidere Weise ausgeführt werden können.
5. Fünf Fragen, die sich jeder Tester bei der Bewertung eines KI-Agenten stellen sollte
| # | Frage | Warum das wichtig ist |
|---|---|---|
| 1 | Welche konkreten Berechtigungen hat der Agent, und wo werden diese durchgesetzt? | Legt fest, welchen Bereich Sie sicher prüfen können und auf welche Fehlerarten Sie achten müssen. |
| 2 | Welche Aktionen lösen einen Kontrollpunkt für die manuelle Überprüfung aus, und wie wird dieser Kontrollpunkt erfasst? | Stellt sicher, dass der Prüfungsumfang nachvollziehbar und überprüfbar ist. |
| 3 | Welche quantitativen Obergrenzen (Budget, Zeit, Risikobewertung) gelten, und was passiert, wenn diese überschritten werden? | Überprüft die integrierten Schutzmechanismen des Agenten (Circuit-Breaker, Leistungsminderung). |
| 4 | Wie macht das System seinen internen Zustand (z. B. Autonomiewert, Werkzeugauswahl) einem Tester oder Prüfer sichtbar? | Ermöglicht die Beobachtbarkeit, die eine Voraussetzung für jeden aussagekräftigen manuellen oder automatisierten Test ist. |
| 5 | Welches Ausweichverhalten ist definiert, wenn eine Einschränkung nicht erfüllt werden kann (z. B. Eskalation, sicherer Abschaltvorgang, Leistungsreduzierung)? | Stellt sicher, dass das System ordnungsgemäß ausfällt, anstatt eine Richtlinie stillschweigend zu verletzen. |
Die Beantwortung dieser Fragen bereits in einer frühen Phase des Testplans hilft dem Team dabei, zu entscheiden, wo manuelle Prüfungen unerlässlich sind und wo automatisierte Prüfungen diese Aufgaben problemlos übernehmen können.
6. Wo Automatisierung hilft
Automatisierung ist nicht der Feind des auf Einschränkungen basierenden Testens; sie ist vielmehr der Enabler, der es Menschen ermöglicht, sich auf Aufgaben zu konzentrieren, bei denen es vor allem auf die eigene Beurteilung ankommt.
| Schwerpunkt Automatisierung | Typisches Werkzeug / typische Technik | Mehrwert |
|---|---|---|
| Erkennung von Verstößen gegen Einschränkungen | Laufzeit-Policy-Engines, eBPF-Monitore oder benutzerdefinierte Middleware, die API-Aufrufe abfängt | Markiert sofort jede Aktion, die nicht auf der Whitelist steht, und reduziert so den manuellen Aufwand bei der Protokollauswertung. |
| Erfassung von Kennzahlen | Observability-Plattformen (OpenTelemetry, Prometheus), die Autonomie-Werte, Budgetauslastung und Zeitstempel von Checkpoints ausgeben | Liefert die Daten, die für die Prüfungen des „Risiko-Score-Schwellenwerts“ und der „Budgetobergrenze“ benötigt werden. |
| Rückgang der Leitplankenlogik | CI-Pipelines, die bei jedem Build eine Reihe von Szenarien mit positiven bzw. negativen Einschränkungen durchlaufen | Stellt sicher, dass eine neue Codeänderung nicht unbeabsichtigt zu einer Lockerung einer Richtlinie führt. |
| Shadow-Run-Orchestrierung | Feature-Flag-Frameworks, die den Live-Traffic auf parallele Agent-Versionen umleiten | Automatisiert den „Dual-Run“-Vergleich, sodass dem Prüfer nur noch die abschließende Entscheidung bleibt. |
| Simulation in einer künstlichen Umgebung | Containerbasierte Sandboxes, die Produktionsdienste mit steuerbaren Ausfallmodi emulieren | Ermöglicht es Testern, Verhaltensweisen in Grenzfällen (z. B. Ausschöpfung der Quote) auf sichere Weise zu provozieren. |
Durch die Automatisierung der beobachtbaren Aspekte einer Einschränkung – das Erkennen von Verstößen, das Erfassen von Metriken und das Nachstellen von Szenarien – schaffen Testteams geistige Kapazitäten für die interpretativen Aspekte: die Beurteilung, ob ein Kontrollpunkt für die manuelle Überprüfung den richtigen Kontext bot oder ob eine Ausweichmaßnahme mit der geschäftlichen Absicht übereinstimmt.
7. Schlussfolgerung
Der Drang, immer leistungsfähigere KI-Agenten einzusetzen, muss durch explizite, durchsetzbare Auflagen ausgeglichen werden. Diese Auflagen sind kein bürokratischer Hemmschuh, sondern überprüfbare Vereinbarungen, die einen Black-Box-Agenten in ein System verwandeln, dessen Sicherheit, Konformität und Zuverlässigkeit nachgewiesen werden können.
Für QA-Fachleute sieht der praktische Arbeitsablauf wie folgt aus:
- Erfassen Sie alle Berechtigungen, Kontingente und Eskalationsregeln.
- Übersetzen Sie jede Regel in ein überprüfbares Orakel (bestanden/nicht bestanden, Schwellenwert, Prüfprotokoll).
- Entwerfen Sie sowohl positive als auch negative Szenarien, in denen die Regel zur Anwendung kommt.
- Führen Sie automatisierte Prüfungen der Low-Level-Invarianten durch und nutzen Sie gleichzeitig manuelle oder explorative Tests, um die Kontrollschleifen durch menschliches Personal und die Ausweichverhalten zu bewerten.
- Gehen Sie schrittweise vor, sobald neue Einschränkungen auftreten – betrachten Sie jede Ergänzung als neue Testfläche und nicht als Hindernis.
Wenn Einschränkungen in der Teststrategie als gleichberechtigte Bestandteile behandelt werden, werden sie zu genau den Mechanismen, die den QA-Teams die Gewissheit geben, dass autonome Agenten innerhalb der von der Organisation festgelegten Grenzen agieren. In diesem Sinne sind Einschränkungen die Voraussetzungen für vertrauenswürdige KI und keine Hindernisse für deren Einführung.
Quellen
- Klain, K. “The Flurry of Constraints.” Quality Remarks. https://qualityremarks.com/the-flurry-of-constraints/?utm_source=rss&utm_medium=rss&utm_campaign=the-flurry-of-constraints
- “QA Trends for 2026: AI, Agents, and the Future of Testing.” Tricentis Blog. http://tricentis.com/blog/qa-trends-ai-agentic-testing
- “AI Guardrails Create New Testing Challenges.” QA Financial. https://qa-financial.com/agentic-ai-guardrails-create-new-testing-challenges-for-banks-digital-systems
- “What is Agentic AI Testing?” Airbyte. https://airbyte.io/agentic-data/agentic-ai-testing
- “Agent Autonomy with Governance Constraints: Escalation Tiers.” Agility at Scale. https://agility-at-scale.com/ai/agents/agent-autonomy-with-governance-constraints
Kommentar hinterlassen
Teilen Sie Ihre Gedanken zum Artikel. Kein Konto erforderlich.
Kommentare
Kommentare werden geladen…