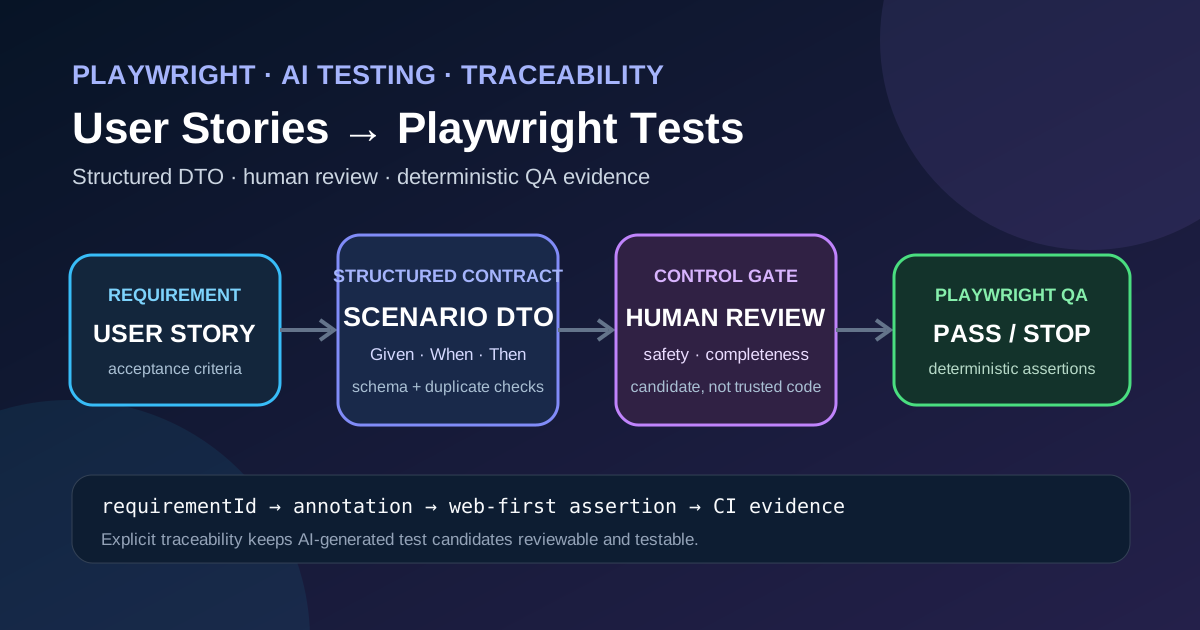
Praktische Anleitung, um Produktanforderungen in zuverlässige automatisierte UI‑Tests zu überführen, während der Mensch im Loop bleibt.
1. Einführung
Moderne agile Teams erfassen funktionale Intentionen als User Stories und Akzeptanzkriterien. Dieselben Artefakte können die Quelle für UI‑Level‑Testautomatisierung sein, aber die Übersetzung ist selten trivial. Große Sprachmodelle (LLMs) können Kandidaten‑Playwright‑Skripte aus einer normalisierten Beschreibung einer Story generieren, doch der erzeugte Code darf niemals ohne Verifizierung als produktionsreif angesehen werden.
Dieser Artikel beschreibt einen wiederholbaren, nachvollziehbaren Ablauf, der:
- Normalisiert eine User Story in ein strukturiertes Test‑Scenario‑DTO.
- Übergibt das DTO an ein LLM, das einen Kandidaten‑Playwright‑Test zurückgibt.
- Wendet menschliche Überprüfung, deterministische Assertions und Metadaten‑Annotationen an, die den Test zurück an die ursprüngliche Anforderungs‑ID binden.
- Veröffentlicht das Ergebnis im CI, wo der Test als Evidenz dient, nicht als Entscheidungs‑Engine.
Alle Schritte werden mit konkreten TypeScript‑Snippets, einem JSON‑Schema für das DTO und praktischen QA‑Schutzmaßnahmen beschrieben, wie Duplikat‑Scenario‑Erkennung, Prompt‑Injection‑Isolation und einer Checkliste für die Release‑Freigabe.
2. Der End‑to‑End‑Flow
User Story + Acceptance Criteria
          │
          ▼
Normalized Requirement (JSON)
          │
          ▼
Test‑Scenario DTO (structured)
          │
          ▼
LLM Prompt → Candidate Playwright Test (TS)
          │
          ▼
Human Review (review gate)
          │
          ▼
Annotated Playwright Test (tags, deterministic assertions)
          │
          ▼
CI Execution → Pass/Fail evidence
          │
          ▼
Regression Impact analysis
Jeder Pfeil stellt einen Hand‑off dar, der bewusst dokumentiert wird. Das einzige Artefakt, das automatisch zwischen den Phasen bewegt wird, ist das DTO – eine maschinenlesbare Darstellung, die validiert, versioniert und mit vorherigen Durchläufen verglichen werden kann.
3. Normalisierung der User Story
Eine rohe Story wie
> „Als Käufer möchte ich ein Produkt in den Warenkorb legen, damit ich es später kaufen kann.“
muss von erzählerischem Schnickschnack befreit und in ein kanonisches JSON‑Format überführt werden. Der Normalisierungsschritt wird von einem kleinen internen Skript (oder einem vertrauenswürdigen LLM mit festem Prompt) durchgeführt, das extrahiert:
- Anforderungs‑ID – z. B.
REQ‑1234. - Feature –
Shopping Cart. - Scenario – ein kurzer Titel, z. B.
Add product to cart. - Given / When / Then Klauseln, die die Akzeptanzkriterien spiegeln.
- Risk tags –
high‑value,auth‑required, usw.
Beispiel für normalisierte Ausgabe:
{
  "requirementId": "REQ-1234",
  "feature": "Shopping Cart",
  "scenarioId": "SCN-001",
  "title": "Add product to cart",
  "given": [
    { "type": "state", "description": "User is logged in", "role": "shopper" }
  ],
  "when": [
    { "action": "click", "target": "button[data-test='add-to-cart']", "productId": "123" }
  ],
  "then": [
    { "assertion": "cartContains", "productId": "123", "quantity": 1 }
  ],
  "risk": ["high-value"]
}
Das JSON‑Schema, das diese Struktur validiert, wird später im Artikel gezeigt.
4. Generieren eines Test‑Scenario‑DTO
Das DTO ist der Vertrag zwischen dem Anforderungsteam und dem KI‑Code‑Generator. Es enthält nur die Daten, die zur Erstellung eines deterministischen Testfalls nötig sind. Ein minimales Schema (kompatibel mit JSON Schema Draft‑07) sieht so aus:
{
  "$schema": "http://json-schema.org/draft-07/schema#",
  "title": "Playwright Test Scenario DTO",
  "type": "object",
  "required": ["requirementId","scenarioId","title","given","when","then"],
  "properties": {
    "requirementId": { "type": "string" },
    "scenarioId": { "type": "string" },
    "title": { "type": "string" },
    "given": {
      "type": "array",
      "items": { "$ref": "#/definitions/step" }
    },
    "when": {
      "type": "array",
      "items": { "$ref": "#/definitions/step" }
    },
    "then": {
      "type": "array",
      "items": { "$ref": "#/definitions/assertion" }
    },
    "risk": {
      "type": "array",
      "items": { "type": "string" }
    }
  },
  "definitions": {
    "step": {
      "type": "object",
      "required": ["action","target"],
      "properties": {
        "action": { "type": "string" },
        "target": { "type": "string" },
        "description": { "type": "string" },
        "productId": { "type": "string" }
      }
    },
    "assertion": {
      "type": "object",
      "required": ["assertion"],
      "properties": {
        "assertion": { "type": "string" },
        "productId": { "type": "string" },
        "quantity": { "type": "integer" }
      }
    }
  }
}
Das Schema wird zur Validierung verwendet, bevor das DTO das LLM erreicht. Ungültige Payloads werden frühzeitig abgelehnt, wodurch fehlerhafte Prompts, die zu mehrdeutigem Code führen könnten, verhindert werden.
5. Prompt‑Injection‑Isolation
Da das DTO aus einer nicht vertrauenswürdigen Quelle (dem Product Backlog) stammt, muss der Prompt, der das LLM füttert, sandboxed sein:
- Das DTO wird stringifiziert und in einen fest positionierten Platzhalter innerhalb einer Vorlage eingefügt.
- Die Vorlage interpoliert niemals Freitext; es sind nur die JSON‑Felder erlaubt.
- Die LLM‑Anfrage wird über einen dedizierten API‑Key mit einer Rate‑Limitierung gesendet, die sie von anderen Diensten isoliert.
Enthält das DTO bösartige Payloads (z. B. eine given‑Beschreibung, die Code enthält), wird das JSON‑Schema es ablehnen, und die Isolationsebene wird alle fremden Zeichen escapen, bevor sie das LLM erreichen. Dieser Ansatz mindert klassische Prompt‑Injection‑Angriffe und hält den Workflow gleichzeitig schnell.
6. Kandidaten‑Playwright‑Test (generiert)
Unten ist ein repräsentatives TypeScript‑Snippet, das ein LLM aus dem obigen DTO erzeugen könnte. Der Code wird nicht als korrekt angenommen, bis ein menschlicher Prüfer ihn freigibt.
import { test, expect } from '@playwright/test';

// Traceability tags – Playwright supports custom annotations
test.describe.configure({ mode: 'parallel' });

test('REQ-1234 SCN-001 Add product to cart', async ({ page }) => {
  // Tag the test with requirement metadata
  test.info().annotations.push({ type: 'requirement', description: 'REQ-1234' });
  test.info().annotations.push({ type: 'scenario', description: 'SCN-001' });

  // GIVEN – user is logged in
  await page.goto('https://example.com/login');
  await page.fill('#username', 'shopper@example.com');
  await page.fill('#password', 'securePass!');
  await page.click('button[type="submit"]');
  await expect(page).toHaveURL(/.*dashboard/);

  // WHEN – click add‑to‑cart button for product 123
  await page.goto('https://example.com/product/123');
  await page.click('button[data-test="add-to-cart"]');

  // THEN – cart must contain the product (deterministic oracle)
  await page.goto('https://example.com/cart');
  const cartItem = page.locator('li[data-test="cart-item-123"]');
  await expect(cartItem).toBeVisible();
  await expect(cartItem).toHaveText(/Quantity:\s*1/);
});
Wichtige Punkte:
- Annotations (
requirement,scenario) erhalten die Rückverfolgbarkeit in Testberichten. - Web‑first assertions (
await expect(page).toHaveURL,await expect(cartItem).toBeVisible) sind deterministisch, weil sie warten, bis die UI einen stabilen Zustand erreicht, bevor die Bedingung ausgewertet wird, wie in der Playwright‑Dokumentation zu Assertions und Test‑Annotations beschrieben. - Der Test enthält keine hartkodierten Geheimnisse; Anmeldeinformationen werden über Umgebungsvariablen in der CI‑Pipeline bereitgestellt (hier nicht gezeigt).
7. Menschliche Überprüfung und Review‑Gates
Der Kandidaten‑Test wird an ein Review‑Board weitergeleitet, das prüft:
- Semantische Treue – Testet der Test exakt die Akzeptanzkriterien?
- Sicherheit – Keine versehentliche Datenlöschung, keine hartkodierten Geheimnisse.
- Vollständigkeit – Sind negative Pfade, Grenzwerte und Aufräum‑Schritte vorhanden?
- Determinismus – Alle Assertions basieren auf Playwrights Warte‑Mechanismen; keine flüchtigen
setTimeoutHacks.
Ein Review‑Gate kann in CI erzwungen werden, indem ein signierter Git‑Commit (z. B. eine Signed-off-by:‑Zeile) verlangt wird, bevor der Test in den automation‑Branch gemergt wird. Automatisches Linting kann zudem prüfen, ob die erforderlichen Annotationen vorhanden sind.
8. Deterministische Orakel mit Web‑First Assertions
Playwrights Web‑First Assertions pollen automatisch das DOM, bis die erwartete Bedingung erfüllt ist oder ein Timeout abläuft. Dieses Verhalten eliminiert manuelle Sleeps und reduziert Flakiness. Im obigen Beispiel:
await expect(page).toHaveURL(/.*dashboard/)wartet, bis die Navigation abgeschlossen ist.await expect(cartItem).toBeVisible()wartet, bis das Element erscheint, wodurch sichergestellt wird, dass die nachfolgendetoHaveText‑Prüfung auf einem stabilen Element ausgeführt wird.
Da die Assertions eingebaut in Playwright sind, gehören sie zum dokumentierten Verhalten (siehe Playwright‑Test‑Assertions) und können als deterministische Orakel für Regressionsevidenz verwendet werden.
9. Nachverfolgbarkeit mit Tags und Annotationen erhalten
Playwright ermöglicht benutzerdefinierte Annotationen, die in Testberichten erscheinen und über die Befehlszeile (--grep @requirement=REQ-1234) gefiltert werden können. Ein typisches Muster:
test('Add product to cart', async ({ page }) => {
  test.info().annotations.push({ type: 'requirement', description: 'REQ-1234' });
  test.info().annotations.push({ type: 'risk', description: 'high-value' });
  // test body …
});
Diese Annotationen ermöglichen:
- Bidirektionale Nachverfolgbarkeit – Aus einer Anforderung können Sie alle erzeugten Tests finden, und aus einem fehlgeschlagenen Test können Sie sofort die betroffene Anforderungs‑ID sehen.
- Selektive Ausführung – Während eines Hot‑Fix‑Sprints können nur Tests mit einem bestimmten Risikotag ausgeführt werden.
Die Praxis, Anforderungs‑IDs direkt im Testnamen (REQ-1234 SCN-001 …) zu verankern, verstärkt die Nachverfolgbarkeit für Teams, die auf Namenskonventionen setzen.
10. Fehlende Test‑Dimensionen hinzufügen
KI‑generierte Kandidaten decken typischerweise nur den Happy‑Path ab. Das QA‑Team muss explizit hinzufügen:
- Negative Fälle – z. B. den Versuch, ein ausverkauftes Produkt hinzuzufügen, und das Fehlermeldungs‑Toast zu prüfen.
- Grenzwerte – z. B. die maximale zulässige Menge hinzufügen und die Grenze überprüfen.
- Autorisierungsprüfungen – bestätigen, dass ein Gastbenutzer nichts zum Warenkorb hinzufügen kann.
- Datenaufbereitung – das Produktkatalog mit dem erforderlichen
productIdvor dem Testlauf befüllen. - Aufräumen – das Element nach der Verifizierung aus dem Warenkorb entfernen, um die Umgebung sauber zu halten.
- Regressionseinfluss – dokumentieren, ob das Szenario gemeinsam genutzte Komponenten (Suche, Checkout) berührt, die Kaskadenfehler verursachen könnten.
Diese Ergänzungen sind manuell, können aber als Vorlage verwendet werden. Zum Beispiel kann eine „Negative‑Path“-Vorlage automatisch auf jeden generierten Test angewendet werden und den Prüfer auffordern, die spezifische Fehlersituation auszufüllen.
11. Duplikat‑ und Widerspruchsprüfungen
Bevor ein DTO an das LLM gesendet wird, wird das Repository vorhandener Szenarien gescannt:
- Duplikaterkennung – zwei DTOs mit identischen
given/when/then‑Sequenzen werden markiert. Das System schlägt eine Zusammenführung oder Umbenennung vor. - Widerspruchserkennung – wenn ein Szenario
cartContains(productId=123, quantity=1)behauptet, während ein anderes für dieselbe Vorbedingungquantity=0behauptet, wird eine Warnung ausgegeben.
Diese Prüfungen basieren auf einfachem strukturellem Hashing der when‑ und then‑Arrays und können als Pre‑Commit‑Hook ausgeführt werden.
12. Sicheres Logging und Beweiserfassung
Während der CI‑Ausführung:
- Testprotokolle werden von allen Anforderungs‑Payloads, die PII enthalten könnten, bereinigt. Nur die Anforderungs‑ID und das Ergebnis werden gespeichert.
- Screenshots bei Fehlern werden in einem Artefakt‑Bucket mit einer Namenskonvention gespeichert, die die Anforderungs‑ID (
REQ-1234_failure.png) enthält. - JUnit‑XML‑Berichte enthalten die benutzerdefinierten Annotationen, sodass nachgelagerte Dashboards Fehler mit Geschäftsanforderungen korrelieren können.
Die Protokolle werden zu Beweisen für Release‑Entscheidungen, aber die Entscheidung selbst bleibt ein menschliches Urteil, basierend auf dem deterministischen Bestehen/Fehlschlagen‑Ergebnis.
13. Prüfliste
Eine knappe Prüfliste, die der Prüfer vor dem Zusammenführen des Tests abzeichnet:
- [ ] DTO validiert gegen das JSON‑Schema.
- [ ] Anforderungs-ID und Szenario-ID erscheinen im Testnamen und in den Anmerkungen.
- [ ] Alle
given-Schritte sind in der Testumgebung reproduzierbar (keine fest codierten URLs). - [ ] Assertions verwenden die integrierten
expect-Methoden von Playwright (keine manuellen Sleeps). - [ ] Negative, Grenz‑ und Autorisierungsfälle werden dort hinzugefügt, wo das Risiko es verlangt.
- [ ] Datenaufbau und -bereinigung sind explizit und idempotent.
- [ ] Keine geheimen Werte sind fest codiert; stattdessen werden Umgebungsvariablen verwendet.
- [ ] Duplizierte oder widersprüchliche Szenarien wurden gelöst.
- [ ] Sichere Logging‑Konfiguration ist im CI‑Job aktiviert.
Erst wenn jedes Kästchen abgehakt ist, wechselt der Test zum automation-Branch.
14. Wo Automatisierung hilft
- Prompt-Generierung – Die Verwendung einer festen Vorlage, um ein validiertes DTO in einen Prompt zu verwandeln, eliminiert ad‑hoc Prompt‑Engineering.
- Schema‑Validierung – Automatisierte JSON‑Schema‑Checks fangen fehlerhafte Anforderungen ab, bevor sie das LLM erreichen.
- Duplikaterkennung – Ein leichtgewichtiges Skript kann redundante Szenarien früh markieren und den Wartungsaufwand reduzieren.
- CI‑Ausführung – Der parallele Test‑Runner von Playwright und integrierte Reporter liefern schnelles Feedback zu deterministischen Orakeln.
Automatisierung ersetzt nicht das menschliche Urteilsvermögen für:
- Entscheidung, ob ein generierter Test wirklich die Geschäftsabsicht widerspiegelt.
- Hinzufügen risikobasierter negativer Pfade, die Domänenwissen erfordern.
- Bewertung der Auswirkung eines Fehlers auf die Release‑Bereitschaft.
Das Gleichgewicht ist eine Human‑in‑the‑Loop‑Pipeline, bei der KI das Gerüst beschleunigt, während QA das finale Qualitätstor besitzt.
15. Prüfungsfragen
- Wie verbessert das Einbetten von Anforderungs‑IDs in Playwright‑Annotationen die Rückverfolgbarkeit?
- Welche Sicherheitsmaßnahmen verhindern Prompt‑Injection, wenn ein DTO an ein LLM übergeben wird?
- Warum gelten die web‑first Assertions von Playwright als deterministische Orakel?
- Nennen Sie drei Testdimensionen, die nach der KI‑Generierung manuell hinzugefügt werden müssen.
- Welche Rolle spielt die Duplikaterkennung bei der Pflege einer sauberen Testsuite?
16. Fazit
Die Umwandlung von User‑Stories in Playwright‑Tests mithilfe von KI kann die Zeit von der Anforderung bis zur automatisierten Verifizierung dramatisch verkürzen. Der Schlüssel zu einer zuverlässigen Pipeline ist explizite Rückverfolgbarkeit, deterministische Assertions und ein human‑centric Review Gate, das generierten Code als Kandidaten und nicht als Endprodukt behandelt. Durch die Normalisierung der Stories in ein validiertes DTO, die Isolation von Prompts, das Taggen von Tests mit Anforderungs‑Metadaten und die Ergänzung des Happy‑Path‑Skripts um negative, Grenz‑ und Aufräum‑Logik erhalten Teams reproduzierbare CI‑Beweise, während Release‑Entscheidungen fest in menschlicher Kontrolle bleiben.
Quellen
- Playwright‑Dokumentation – Test‑Annotationen: https://playwright.dev/docs/test-annotations
- Playwright‑Dokumentation – Test‑Assertions: https://playwright.dev/docs/test-assertions
Kommentar hinterlassen
Teilen Sie Ihre Gedanken zum Artikel. Kein Konto erforderlich.
Kommentare
Kommentare werden geladen…