Zielgruppe: QA‑Ingenieure, Testautomatisierungs‑Ingenieure und Softwareteams, die KI‑unterstützte Funktionen anbieten.
1. Warum ein risikobasierter Ansatz für KI unerlässlich ist
Traditionelle Regressionstests gehen davon aus, dass die Ausgabe einer Funktion deterministisch ist: Bei denselben Eingaben wird das gleiche Ergebnis erwartet. Generative KI, retrieval-augmentierte Modelle und große Sprachmodelle (LLMs) widerlegen diese Annahme. Ihre Ausgaben sind probabilistisch und können sich durch subtile Änderungen am Modell, an der Prompt-Formulierung, am Abrufkorpus oder an Systemanweisungen verschieben.
Das NIST AI Risk Management Framework (AI RMF) strukturiert das Risikomanagement mit den vier Funktionen Steuern, Kontext erfassen, Messen und Managen. Es beschreibt Merkmale vertrauenswürdiger KI wie Validität und Zuverlässigkeit, Sicherheit, Schutz und Resilienz, Verantwortlichkeit und Transparenz, Erklärbarkeit, Datenschutz sowie den Umgang mit schädlichen Verzerrungen. Dieser Artikel überträgt diese Prinzipien in eine projektspezifische Regressionsstrategie; NIST schreibt weder die konkrete Testmatrix noch die Zahlenwerte der Beispiele vor.
Eine risikobasierte Regressionsstrategie konzentriert den Testaufwand auf die Bereiche, in denen eine Änderung am wahrscheinlichsten einen Vertrag bricht oder ein unsicheres Verhalten einführt, anstatt eine umfassende Suite erneut auszuführen, die jeden Output als hartes Orakel behandelt.
2. Aufbau einer risikobasierten Regressionsmatrix
Die Matrix ordnet Änderungskategorien Risikobuckets und die Art der Beweise zu, die vor einer Veröffentlichung erforderlich sind. Sie klärt außerdem, wo sich jeder Test in der CI/CD-Pipeline befindet (Pull-Request, Nightly, Pre-Release).
| Änderungskategorie | Betroffene Risiken | Erforderliche Beweise | CI-Phase |
|---|---|---|---|
| Modellversion Bump | • Ausgangsdrift<br>• Sicherheits-Leitplanken-Regression<br>• Leistungsregression | • Baseline-Vergleich auf goldenem Datensatz (Score-Schwellenwerte)<br>• Drift-Monitoring-Metriken (z. B. KL-Divergenz)<br>• Metamorphe Invarianten | Nightly + Pre‑release |
| Eingabeaufforderung / Systeminstruktionsanpassung | • Schnelle Injektion, Zunahme von Halluzinationen<br>• Vertragsverletzung (z. B. Formatänderung) | • Invariante/Vertragstests auf einem repräsentativen Prompt-Set <br>• Adversarial-Prompt-Suite | Pull-Request (schnell) |
| Update zum Rückrufkorpus | • Wissensinkonsistenz <br>• Datenschutz-Leaks | • Geseedete Wiederholung von Abrufanfragen <br>• Berechtigungsgrenzüberprüfungen bei zurückgegebenen Dokumenten | Jede Nacht |
| Berechtigung / Werkzeugzugriffsänderung | • Unbefugte Nutzung von Werkzeugen<br>• Eskalation von Privilegen | • Permission-Boundary-Unit-Tests<br>• Rollenbasierte Zugriffssimulationen | Pull-Request |
| Deterministische Änderung der Geschäftsregel (z. B. Preisberechnung) | • Finanzielle Fehlkalkulation<br>• Regulatorische Nichteinhaltung | • Golden-Dataset-Assertions (exakte Übereinstimmung)<br>• Vertragstests auf API-Payloads | Pull-Request |
| Sicherheitsleitplanken-Update (z. B. Fluchenfilter) | • Schädliche <br>Inhaltslecks• Richtlinienverstöße | • Leitplanken-Regressionssuite (negative Tests)<br>• Human-Review-Stichprobe | Vorabveröffentlichung |
| UI / API-Integration ändert | • Gebrochene Verträge, fehlende Felder, Latenzspitzen | • Schema-Validierung (OpenAPI-Vertrag) <br>• End-to-End-UI-Fluss mit Playwright | Pull-Request + Nachts |
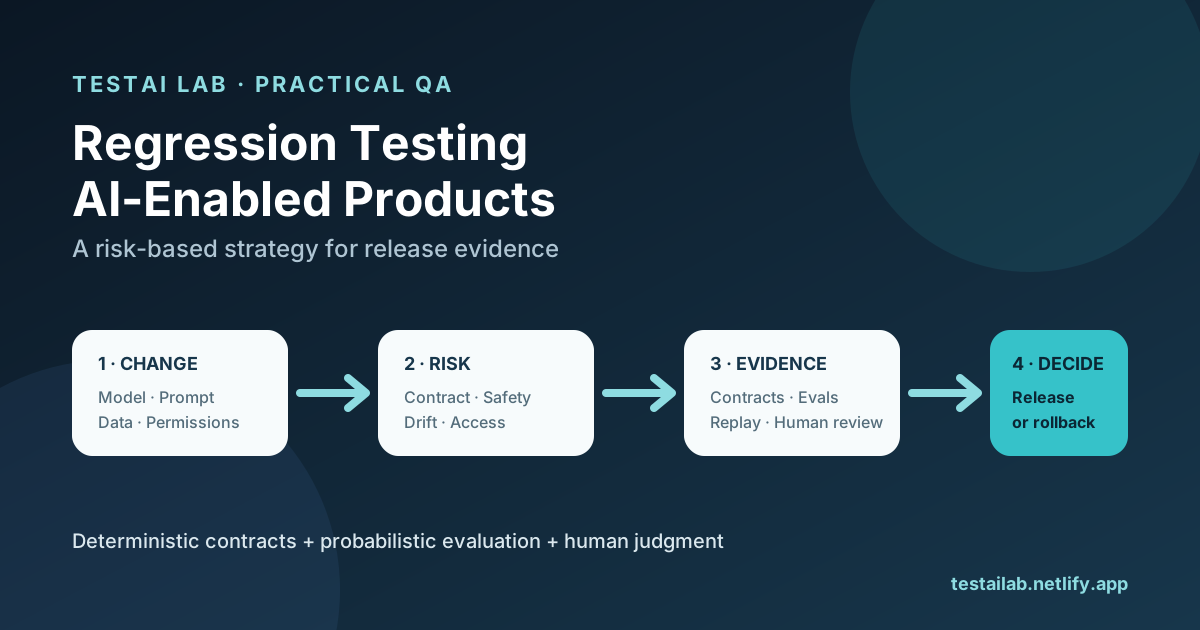
> Muster, das im gesamten Guide verwendet wird: > Änderung → betroffenen Risiken → Beweismittel → Freigabeentscheidung
3. Testtypen und wie sie in die Matrix passen
| Testtyp | Was es überprüft | Deterministisch vs. probabilistisch | Wohin man fliehen kann |
|---|---|---|---|
| Golden-Dataset (exakt-übereinstimmend) Behauptungen | Festvolumenverträge (z. B. "Umrechnung von USD in EUR") | Deterministisch | Pull-Request |
| Invariante / Vertragstests | API-Schema, erforderliche Felder, Antwortform | Deterministisch | Pull-Request |
| Metamorphe Tests | Die Beziehung zwischen Eingaben und Ausgaben (z. B. das Tauschen von Synonymen sollte die Sentiment-Polarität nicht verändern) | Probabilistische (Toleranzen) | Jede Nacht |
| Adversariale Prompt-Checks | Die Resistenz des Modells gegen Injektionen oder Jailbreak-Versuche | Probabilistisch (Bestehen/Nicht bestanden basierend auf Sicherheitsschwellenwerten) | Pull-Request |
| Berechtigungsgrenzen-Überprüfungen | Durchsetzung des rollenbasierten Werkzeugzugangs | Deterministisch (erlaubt/abgelehnt) | Pull-Request |
| Seed-Wiederholung der Abrufanfragen | Konsistenz abgerufener Dokumente nach Korpusänderung | Deterministisch für IDs, probabilistisch für Ranking | Jede Nacht |
| Baseline-Vergleich mit Score-Schwellenwerten | Gesamtqualitätsdrift (BLEU, ROUGE oder benutzerdefinierter Relevanzwert) | Probabilistische (Schwellenwerte) | Nightly + Pre‑release |
| Drift-Überwachungs-Dashboards | Kontinuierliche statistische Überwachung der Modellausgabeverteilungen | Probabilistisch | Fortlaufend (nach der Veröffentlichung) |
| Rollback-Tor | Automatisierter Block, wenn Drift vordefinierte Grenzen überschreitet | Probabilistisch (Gatterbedingung) | Vorabveröffentlichung |
| Menschliche Bewertungsstichprobe | Qualitative Bewertung von Randfällen und Sicherheitsgeländern | Mensch-in-der-Schleife (subjektiv) | Vorabveröffentlichung |
3.1 Kompaktes Beispiel: Prompt‑Änderung
Änderung: Die Systemanweisung wird von "Antworten Sie knapp" auf "Antworten Sie knapp, Begrenzung auf zwei Sätze" geändert.
Betroffene Risiken:
- Möglichkeit der Abkürzung wesentlicher Informationen (Vertragsbruch).
- Erhöhte Wahrscheinlichkeit mehrdeutiger Formulierungen, die missverstanden werden könnten.
Beweis:
- Führe einen Vertragstest auf einer Menge von 20 kritischen Eingabeaufforderungen durch; stelle fest, dass die erforderlichen Felder (z. B.
answer.summary) vorhanden sind und ≤ 2 Sätze lang sind. - Führe einen adversarialen Prompt aus, der versucht, das Modell zum Überschreiten der Grenze zu zwingen; überprüfe, ob die Leitplanke blockiert oder trunkiert.
Freigabeentscheidung: Wenn alle Vertragstests bestehen und keine Schutzverstöße festgestellt werden, kann die PR zusammengeführt werden. Wenn ein Prompt ein fehlendes Feld erzeugt, wird die Änderung abgelehnt und das Team überprüft die Instruktionsformulierung erneut.
3.2 Kompaktes Beispiel: Modellversion‑Upgrade
Veränderung: Upgrade von model‑v1.2 auf model‑v1.3.
Betroffene Risiken:
- Ausgabedrift bei Kernanwendungen (z. B. Zusammenfassungen).
- Rückschritt der Sicherheitsleitplanken (neue toxische Sprachmuster).
Beweis:
- Goldener Datensatz mit 500 Zusammenfassungseingaben; berechnet ROUGE-L-Werte anhand einer Referenz. Benötigt ≥ Durchschnitt von 0,85.
- Sicherheitsleitplanken-Suite mit 100 bekannten toxischen Hinweisen; Stellen Sie ≤ Bestehensquote von 1 % sicher.
- Drift-Metriken (z. B. KL-Dilegenz der Token-Verteilungen) müssen unter 0,02 bleiben.
Release-Entscheidung: Wenn eine Kennzahl außerhalb der Schwellenwerte liegt, wird das Upgrade blockiert und ein Rollback-Gate wird ausgelöst. Das Team muss möglicherweise die Leitplanken fein abstimmen oder anpassen, bevor es weitermacht.
4. Organisation der Testdurchführung in CI/CD
| Pipeline-Phase | Typisches Testset | Begründung |
|---|---|---|
| Pull-Request (schnelles Feedback) | • Vertrags- und Schematests<br>• Permission-Boundary-Unit-Tests<br>• Kleine adversariale Prompt-Suite<br>• UI-Rauch mit Playwright (kritische Flüsse) | Schnell zum Laufen, fängt Regressionen auf, die den Build zerstören würden. |
| Jede Nacht (vollständige Regression) | • Metamorphe- und Invarianzsuiten<br>• Golden-Dataset-Baseline-Vergleiche<br>• Wiederholung der <br>Abrufe• Driftberechnungen<br>• Vollständige UI-End-to-End-Suite | Ermöglicht längerlaufende, datenintensive Tests, ohne Entwickler zu blockieren. |
| Vorabveröffentlichung (Gate vor der Produktion) | • Vollständige Sicherheitsschutz-Regression<br>• Bewertungs-Schwellen-Prüfungen des neuesten <br>Modells• Rollback-Gate-Bewertung<br>• Menschliche Überprüfungsstichproben (z. B. 0,5 % des Produktionsverkehrs) | Bietet die endgültige Zusicherung, dass die Freigabe die Risikotoleranzen erfüllt. |
Implementierungstipp: Nutze GitHub Actions, um Zusammenführungen in der PR-Suite zu gaten (actions/checkout, actions/setup-python usw.) und um nächtliche Workflows nach einem Zeitplan auszulösen
Für UI-Tests enthält die offizielle Playwright-Dokumentation eine eigene CI-Anleitung mit Beispielen für GitHub Actions: https://playwright.dev/docs/ci
5. Unterscheidung deterministischer Behauptungen von probabilistischen Bewertungen
| Aspekt | Deterministisch | Probabilistisch |
|---|---|---|
| Natur des Orakels | Exakter Wert oder Präsenz (z. B. JSON-Feld status: "OK"). | Statistisch oder toleranzbasiert (z. B. durchschnittlicher BLEU ≥ 0,78). |
| Fehlermodus | Binär – bestanden/nicht. | Es kann eine Schwellenabstimmung erfordern; gelegentlicher "falsch-negativer" Drift ist akzeptabel, sofern es innerhalb der Grenzen liegt. |
| Typischer Test | Schema-Validierung, Berechtigungsprüfungen, exakte Übereinstimmung mit dem goldenen Datensatz. | Metamorphe Relationen, Punktschwellenwerte, Driftmetriken. |
| Menschliche Beteiligung | Meistens gar keine. | Oft handelt es sich um eine Überprüfung von Ausreißern oder Trendanalysen. |
Bei der Dokumentation eines Tests sollte immer angegeben werden, ob die Behauptung deterministisch oder probabilistisch ist, und die Toleranz oder Schwelle angeben, die ein Bestehen definiert.
6. "Änderung → betroffenen Risiken → Beweismittel → Entscheidung zur Freigabe" in der Praxis
Nachfolgend finden Sie eine prägnante Checkliste, die QA-Leiter in die Release Notes einbetten können.
| Veränderung | Betroffene Risiken | Gesammelte Beweise | Entscheidung |
|---|---|---|---|
| Neue Werkzeugintegration (z. B. Code-Generierungs-Plugin) | Unbefugte Ausführung, Datenexfiltration | Permission-Boundary-Unit-Tests (alle abgelehnt für nicht-administrative Rollen) + Sicherheits-Guardrail-Negativtests (kein Code für nicht erlaubte Domains ausgegeben) | ✅ Zusammenführen; Protokolle nach der Freigabe überwachen |
| Überarbeitung der Prompt-Vorlage | Inkonsistenter Tonfall, fehlende Quellenangaben | Vertragstests mit 30 Schlüssel-Prompts (Zitationsfeld vorhanden) + metamorpher Test (die Neuordnung der Aufzählungspunkte ändert keine Zitationsanzahl) | ⚠️ Fehlschlagen – Vorlage überarbeiten, um die Zitationslogik zu erhalten |
| Rückruf-Korpus-Aktualisierung | Veraltetes Wissen, Datenschutzlecks | Seeded Replay von 100 bekannten Abfragen (IDs stimmen überein) + Datenschutzprüfung (keine personenbezogenen Daten in Top-5-Ergebnissen) | ✅ Beförderung zur Vorveröffentlichung; Planen Sie das nächste abendliche Audit |
| Sicherheitsregeln werden verschärft | Überblocken legitimer Anfragen | Guardrail-Regressionssuite (≤ 2 % falsch-positiv bei gutartigen Prompts) + menschliche Überprüfung von 20 ausgewählten blockierten Antworten | ✅ Freigabe mit Rollback-Gate auf 5 % Falsch-Positive-Erhöhung eingestellt |
7. Wo Automatisierung hilft
- Schnelle deterministische Überprüfungen – Schema-Validierung, Berechtigungsdurchsetzung und exakt-übereinstimmende goldene Datensätze sind ideal für die Automatisierung auf PR-Ebene.
- Statistische Driftüberwachung – automatisierte Berechnung von KL-Divergenz-, BLEU- oder benutzerdefinierten Relevanzscores kann nachts ausgeführt und Feed-Dashboards durchführen.
- Metamorphe Testgenerierung – Werkzeuge können programmatisch Eingabevariationen (z. B. Synonymwechsel) erstellen, um probabilistische Invarianten zu üben.
- Adversarial Prompt Fuzzing – CI kann eine kuratierte Liste von Jailbreak-Versuchen einfügen und überprüfen, ob Sicherheitsfilter ausgelöst werden.
- Rollback gating – CI-Pipelines können die Promotion automatisch stoppen, wenn Drift-Metriken die Schwellenwerte überschreiten, was den menschlichen Aufwand reduziert.
Automatisierung ersetzt nicht menschliches Urteil für sicherheitskritische oder politikgetriebene Ergebnisse. Menschliche Überprüfung bleibt unerlässlich, um nuancierte Schäden, Verzerrungen oder regulatorische Compliance zu bewerten.
8. Praktische Schritte zum Einstieg
- Verträge identifizieren – Liste alle deterministischen Ausgaben auf (API-Schemata, UI-Elemente, Geschäftsregelberechnungen).
- Definiere Risikobuckets – Verbinde jeden Vertrag mit den Änderungskategorien, die ihn beeinflussen könnten (Modell, Prompt, Daten, Berechtigungen).
- Wähle Beweistypen aus – Wähle deterministische Behauptungen für Verträge und probabilistische Schwellenwerte für Qualität/Sicherheit.
- Die Regressionsmatrix erstellen – Fülle die Tabelle in Abschnitt 2 aus; speichere sie in einem versionskontrollierten Dokument.
- CI-Hooks implementieren – Nutzen Sie GitHub Actions oder Ihre CI-Plattform, um in jeder Pipeline-Phase die passende Suite auszuführen.
- Schwellenwerte und Gates festlegen – Leiten Sie messbare Grenzwerte aus der projektspezifischen Risikotoleranz und aus Baseline-Daten ab. Beispielsweise kann ein Team höchstens 0,5 % zusätzliche Fehler bei schädlichen Inhalten zulassen; dieser Wert ist eine beispielhafte Projektregel und keine NIST-Empfehlung.
- Human-Review-Checkpoints hinzufügen – Stichprobengröße und Kriterien für die manuelle Pre-Release-Bewertung definieren.
- Iterieren – Nach jeder Veröffentlichung überprüfen Sie Driftprotokolle und Vorfallberichte; passen Sie die Matrix, Schwellenwerte an oder testen Sie die Abdeckung entsprechend.
9. Überprüfungsfragen
- Was unterscheidet einen deterministischen Regressionstest von einem probabilistischen Test und warum ist diese Unterscheidung für KI-gestützte Produkte wichtig?
- Wie hilft das Muster "Change → affected risks → evidence → release decision" QA-Teams dabei, den Testaufwand zu priorisieren?
- Nenne drei Testtypen, die sich am besten für die Validierung von Pull-Requests eignen, und erkläre warum.
- Welche Kennzahlen können in einer nächtlichen Driftüberwachungssuite verwendet werden, um unerwünschte Änderungen nach einem Modell-Upgrade zu erkennen?
- Warum ist ein menschlicher Überprüfungsschritt erforderlich, selbst wenn automatisierte Sicherheitssperrtests bestehen?
10. Fazit
Regressionstests für KI-gestützte Systeme können sich nicht auf eine einzige "goldene Antwort" verlassen. Durch Klassifizierung von Änderungen, Zuordnung zu konkreten Risiken und Sammeln der richtigen Mischung aus deterministischen und probabilistischen Beweisen können Teams informierte Release-Entscheidungen treffen und dabei Sicherheit, Compliance und Qualität unter Kontrolle halten. Die Integration dieser risikobasierten Matrix in den CI/CD-Workflow – Pull-Request-Prüfungen für schnelle deterministische Verträge, nächtliche Suiten für statistische Drift und Pre-Release-Gates für Sicherheitsgeländer – bietet einen skalierbaren, wiederholbaren Prozess, der mit dem NIST KI Risk Management Framework und den besten Branchenpraktiken übereinstimmt.
Quellen
- NIST AI Risk Management Framework 1.0 — Funktionen Govern, Map, Measure und Manage sowie Merkmale vertrauenswürdiger KI. https://www.nist.gov/itl/ai-risk-management-framework
- OWASP Top 10 for LLM and Generative AI Applications — Sicherheitsrisiken einschließlich Prompt Injection. https://genai.owasp.org/
- GitHub-Actions-Dokumentation — ereignisgesteuerte, manuelle und geplante Workflows. https://docs.github.com/en/actions
- Playwright-Dokumentation — offizielle CI-Anleitung und Beispiele für GitHub Actions. https://playwright.dev/docs/ci
Kommentar hinterlassen
Teilen Sie Ihre Gedanken zum Artikel. Kein Konto erforderlich.
Kommentare
Kommentare werden geladen…