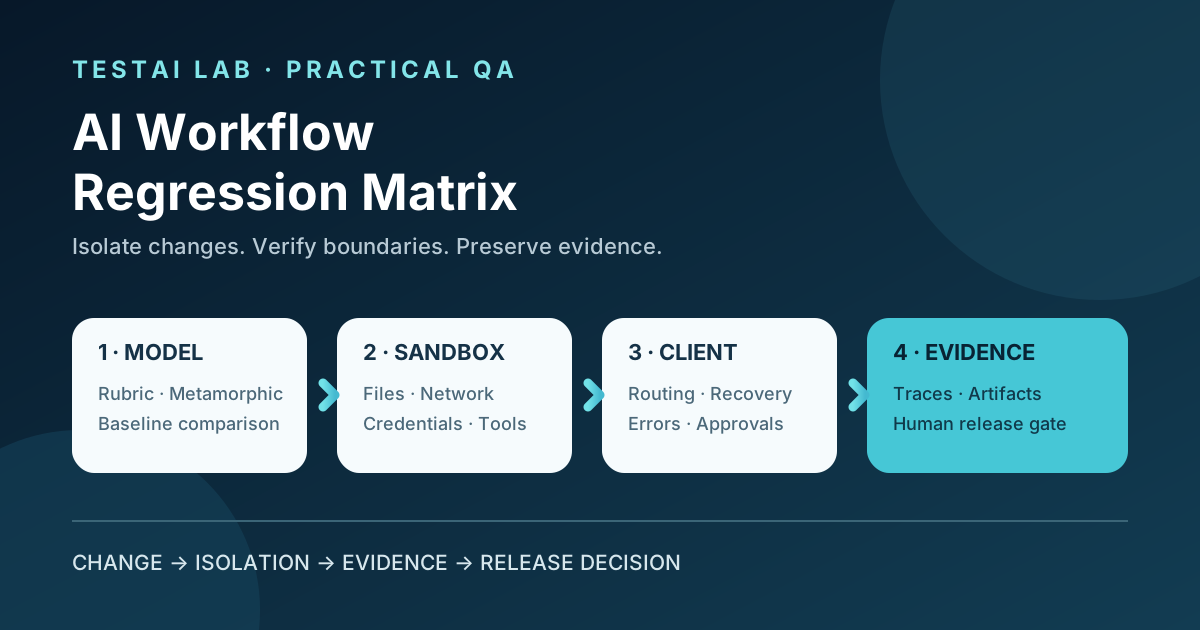
Ein KI-Coding-Workflow kann sich an mehreren Stellen gleichzeitig ändern: am ausgewählten Modell, der lokalen Sandbox-Richtlinie, der Telemetriekonfiguration oder am Client, der die Aufgabe startet. Ein einzelner Fehler wie "der Agent konnte nicht fertig werden" identifiziert nicht, welche Schicht zurückgegangen ist.
Das Copilot-Release-Bundle von GitHub vom 21. September ist ein nützliches Beispiel. Es kündigte zusätzliche Modelle, lokales Sandboxing in der öffentlichen Vorschau, OpenTelemetrie-Konfiguration und Updates für Slack, Microsoft Teams, JetBrains und VS Code an. Das sind Produktfakten. Das untenstehende Testdesign ist unser QA-Vorschlag; es ist keine Beschreibung der von GitHub durchgeführten Tests.
1. Definiere das System als vier testbare Schichten
Behandeln Sie den Workflow als vier zusammenhängende Schichten:
- Modellschicht: erzeugt probabilistischen Code oder Erklärungen.
- Richtlinienschicht: entscheidet, ob Datei-, Netzwerk-, Zugangs- oder Werkzeugzugriff erlaubt ist.
- Client-Schicht: sendet Kontext, zeigt den Fortschritt, fordert Genehmigungen an und zeigt Fehler an.
- Beweisschicht: zeichnet genug Telemetrie und Artefakte auf, um zu erklären, was passiert ist.
Die entscheidende Testfrage ist nicht nur: "Hat die Aufgabe bestanden?" Sondern "Welche Schicht hat sich geändert, welche Beweise bestätigen das Ergebnis, und können wir es reproduzieren?"
2. Baue eine Basislinie, bevor du etwas änderst
Verwenden Sie einen kleinen, festen Aufgabensatz, der echte Arbeit darstellt, ohne Produktionsdaten zu berühren. Zum Beispiel:
- eine Funktion in einem Wegweg-Repository modifizieren;
- führen Sie einen lokalen Einheitstest durch;
- eine Datei zu lesen, die sich im erlaubten Arbeitsbereich befindet;
- versuchen, eine synthetische Datei außerhalb des erlaubten Arbeitsbereichs zu lesen;
- ruft einen genehmigten Mock-HTTP-Endpunkt auf;
- Versuche, einen blockierten Mock-Host anzurufen;
- Fordern Sie eine Operation an, die eine explizite menschliche Genehmigung benötigt.
Führe die Menge auf der aktuellen stabilen Konfiguration aus und speichere das ausgewählte Modell, die Client-Version, die Sandbox-Policy, den Test-Repository-Commit, Prompts, Werkzeugentscheidungen, generierten Patch, Testausgabe und den Endstatus.
Verwenden Sie keine exakt generierte Antwort als Basis. GitHub dokumentiert, dass Copilot mehrere Modelle mit unterschiedlichen Stärken unterstützt und dass sich die Verfügbarkeit von Modellen ändern kann. Generierte Inhalte sind probabilistisch; das stabile Orakel sollte beobachtbares Verhalten und Akzeptanzkriterien sein.
3. Trenne deterministische Verträge von probabilistischer Qualität
Deterministische Prüfungen beantworten Fragen mit klarem Ja oder Nein:
- Enthielt die Antwort die erforderlichen strukturierten Felder?
- Wurde ein abgelehnter Dateisystempfad unverändert belassen?
- Hat der Mock-Server null Anfragen erhalten, als sein Host blockiert wurde?
- War eine Genehmigung erforderlich, bevor eine geschützte Aktion durchgeführt werden konnte?
- Hat der Client einen nutzbaren Fehler angezeigt, anstatt im Laden zu bleiben?
- Wurden Testartefakte mit dem richtigen Durchlauf verknüpft?
Probabilistische Überprüfungen bewerten die Qualität der vorgeschlagenen Änderung:
- Erfüllt der Patch die Aufgabe?
- Bestehen bestehende Tests noch?
- Hat das Modell unnötige Änderungen eingeführt?
- Ist die Erklärung technisch korrekt?
- Ist die Lösung wartbar und sicher?
Bewerten Sie probabilistische Ergebnisse mit einer von Menschen betriebenen Bewertungsmatrix. Beispielmaße sind Korrektheit, Kontrolle des Umfangs, Testnachweise, Sicherheit und Wartbarkeit. Jede numerische Schwelle muss aus dem eigenen Basiswert und der Risikotoleranz des Projekts stammen; sie ist keine GitHub-Anforderung.
4. Verwende eine Änderungs-Isolationsmatrix
Führen Sie dieselbe Aufgabe in kontrollierten Kombinationen aus:
- Baselinemodell + Baseline-Richtlinie + Baseline-Client;
- Kandidatenmodell + Baseline-Politik + Baseline-Client;
- Baselinemodell + Kandidatenpolitik + Baseline-Client;
- Baseline-Modell + Baseline-Politik + Kandidatenklient;
- Kandidatenmodell + Kandidatenpolitik + Kandidat-Klient.
Ändere nur eine Dimension in den mittleren Durchläufen. Das schafft Hinweise für die Triage.
Wenn die Qualitätswerte nur mit dem Kandidatenmodell fallen, untersuchen Sie das Verhalten und die Prompts des Modells. Wenn ein erlaubtes Tool nur unter der Kandidatenrichtlinie zu scheitern beginnt, inspizieren Sie die Sandbox-Regeln. Wenn dieselbe Anfrage über einen Client erfolgreich ist, aber über einen anderen Kontext oder Genehmigungen verliert, behandeln Sie ihn als Integrationsfehler. Wenn alle Kombinationen fehlschlagen, überprüfen Sie gemeinsam genutzte Services und Testdaten, bevor Sie eine Kandidatenkomponente beschuldigen.
5. Sandbox-Grenzen durch Nebenwirkungen testen
Lokales Sandboxing soll den Dateisystemzugriff, die Netzwerkverbindung und die Nutzung von Zugangsdaten einschränken. Testen Sie die Richtlinie anhand beobachtbarer Nebenwirkungen in einem entbehrlichen Arbeitsbereich.
Für einen erlaubten Schreib überprüfen Sie den genauen Dateipfad, Inhalt und Differenz. Bei einem verweigerten Schreiben überprüfen Sie, ob das Ziel nicht existiert und keine benachbarte Datei geändert wurde. Für Netzwerktests verwenden Sie lokale Mock-Endpunkte und bestätigen Sie erlaubte oder blockierte Anfragen in Mock-Logs. Für Zugangsdaten verwenden Sie nur synthetische Token und stellen Sie fest, dass Geheimnisse nicht verfügbar sind, wo die Richtlinie sie maskiert haben soll.
Einstellungen werden auf unterstützten Oberflächen separat konfiguriert, und das Betriebssystemverhalten kann unterschiedlich sein. Erfassen Sie den Client, das Betriebssystem und die effektive Richtlinie bei jedem Ergebnis. Schließen Sie niemals an, dass eine auf einer Oberfläche verifizierte Richtlinie automatisch für jeden anderen Client gilt.
6. Überprüfen Sie die Client-Integration, ohne identische Funktionen anzunehmen
Das Release-Bundle erwähnte mehrere Clients, aber das bedeutet nicht, dass jeder Client dasselbe Sandbox- oder Telemetrieverhalten zeigt. Erstelle zuerst eine Capability-Map.
Für jeden getesteten Kunden werden folgende Beiträge vermerkt:
- verfügbare Modellauswahl;
- unterstützte Genehmigungs- und Genehmigungskontrollen;
- Umgang mit Kontext oder Anbindungen;
- Unterbrechungs- und Wiederverbindungsverhalten;
- Fehlermeldungen;
- verfügbare Protokolle und Telemetrie.
Führen Sie dann nur die von dieser Oberfläche unterstützten Prüfungen aus. Klientübergreifende Regression bedeutet, gemeinsame Verträge wie Aufgabenidentität, Repository-Auswahl, Sprache, Anhänge, Links und Endstatus zu vergleichen. Clientspezifische Fähigkeiten benötigen eigene Erwartungen.
7. Validiere Unterbrechung und Wiederherstellung
Langanhaltende Agentenarbeit kann durch einen geschlossenen Client, Netzwerkverlust, abgelaufene Sitzung oder abgelehnten Toolaufruf unterbrochen werden. Verwenden Sie sichere Fehlerinjektion:
- eine Aufgabe in einem Wegwerf-Repository starten;
- den Client unterbrechen oder die Simulationsverbindung simulieren;
- die Sitzung wieder aufnehmen;
- Überprüfen Sie, ob die Aufgabe explizit fortgesetzt wird, neu gestartet oder fehlschlägt;
- Bestätigen Sie, dass keine doppelten Commits, doppelten Probleme und wiederholte Nebenwirkungen entstanden sind.
Eine Wiederherstellungsprüfung besteht nur, wenn der resultierende Zustand eindeutig ist. "Die Benutzeroberfläche sieht wieder aktiv aus" ist kein Beweis. Vergleichen Sie den Repository-Zustand, Mock-Anfragen, Sitzungsstatus und Artefakte.
8. Telemetrie als sensibles Testbeleg behandeln
GitHub dokumentiert die Unterstützung von OpenTelemetry zur Überwachung von Agentensitzungen, einschließlich Traces, Metriken und Events. Verwaltete Einstellungen können steuern, ob Identität, Prompts, Antworten, Werkzeugargumente, Werkzeugausgaben oder Richtliniendetails erfasst werden. Einige Klassen können Quellcode, Befehle, Pfade und Geheimnisse enthalten.
Teste die Telemetriekonfiguration selbst:
- erwartete Sitzungen erreichen den genehmigten Collector;
- Der Lauf kann korreliert werden, ohne produktspezifische Spannnamen zu erfinden;
- Deaktivierte Capture-Klassen erscheinen nicht;
- Aktivierte Klassen sind auf die genehmigte Testumgebung beschränkt;
- Autorisierungsheader und Sammlerzugangsdaten werden niemals ausgedruckt;
- Erhaltung und Zugang entsprechen der Projektpolitik.
Für routinemäßige QA bevorzugen Sie Metadaten und Ergebnisse gegenüber erfassten Prompt- oder Quellinhalten. Aktivieren Sie die sensible Erfassung nur für eine genehmigte Untersuchung.
9. Fehler klassifizieren, bevor du es erneut versuchst
Wiederholungen können echte Regressionen verbergen. Trennen Sie Fehler in:
- vorübergehender Serviceausfall: Wiederholungsversuch mit einem kleinen gekappten Backoff;
- Policy Denial: Nicht erneut versuchen; überprüfen Sie, ob die Ablehnung erwartet wurde;
- Client-Parsing oder Rendering-Fehler: Erfassung der rohen Antwort und der Client-Logs;
- Qualitätsfehler: Ausgabe und Bewertungsergebnis zur Überprüfung aufbewahren;
- Testumgebungsfehler: Repariere die Leuchte und führe dann denselben Kandidaten erneut aus.
Immer den ursprünglichen Versuch anhängen und die Historie des erneuten Versuchs anhängen. Ein Versuch nach einem Versuch löscht den ersten Fehlschlag nicht.
10. Definition von Release- und Rollback-Gates
Ein praktisches Tor kann Folgendes erfordern:
- alle deterministischen Vertragsprüfungen bestehen;
- es tritt kein unbefugtes Dateisystem-, Netzwerk-, Zugangs- oder Werkzeugnebeneffekt auf;
- jeder unterstützte Client erfüllt die Kernaufgabe und meldet Fehler klar;
- Die Qualität der Kandidaten liegt nicht unter der vom Projekt genehmigten Bewertungsgrenze;
- Unterbrechungstests erzeugen keine doppelten externen Aktionen;
- erforderliche Beweise sind verfügbar, ohne Geheimnisse preiszugeben;
- Ein menschlicher Gutachter akzeptiert die Proben mit dem höchsten Risiko.
Ein Rollback sollte pro Dimension möglich sein. Setzen Sie eine Modellauswahl zurück, ohne die Sandbox-Politik zu schwächen, setzen Sie eine Client-Integration zurück, ohne Beweise zu löschen, und stellen Sie eine bekannte Policy wieder her, während der fehlgeschlagene Kandidat zur Analyse erhalten bleibt.
11. Wo Automatisierung hilft
Automatisierung ist effektiv für Konfigurationserfassung, Schema-Validierung, Dateisystem- und Netzwerk-Assertions, Diff-Analyse, Testausführung, Duplikaterkennung und Artefaktsammlung. Sie kann auch Baseline- und Kandidatenwerte vergleichen.
Automatisierung sollte nicht entscheiden, ob eine plausible, aber andere Lösung akzeptabel ist, ob eine Erweiterung der Berechtigungen gerechtfertigt ist oder ob gesammelte Telemetrie verhältnismäßig ist. Diese Entscheidungen liegen bei Menschen, die Produktrisiken, Sicherheit und Privatsphäre besitzen.
12. QA-Checkliste
Bestätigen Sie vor der Veröffentlichung:
- die Basis- und Kandidatenkonfigurationen werden aufgezeichnet;
- derselbe feste Aufgabensatz wurde verwendet;
- Eindimensionale Isolationsläufe sind abgeschlossen;
- deterministische und probabilistische Prüfungen sind getrennt;
- Sandbox-Tests verwenden Wegwerfwege, simulierte Wirte und synthetische Geheimnisse;
- Jeder getestete Client hat eine explizite Fähigkeitskarte;
- Unterbrechungstests prüfen auf doppelte Nebenwirkungen;
- Telemetrieerfassung ist minimal und genehmigt;
- Wiederversuchsgeschichte ist sichtbar;
- Rollback-Eigentum wird zugewiesen;
- Die endgültige Entscheidung wird von einem menschlichen Prüfer festgehalten.
Review‑Fragen
- Warum ist eine exakt generierte Antwort ein schwaches Orakel für eine Modelländerung?
- Welche Nebenwirkungen beweisen, dass eine Sandbox-Regel funktioniert hat?
- Wie verbessert ein eindimensionaler Isolationslauf die Wurzelursachenanalyse?
- Welche Beweise werden nach einer unterbrochenen Agenten-Aufgabe benötigt?
- Welche Veröffentlichungsentscheidungen sollten in menschlichem Besitz bleiben?
Fazit
Multidimensionale KI-Veröffentlichungen benötigen mehr als einen einzigen End-to-End-Rauchtest. Eine zuverlässige Strategie friert eine Basislinie ein, ändert jeweils eine Schicht, überprüft deterministische Nebenwirkungen, bewertet probabilistische Qualität mit einer Rubrik und bewahrt Beweise für eine menschliche Veröffentlichungsentscheidung. Das Ergebnis ist ein Regressionsprozess, der eine Modelländerung von einer Sandbox-Ablehnung, einem Kundendefekt oder einer Beobachtbarkeitslücke unterscheiden kann, ohne vorzutäuschen, dass KI-Ergebnisse deterministisch sind.
Quellen
- GitHub Copilot weekly releases — September 21: https://github.blog/changelog/2026-09-25-github-copilot-weekly-releases-september-21
- Supported AI models in GitHub Copilot: https://docs.github.com/en/copilot/reference/ai-models/supported-models
- Configuring local sandbox settings: https://docs.github.com/en/copilot/how-tos/cloud-and-local-sandboxes/configuring-local-sandbox-settings
- OpenTelemetry for agent monitoring: https://docs.github.com/en/copilot/concepts/enterprise/opentelemetry
Kommentar hinterlassen
Teilen Sie Ihre Gedanken zum Artikel. Kein Konto erforderlich.
Kommentare
Kommentare werden geladen…